第 17 章/ 45
时间序列 II:单位根、协整与预测(Time Series II: Unit Roots, Cointegration, and Prediction)
主线:两条序列可以高度同向,却不共享稳定的长期关系;检验、预测与交易是三个不同的问题。 先修:第16章。完成后你能:推导并解释增广 Dickey–Fuller 检验(Augmented Dickey–Fuller test, ADF)回归,区别确定性趋势(deterministic trend)与随机趋势;估计和递归预测二维向量自回归(Vector Autoregression, VAR);正确解释 Granger 预测检验(Granger-causality test);用 Engle–Granger 两步检验(Engle–Granger two-step test)的专用临界值评估协整(cointegration);设计不泄漏未来信息的配对交易(pairs trading)研究。
1. 本章目标
学完后,读者应能从一组带月份标签的序列回答四个不同问题:它是否含单位根(unit root)?两条 I(1) 序列是否存在平稳线性组合?某变量的滞后项是否改善另一个变量的预测?统计关系能否转成时间戳明确、风险和成本可计算的交易规则?这四问有先后联系,却不能互相替代。
本章的计算要求包括:从
2. 为什么 Quant 需要它
第16章先问一条序列的均值、方差和自相关是否能由稳定模型描述。本章把问题扩展到多条长期走势相似的金融序列。若把两条共同上升的指数直接做水平回归,趋势会制造很高的相关和
这里的逻辑链是:先描述趋势来自确定性项还是随机冲击,再检验单位根;若多条变量各自非平稳,再问是否存在平稳组合;对平稳变量或差分变量才按适当形式使用 VAR 与预测检验;最后才把冻结的模型转成滞后执行、计量每条腿风险和成本的研究设计。单位根检验不证明协整,协整检验不证明预测因果,预测关系也不证明交易有正净收益。
3. 直觉
想象两条每月都可能被新冲击推高的行业总回报指数。它们可以因为共有市场冲击而长期同涨同跌;但若两者各自还带有独立的随机累积误差,它们的差仍会越来越漂移。相关系数高,只说明同一段样本内的线性共动强,不说明差会回到某个长期水平。
另一个过程可以写成
3.1 同一窗口的高相关,可以来自两种机制
令
即使每个时点的总体相关很高,差仍积累独立冲击。更一般地,
协整组保留同一个
| 累积差 |
平稳偏离 |
||||
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0.0 | 0.0 |
| 1 | 1 | 0.1 | 1.1 | 0.2 | 2.2 |
| 2 | 3 | 0.2 | 3.2 | −0.1 | 5.9 |
| 3 | 2 | 0.3 | 2.3 | 0.1 | 4.1 |
| 4 | 4 | 0.4 | 4.4 | −0.2 | 7.8 |
| 5 | 6 | 0.5 | 6.5 | 0.0 | 12.0 |
同窗样本相关两组都超过0.99。决定概念差异的是生成机制中误差是否继续累积,不是这六点里哪个相关更大;图17-1的长样本则展示有限样本检验怎样区分两种构造。
4. 数学基础
本章用
对
白噪声(white noise)不自动等于独立同分布;弱平稳(weak stationarity)要求均值、方差恒定且协方差只依赖滞后。单位根过程通常不弱平稳,冲击的累计和会让方差随样本时间改变。统计检验的临界值还取决于回归里的确定性项、变量数、样本和原假设;本章不会把普通 Student-
5. 正式定义
单位根(unit root):若自回归滞后多项式
确定性趋势(deterministic trend):n)、常数(c)、常数和线性趋势(ct)或常数、线性及二次趋势(ctt)。选项表达建模假设,不是供研究者反复搜索小 p 值的旋钮。
增广 Dickey–Fuller 检验(Augmented Dickey–Fuller test, ADF):检验单位根的单序列检验。原假设为水平包含单位根;备择是给定确定项后拒绝单位根。为吸收差分回归残差的序列相关,加入若干滞后差分。统计量的零假设分布非标准,必须按相同确定项对应的 Dickey–Fuller/MacKinnon 临界分布解释。
向量自回归(Vector Autoregression, VAR):
Granger 预测检验(Granger-causality test):在指定样本、滞后阶数和信息集下,检验变量
差分阶数与协整(integration order and cointegration):本章把
Engle–Granger 两步检验(Engle–Granger two-step test):对两个候选 coint 实现这一检验。
误差修正模型(error-correction model, ECM):把短期差分动态与上期长期协整偏离同时放入方程的表示。若变量协整,它说明偏离怎样通过后续变化调整;仅对差分会丢失这项长期信息。本章只在第17-C02讨论其形式,不拟合 ECM。
配对交易(pairs trading):把可能存在稳定价差的两条资产序列组合为多空头寸的策略家族。统计协整只是研究入口。策略仍需在训练样本内估计关系、固定信号规则、将信号时间与可成交时间分开、计算每条腿收益与风险、扣成本并做样本外检验。
6. 推导
6.1 从 AR(1) 到 ADF 系数
从第16章的 AR(1) 写起:
这一步把“水平是否带单位根”转成“水平对下一期变化是否提供均值回复”:单位根原假设
在 ADF 设计中,滞后差分项是为减轻
为什么不查普通 t 表?在
6.2 趋势平稳与差分平稳
若
(假定冲击独立同分布、方差有限)。差分令
一次新冲击怎样进入以后的水平
在随机游走
对趋势平稳例
6.3 为什么残差 ADF 有另一套临界值
设
在“无协整”原假设下,长期系数 coint(y, x),不能把第一阶段残差交给普通 adf_test 后直接按它的 p 值下结论。
预给系数与同样本估计残差:要查哪张表
| 要检验的对象 | 系数从哪里来 | 零假设与参考分布 |
|---|---|---|
| 预先固定 |
与本检验样本无关,且作为固定已知常数 | 对这个给定序列检验单位根;在ADF的误差与确定项条件下用普通ADF分布 |
| 同一训练样本OLS拟合 | 候选 |
|
| 新窗口残差 |
过去训练窗估计,后冻结 | 是关系稳定性诊断;冻结不消除训练参数误差,不能自动宣称普通ADF有限样本校准正确 |
第一行是“给定组合是否有单位根”,第二行是“估计出来的长期关系是否协整”,问题与取样步骤不同。第一行不能先看本样本再声称系数预给,也不能把普通ADF对某个组合的结果等同于完整的联合协整研究。
确定项、滞后和训练窗也进入检验设计。截距描述非零位置,线性趋势描述确定性增长;ADF滞后差分吸收短期相关。滞后过少可能留下误差相关,过多消耗有效观测和检验力。应在训练窗内固定候选上限、准则与残差检查,EG的确定项属于第一阶段长期方程;第二阶段估计残差的检验不能自行换普通ADF口径。若短窗口中
6.4 VAR 与 Granger 检验
对二维 VAR(1),令
在
例如遗漏的发布变量
6.5 从协整关系到可交易价差
若两个正值指数
在概念规则中,若月末已可观察的
6.6 对数系数怎样变成名义金额和股数
| A腿名义 | B腿名义 | 组合含义 | |
|---|---|---|---|
| 多A、空B;毛敞口 |
|||
| 空A、多B | |||
| 两腿同为多头 | |||
| 两腿同为空头 |
一般协整不要求
手算例:
固定初始名义不是每期自动维持相同名义:持仓后价格漂移,需要调仓才恢复目标比例,调仓又有成本。若
7. 金融解释
单位根代表水平中的冲击可能持续影响估值或累计财富,影响风险区间、长期回归和预测不确定性。趋势平稳过程受到冲击后倾向回归趋势;随机趋势过程的路径会随每次冲击永久改道。两种经济机制会导向不同的模型和对冲期限。
协整关系可被理解为经验上不随时间发散的线性误差,但其来源可能是现金流、共同贴现率、政策、行业结构或指数构造。结构变化、并购/行业重分类、危机制度转换都可能打破关系。Granger 预测检验只能说明指定预测系统里,历史
配对研究把可能的长期约束变为一个信号,但不能把“协整”直接等同“价差会在我的持有期内回归”。短期流动性风险、借券召回、融资和交易冲击可以在统计回归之前触发亏损。月度行业组合收益形成的累计指数又不是任何投资者可直接成交的两只股票。本章真实数据例只做统计描述,不报告策略收益。
8. 数值例:逐步看清每一步
8.1 手算 ADF 系数
设
所以
8.2 Engle–Granger 第一阶段 OLS 的手算
8.3 二维 VAR 两期预测
8.4 一次收益区间和两条腿
9. Python Implementation
本读者版的默认运行入口
从接受I3读者包根目录,按其环境说明建立独立环境后运行:
.venv/bin/python run_notebook.py notebooks/ch17_time_series_ii.ipynb
默认以种子20261017/20261018各构造900个月。非协整模拟的共同创新标准差1、独立创新标准差0.2,与§3.1手算方差9/0.25/0.25是两个不同输入的教学对象。协整构造beta=1.4、价差AR系数0.65、创新标准差0.35、截距0.25,初始价差按稳态分布初始化。已知价差用普通ADF;同窗估计关系用EG专用校准。二维VAR另用种子1704构造1990-01起120行,前100月截至1998-04训练,预测1998-05和1998-06;生成系数A=[[0.35,0.12],[0.05,0.30]]、c=[0.25,−0.10],创新标准差0.10。此Notebook不运行Granger检验。
Notebook显示fixtures/figures/a4/ch17_cointegration_simulation.png随包既有图;显示不等于本次重新生成。RUN_FRENCH=False关闭历史市场分支。虽然创建并打印runs/ch17_time_series_ii_<uuid>/,本Notebook不向它写CSV或PNG。运行器另在唯一runs/execution_*目录保存执行副本与状态;两个目录用途不同。构造计算不形成市场预测或策略净收益证据;第10–11节的French历史图表与数字保留原有身份。
下方CLI与制作测试属于历史课程工作根流程,不是本包默认路线;未随包提供的制作测试不要求读者补回。I3 CLI第16章仍无条件读取French,CLI第17章历史分支需--french-data,均不替代上述默认命令。
历史课程工作根与原实现
本章核心位于 cointegration.py,复用第16章的 validate_monthly_series,另外严格验证多列月度表。它要求升序、唯一、连续的 PeriodIndex(freq="M"),把数值转换为有限 float64;缺月、NaN、无穷、布尔和复数均报错,不自动填补。接口如下:
| 函数 | 输入 | 输出与边界 |
|---|---|---|
adf_test |
单条完整月频序列;regression 确定项与可选滞后规格 |
ADF 统计量、近似 p 值、使用滞后、样本数、对应临界值 |
engle_granger_test |
同月对齐、至少 24 个观测的两条序列;可选趋势和滞后规格 | Engle–Granger 统计量、专用 p 值和临界值 |
| 共同趋势非协整模拟 | 长度 n 与 seed |
共享随机趋势叠加两条独立随机游走 |
simulate_cointegrated_pair |
seed、非零有限实数 beta 与 $ |
\phi |
fit_var_forecast |
训练面板 training、固定滞后 lags、预测步数 steps |
按未来月份标记的递归预测;平稳性仍需研究者验证 |
granger_test |
有名、同月对齐的 caused 与 causing 序列;最大滞后 max_lag |
明确方向的联合 F 统计量和 p 值 |
screen_cointegration_pairs |
多列水平表 levels、训练截止月 training_end |
截止月前所有无序列对的 Engle–Granger p 值与 BH 调整 p 值(常称 q 值);作为探索性 FDR 调整,不读取截止月后的数值估计 |
total_return_index_proxy |
小数月简单收益 returns |
由 100 起算的累计总回报指数(total-return index, TR index)教学代理 |
运行复现实验、图和样本统计:
.venv/bin/python code/ch17_time_series_ii.py
.venv/bin/python -m pytest tests/test_ch17_cointegration.py -q
脚本中的两条模拟种子固定为 20261017 和 20261018;不按收益或 p 值筛 seed。Engle–Granger 包装器明确调用 statsmodels 0.15.0 的 coint,不从普通 ADF 包装器拼接错误临界值;完全或近乎完全共线的输入会被拒绝。对 trend="n",若 statsmodels 返回的临界值为 NaN,接口保留该缺失值,但仍单独检查检验统计量与 p 值有限。所有实证预测/筛查仅传入训练段。月度数据只按月标签处理,不把月长伪装成等秒日频。Notebook 只调用核心模块,不复制统计实现。
10. Visualization
图 17-1:共同随机趋势和协整组合的模拟对照。 两列分别是 seed 20261017 的非协整共同趋势构造和 seed 20261018 的
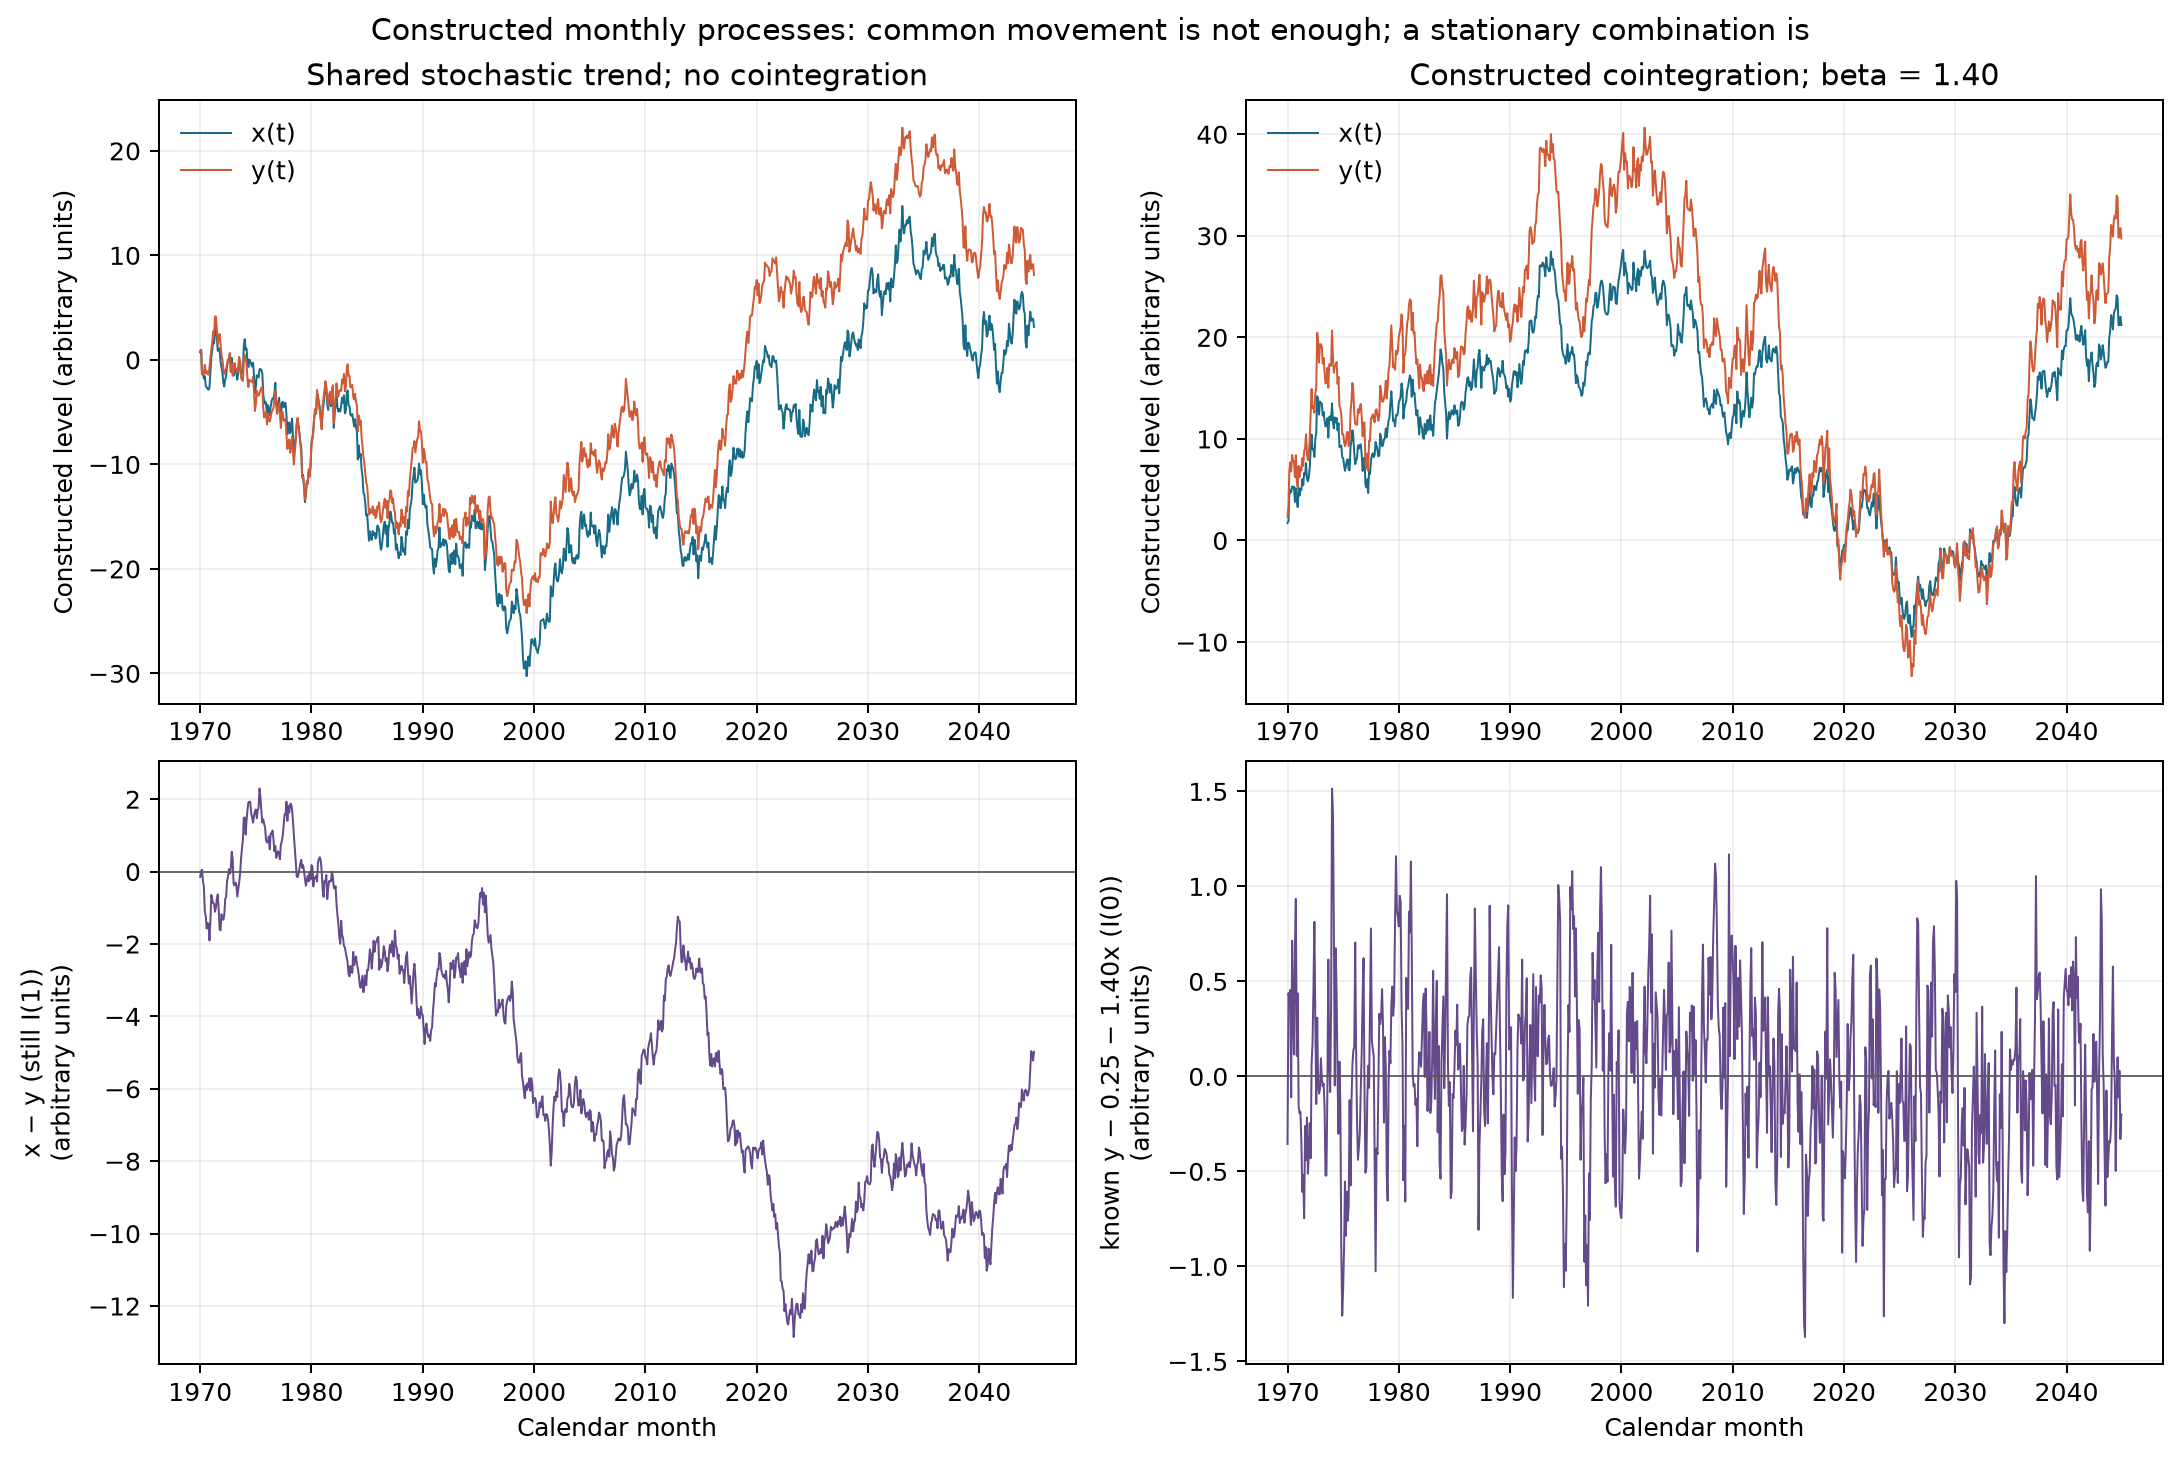
图 17-2:French 10 行业月收益累计指数代理。 横轴为收益所属月份,纵轴为先把 10 个行业发布月收益按
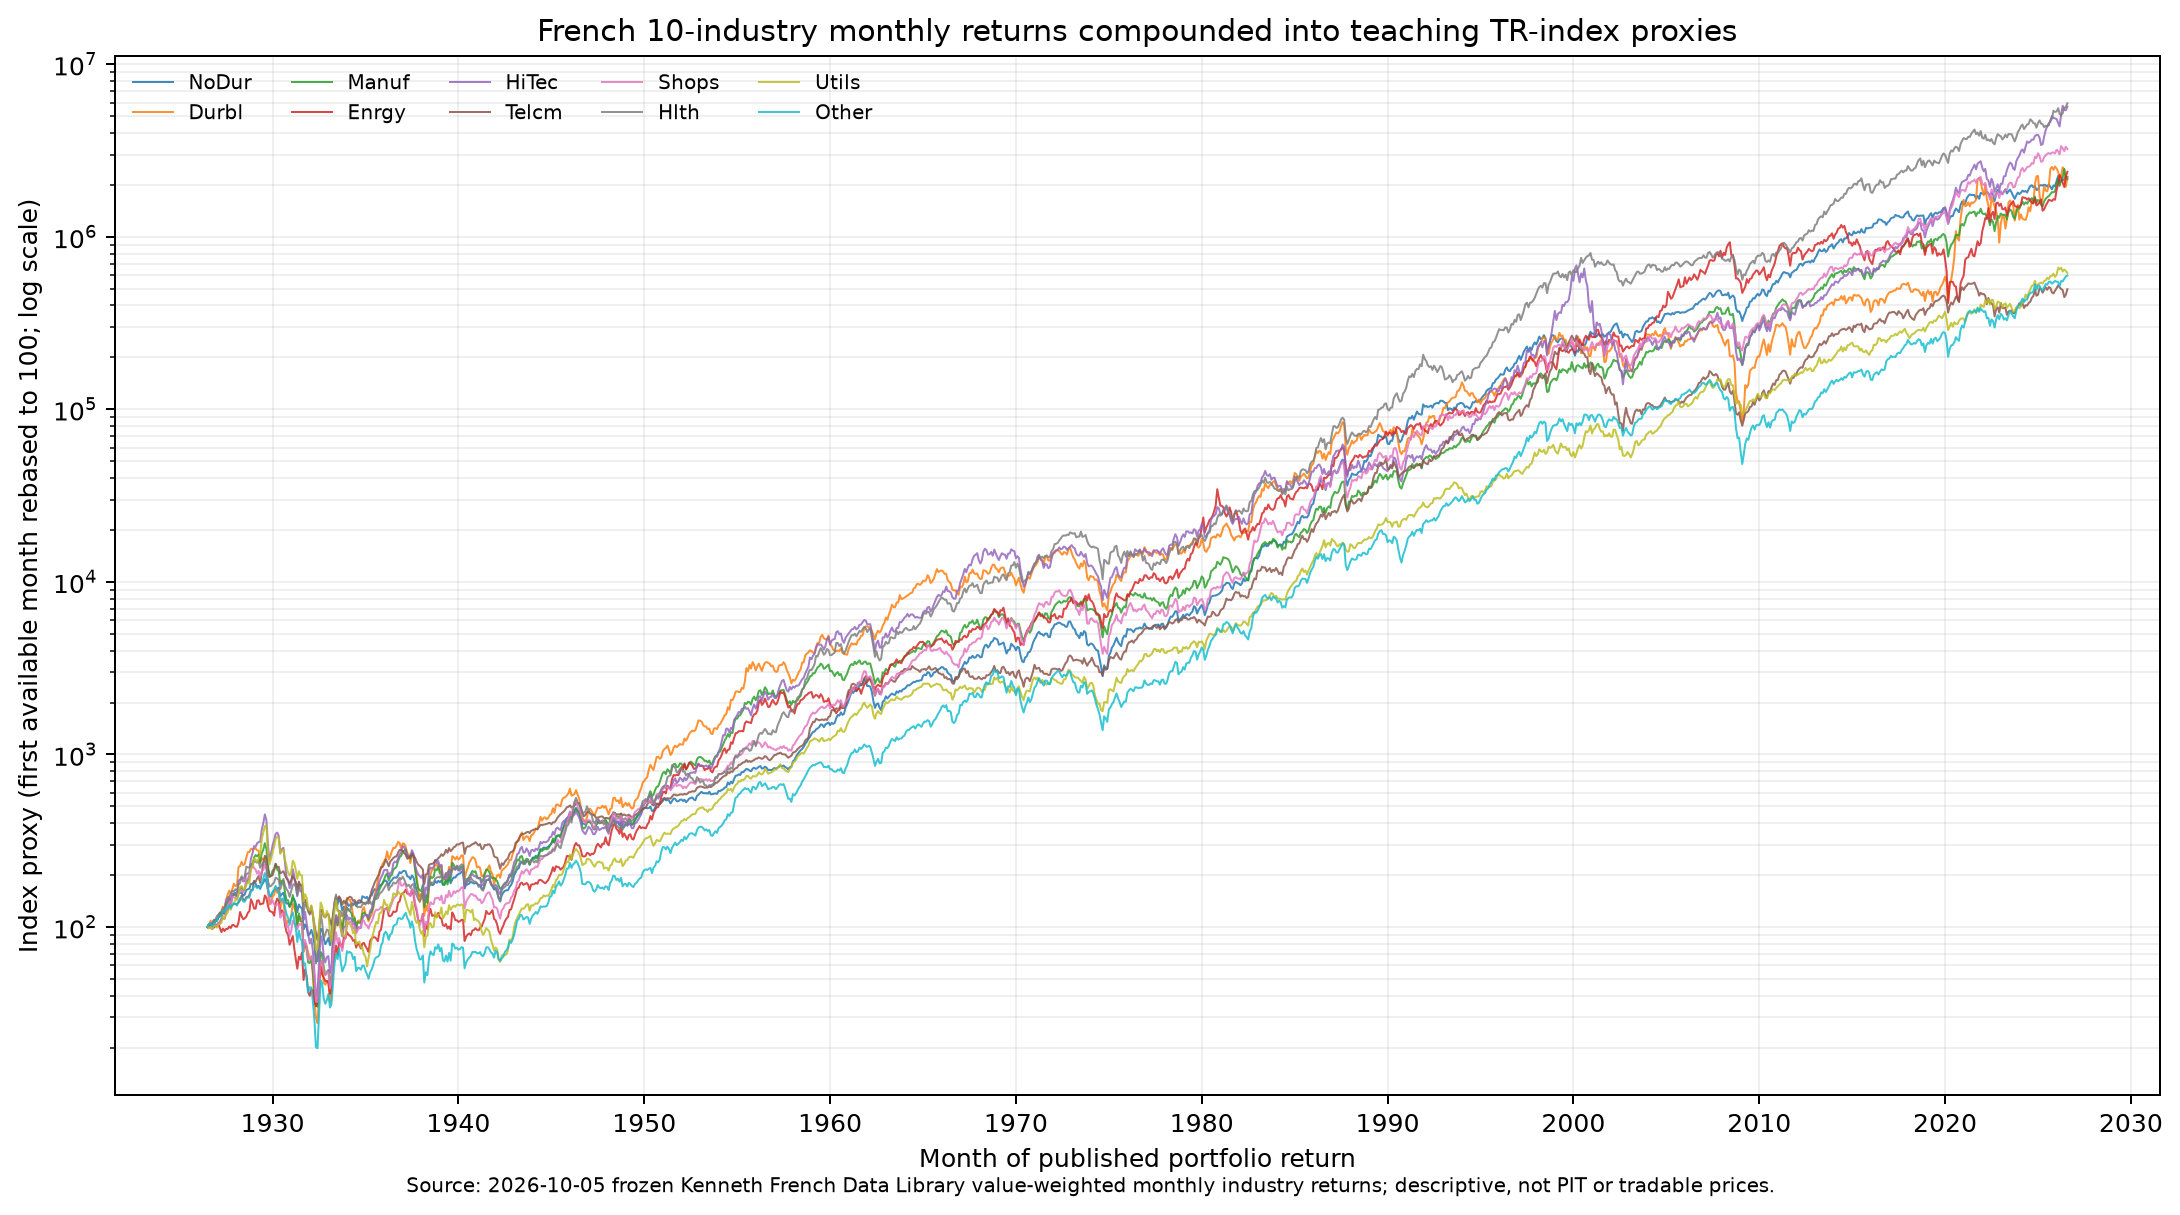
两幅 PNG 由 code/ch17_time_series_ii.py 实际生成。代码读取固定哈希的本地 French CSV,并验证图例、周期与数据范围;它们不是手绘示意图。
11. Real Market Example
本章沿用 Kenneth R. French Data Library 的 10 Industry Portfolios 当前缓存:2026-10-05 下载的 ZIP,选择 Average Value Weighted Returns -- Monthly 月区块,源单位百分比除以 100。原始 ZIP SHA-256 为 ebd937a4b995d821867aeb956a96f09a666386f38fa82516b7d1767ee4a49ae5;处理后 CSV SHA-256 为 3b097d810c295d64eedfa1ece7067ff2a0707f5ca90e33935df9949251f70950;缓存 1,202 个月,1926-07—2026-08。来源转换细节见 source_notes.md 与 数据清单。公开可下载不等于可任意再分发许可。
把每个行业已发布的小数简单收益复利成教学用 TR Index proxy,在 1926-07 至 2000-12 训练区间对全部
这 10 列是行业组合回报,不是 10 只股票;累计值是为本章建模用而构造的指数代理,不是一个实际基金的可成交复权价格,也不是点时(point-in-time, PIT)数据。当前发布版本覆盖至 2026-08,不能重建 1926 年各月当时投资者实际看见的数据版本。本章不声称历史信号有效,不报告策略 Sharpe 或收益。
12. Common Mistakes
错误一:水平相关 0.95,所以两条序列可配对。 共同随机趋势足以造成高相关,须检验线性组合是否平稳。下面输出约为 0.9552 和 0.457541;相关不是协整检验。
from quant_course.cointegration import simulate_noncointegrated_common_trend, engle_granger_test
pair = simulate_noncointegrated_common_trend(n=900, seed=20261017)
test = engle_granger_test(pair["x"], pair["y"])
print(pair["x"].corr(pair["y"]), test.pvalue)
错误二:对第一阶段 OLS 残差跑普通 ADF,并按普通 p 值宣布协整。 残差使用同一段 I(1) 数据估计,零假设分布不同。固定模拟中普通 ADF coint。
import numpy as np
import statsmodels.api as sm
from statsmodels.tsa.stattools import adfuller
from quant_course.cointegration import simulate_noncointegrated_common_trend, engle_granger_test
pair = simulate_noncointegrated_common_trend(n=900, seed=20261017)
design = sm.add_constant(pair["y"].to_numpy())
residual = pair["x"].to_numpy() - design @ sm.OLS(pair["x"].to_numpy(), design).fit().params
ordinary = adfuller(residual, regression="c", autolag="AIC", result_object=True)
correct = engle_granger_test(pair["x"], pair["y"])
print(ordinary.pvalue, correct.pvalue)  # 约 0.23056 与 0.45754
错误三:Granger 显著,所以 x 结构性导致 y。 反向列顺序会换成另一个预测问题;结果只谈指定样本与滞后下的增量预测信息。函数参数将方向写明,并以已知生成方向做校验:
import numpy as np
import pandas as pd
from quant_course.cointegration import granger_test
rng = np.random.default_rng(23)
x = rng.normal(size=1000)
y = np.zeros(1000)
for t in range(1, len(y)):
    y[t] = 0.75 * x[t - 1] + rng.normal(scale=0.5)
index = pd.period_range("1950-01", periods=len(y), freq="M", name="month")
x_series = pd.Series(x, index=index, name="x")
y_series = pd.Series(y, index=index, name="y")
print(granger_test(caused=y_series, causing=x_series, max_lag=1).pvalue)
print(granger_test(caused=x_series, causing=y_series, max_lag=1).pvalue)
错误四:全样本估计关系,再把旧 z-score 当实时信号。 未来样本改变估计的截距和斜率。应先切分并只用训练期估计;本章的 screen_cointegration_pairs 只接收 training_end 前缀,测试将未来观测改动后验证筛查结果不变。真实下单还需记录数据的可用时间。
import numpy as np
import pandas as pd
from quant_course.cointegration import simulate_cointegrated_pair
pair = simulate_cointegrated_pair(n=900, seed=20261018)
train = pair.loc[:pd.Period("2000-12", freq="M")]
design = np.column_stack([np.ones(len(train)), train["x"]])
alpha_hat, beta_hat = np.linalg.lstsq(design, train["y"], rcond=None)[0]
spread_train = train["y"] - alpha_hat - beta_hat * train["x"]
print(len(train), alpha_hat, beta_hat, spread_train.std(ddof=1))
错误五:dropna() 后默认相邻行仍相隔一个月。 缺失月被删掉后会把跨月差误当成一期变化。下面展示核心接口拒绝这种压缩;应追查来源或设计明确的缺测模型,不在检验函数里补值。
import numpy as np
import pandas as pd
from quant_course.cointegration import validate_monthly_frame
index = pd.period_range("2000-01", periods=4, freq="M", name="month")
series = pd.Series([0.01, np.nan, 0.02, 0.03], index=index, name="return")
try:
    validate_monthly_frame(series.dropna().to_frame())
except ValueError as error:
    print(type(error).__name__, error)
13. Quant Research Application
一个可信的配对研究至少按以下顺序形成可审计链条。
- 写假设与否证条件。 例如“预先选定的两个资产在指定制度下均为 I(1),对数价差在多个训练/验证窗口均平稳,并且信号收益覆盖全成本”。可能的反证包括差分阶数不符、残差单位根不拒绝、关系在制度切换后漂移、样本外无均值回复,或成本后不优于朴素基准。
- 锁定数据和时钟。 保存原文件哈希、单位、公司行动、价格/收益定义和
available_at。本章行业缓存只支持当前版本的月度组合收益描述;不足以给策略历史信号打 PIT 时间戳。 - 按时间切分。 在训练区间内单独核对两条序列的阶数、设定确定项、估计长期系数、检验特殊 EG 统计量并控制 45 对等家族的多重比较。若要做组合筛选,预先写明候选集合和修正方法;不要看验证期再换对象。
- 冻结信号和头寸。 在训练内固定
、价差归一化参数、入场/退出/停损、重估频率、两腿美元名义或风险预算。协整回归的 不等同于风险中性权重,需定义每腿目标波动、总毛敞口和单腿限额。 - 逐条腿对齐收益区间。 若用月末 t 收盘后可得信号,不能再按整个月 t 的收益记账;应把首次可成交时间放在 t 后的下一个可交易时间,并用两腿相同的成交起止时刻计量下一持有区间回报。月度 French 发布收益无法还原此执行区间,因此本章不计算回测损益。
- 扣每条腿成本并比较基准。 记录两侧佣金、点差和冲击、借券可得率与费率、融资、再平衡换手、停牌/退市、股息和税务;与零交易、朴素持有/对冲基准比较。策略验证还需按时间滚动或扩展窗口、记录每次可用训练前缀与下一期目标,报告区间不确定性及危机压力。
- 做稳定性和失效审计。 检查残差 ACF/结构突变、窗口内
漂移、行业定义变化、危机下价差尾部和借券召回。对训练中筛出的多对,修正 p 值不能替代独立样本外验证。
这是一份研究设计,不是 Project 5 完成记录。本章没有逐时点数据、执行价、借券记录和净值序列,不能宣称一项配对策略通过了样本外和成本检验。
Project5:把统计训练输出接到执行接口
Project5当前接受入口为 projects/project05/ACCEPTED_VERSION.md,主规格是预注册v2;其接受的是实现和构造教学验证,真实价格实证仍blocked。训练输出至少区分长期回归的截距/斜率、EG筛选结果、训练价差均值/标准差和后续执行规则。后续每个时点应用这些冻结输出,不能用整段未来价差重新归一化;若训练窗口变化,按预先规定的重估时点生成下一组关系,而不是用未来拟合覆盖历史。
两章的接口分工是:第16章说明时间索引、有效观测数与条件预测,第17章说明筛选关系和持仓对象;Project5再按它的日频交易时钟、成本模型和episode定义计算。EG通过且
14. Chapter Summary
先用包含相应确定项的 ADF 问序列是否拒绝单位根,再考虑多条 I(1) 变量是否存在平稳线性组合。普通 ADF 与估计残差的 Engle–Granger 检验有不同的零分布;后者应使用协整专用临界值。VAR 把多个变量滞后联结成条件预测,Granger 联合检验只针对指定信息集里的增量预测力。协整、预测和结构因果各自回答不同问题,任何一种都不等于交易可行。
配对应用的关键转折是从样本内的长期误差切到实时可执行规则:只用过去数据估系数,只在信号可得后下单,统一定义两腿收益区间,并把风险和成本带入验证。模拟帮助读者认识机制;当前 French 行业缓存帮助核对真实发布收益的复利和筛查数量,但不支持历史实时交易结论。
15. Exercises
请先独立作答。答案与推导在第18节。
- 17-E01(概念):两条随机游走的样本相关为 0.97,是否足以判为协整?指出还缺少什么检验条件。
- 17-E02(单位根):若 ADF 回归中
,能否单看符号拒绝单位根?解释所需统计量和规格。 - 17-E03(趋势):区分
( )与 中冲击的持续性。 - 17-E04(EG 临界值):为什么对第一阶段 OLS 残差使用普通
adfuller临界值会错? - 17-E05(因果措辞):在
grangercausalitytests([y,x])中显著结果检验什么?它不支持哪种更强主张? - 17-E06(模型选择):把 ADF 从
c、ct、ctt三种规格全跑一遍,只汇报最小 p 值有什么问题? - 17-E07(多重比较):对 45 个配对各跑一次 5% 检验,为什么 22 个名义显著结果不能当成 22 个已验证的长期关系?
- 17-E08(时间):月末 t 的信号使用了该月完整收益;若按 t 月整月收益计算这笔信号的盈亏,错在哪里?
16. Programming Exercises
- 17-P01(模拟与检验):固定种子生成 900 个月的共同趋势非协整样本和协整样本;输出水平相关与
engle_granger_test的 p 值。验收:同一 seed 可复现;前者相关大于 0.9 且不在 5% 拒绝无协整原假设,后者在 1% 拒绝;结果必须标成模拟。 - 17-P02(VAR 时间边界):构造两维平稳月序列,只用前 80 个月拟合 VAR(1),预测两个月。将后 20 个月改成任意大值后,前 80 个月模型输入及预测必须不变;输出列序、预测月份和单位须明确。
- 17-P03(多对筛选):加载 French 10 行业缓存,复利出 10 条 TRI proxy,只用 2000-12 及以前对 45 对执行 EG 检验,输出 p 与 BH q。把 cutoff 后观测整体加常数后,训练期结果须不变;禁止按回测收益选 pair。
- 17-P04(Granger 方向):生成
白噪声、 ,分别测 与 。检查列顺序和含义,不能写成结构因果结论。
17. Challenge Problems
- 17-C01(多重检验和筛选偏差):说明在 10 个序列的 45 个配对中挑出最小 p 值关系,会怎样扭曲显著性;提出一种在每个滚动训练窗口可复现、样本外不回头改选对象的验证方案。额外先修:多重比较与时间序列交叉验证。评分 10 分:45 对全量记录 2 分;训练内选择 2 分;校正/置换或家族定义 2 分;独立后续窗口 2 分;否证条件 2 分。
- 17-C02(误差修正):从两个 I(1) 序列的协整误差
出发,写一个带滞后差分的 方程并解释调整系数。指出普通差分 VAR 与 VECM 的长期信息差异,以及结构变化如何使误差修正项失效。额外先修:线性回归与 VAR。评分 10 分:写出滞后差分与误差项 3 分;调整方向解释 2 分;长期/短期项区分 2 分;给出结构变化反例 2 分;说明本章并未估该模型 1 分。
补充练习(独立编号)
- 17-N01(机制与手算;§3.1、§6.2):共同随机游走创新方差9、各独立趋势创新方差0.25。求同一
的两水平相关和 方差,证明任意 不能消除全部趋势。若固定起点100,创新2、−1、3,第一冲击多1后水平怎样改变? - 17-N02(检验诊断;§6.3):分别给预先固定组合、同样本OLS残差、冻结训练系数的新窗残差选择检验解释。为什么
的短窗ADF不拒绝不能证明单位根?说明确定项/滞后的选择时点。 - 17-N03(两腿账本与判断;§6.6):
,A/B成交价20/50、退出价20.6/50.5。求股数、毛敞口、净名义、价格损益;开平各按每腿实际成交名义收10bp,求净损益(无股息、借券、融资)。若 ,做多价差是什么方向?若 且朝零取整,实际对冲比是多少?说明Project5排除负beta的含义。
18. Solutions / Solution Hints
Exercises
- 17-E01:不足。高相关可由共同随机趋势导致而不存在平稳线性组合。本例应先按适当规格评估各序列是否为同阶 I(1),再用 Engle–Granger 等协整专用程序检验组合;样本相关不提供临界值,也不说明关系未来稳定。
- 17-E02:不能。统计量通常是针对
的 ADF t 型统计量,其有限样本参照是非标准 Dickey–Fuller 分布;还需确定性项( n/c/ct/ctt)、滞后选取和相应临界值。只知道斜率为负不够。 - 17-E03:第一式中,
按本章定义只给出弱平稳短记忆性质;仅凭这几个矩条件,不能推出完整分布固定或单次冲击响应消失。若再具体假设 ,一个单位创新在第 期使偏离项增加 ,所以其影响衰减,而趋势 不被永久改写。第二式含 单位根, 期创新以系数 1 保留在其后每个水平中,方差在独立同分布、有限方差创新下随 增长。两个式子的 0.4 分别是确定性斜率和每期漂移;第一式的“冲击暂时”依赖额外的稳定因果假设,不是弱平稳的定义本身自动给出的结论。 - 17-E04:第一阶段从同一组非平稳水平中估了长期系数,让残差平方和尽可能小;无协整时系数在原假设下没有稳定真实的长期参数,估计残差单位根统计量的零分布不同于预先给定序列的单变量 ADF。用
coint返回的专用临界值。 - 17-E05:statsmodels 将第二列
作为原因变量、第一列 作为被解释序列,检验 方程中指定滞后 系数联合为零。拒绝表示该样本、滞后、控制变量下的增量线性预测信息;不能据此声称干预 会造成 改变。 - 17-E06:反复选择最小 p 值等于把规格选择也纳入隐含多重搜索,名义 p 值不再有原先的检验含义;确定项应由数据生成假设预设,并报告敏感性而非只报最显著版本。
- 17-E07:45 次检验会产生假阳性;配对之间共享行业序列,检验结果也相关。22 个名义显著数只能描述这组探索检验。BH 调整针对 FDR,理论保证需要独立或合适的 PRDS 正依赖等条件;此处共享序列造成的依赖条件未验证,所以 15 个 BH q<0.05 是调整结果,不能声称 FDR 已被保证,也不能把它说成 FWER 控制。还需独立后续窗口检验;任何校正都不能保证关系稳定或可交易。
- 17-E08:信号需要等该月收益完整形成并可得时才存在,再按同一月的起止收益记账会用形成信号之前的路径获利,时间顺序倒置。应设下一个可执行时点,按两腿从成交后至下一结算时点的共同区间计收益;月度组合文件并未提供该细粒度数据。
Programming Exercises
- 17-P01:可直接运行本章核心接口:
from quant_course.cointegration import (
    engle_granger_test, simulate_cointegrated_pair,
    simulate_noncointegrated_common_trend,
)
noncointegrated = simulate_noncointegrated_common_trend(n=900, seed=20261017)
cointegrated = simulate_cointegrated_pair(n=900, seed=20261018)
a = engle_granger_test(noncointegrated["x"], noncointegrated["y"])
b = engle_granger_test(cointegrated["y"], cointegrated["x"])
assert noncointegrated["x"].corr(noncointegrated["y"]) > .9
assert a.pvalue > .05 and b.pvalue < .01
print(a.pvalue, b.pvalue)  # 约 0.457541 和 8.69312e-26
- 17-P02:以下代码可独立运行,先造出平稳二维 VAR(1),只把前 80 个月传入拟合/预测;再把原始面板的后 20 个月改成大值,并以同一训练前缀重算。两次预测必须逐项相同,月份紧接训练截止月,列顺序不变。
import numpy as np
import pandas as pd
from pandas.testing import assert_frame_equal
from quant_course.cointegration import fit_var_forecast

rng = np.random.default_rng(29)
values = np.zeros((100, 2))
for t in range(1, 100):
    values[t] = np.array([0.25, -0.10]) + np.array(
        [[0.35, 0.12], [0.05, 0.30]]
    ) @ values[t - 1] + rng.normal(0.0, 0.1, size=2)
index = pd.period_range("2000-01", periods=100, freq="M", name="month")
panel = pd.DataFrame(values, index=index, columns=["A", "B"])
training = panel.iloc[:80].copy()
forecast = fit_var_forecast(training, lags=1, steps=2)

changed = panel.copy()
changed.iloc[80:] += 500.0
forecast_again = fit_var_forecast(changed.iloc[:80], lags=1, steps=2)
assert_frame_equal(forecast, forecast_again)
assert forecast.index.tolist() == [training.index[-1] + 1, training.index[-1] + 2]
assert forecast.columns.tolist() == ["A", "B"]
print(forecast)
- 17-P03:参考实现位于
code/ch17_time_series_ii.py的main():哈希验证冻结 CSV、将百分数已经除过 100 的缓存月收益复利、训练截止设成 2000-12、遍历 45 个无序配对并计算 BH 调整 p 值,打印所有配对的未校正 p 与 BH 调整值。核心screen_cointegration_pairs只切training_end前缀;测试把截止后数据整体加 10,000,结果逐字段保持相同。复现统计是名义显著 22/45、BH 调整 p<0.05 为 15/45;BH 的 FDR 控制条件在该共享序列家族中未验证,结果不代表 15 个可交易关系。 - 17-P04:以下代码可独立运行。过程让
为白噪声、 ;同一月对齐后分别检验预测方向,并断言正确方向强显著、反方向不显著。拒绝零假设只表示给定模型和样本下有增量预测信息,不构成结构因果结论。
import numpy as np
import pandas as pd
from quant_course.cointegration import granger_test

rng = np.random.default_rng(23)
n = 1000
x = rng.normal(size=n)
y = np.zeros(n)
for t in range(1, n):
    y[t] = 0.75 * x[t - 1] + rng.normal(scale=0.5)
index = pd.period_range("1950-01", periods=n, freq="M", name="month")
x_series = pd.Series(x, index=index, name="x")
y_series = pd.Series(y, index=index, name="y")

x_predicts_y = granger_test(caused=y_series, causing=x_series, max_lag=1)
y_predicts_x = granger_test(caused=x_series, causing=y_series, max_lag=1)
assert x_predicts_y.pvalue < 1e-8
assert y_predicts_x.pvalue > 0.05
print("x -> y p-value:", x_predicts_y.pvalue)
print("y -> x p-value:", y_predicts_x.pvalue)
Challenge Problems
-
17-C01 参考论证:在每个外层训练窗里先冻结 10 个列名、45 对集合、确定项、ADF 滞后规则和多重比较方法(例如按训练窗对 p 值做 BH,同时报告未校正的全量分布);可用内层时间序列滚动窗比较候选,但每个外层测试窗只评估在其起点以前选出的单一冻结模型。外层期不重选 pair、不回算训练系数;下一期滚动重训时明确记下新旧对象。保留失败关系,报告关系符号与半衰期漂移、样本外价差 ACF、两腿成本后收益和置信区间。若关系只在某个制度、某一极短窗口或成本前存在,研究假设被否证。按题面 5 项评分。
-
17-C02 参考形式:
括号项是上期长期误差;若
高于长期组合且 ,调整项会压低下一期 ,但平稳性、符号和参数稳定都需实证确认。差分 VAR 保留短期差分动态却丢掉水平误差,VECM 将协整误差重新放回;若制度变化令旧 不再平衡,调整项会误导方向。题面要求的是形式与研究边界,本章核心代码没有估 VECM。按评分标准逐项给分。
补充练习答案
17-N01。 水平相关为
17-N02。 预先给定固定组合可在单序列ADF条件下用普通ADF参考;同窗OLS残差要用EG无协整专用分布。训练系数冻结后的新窗残差是稳定性诊断,训练误差仍在,不自动获得普通ADF精确校准。
17-N03。
19. Further Reading
- Must Know:Dickey & Fuller (1979), pp. 427–431,重点读 §1–2,理解单位根下估计量分布与确定项规格;本章来源笔记标注其实际读取页。
- Must Know:Engle & Granger (1987), pp. 251–255 与 260–269,读协整/误差修正定义、两步估计及“残差检验不能使用普通 DF 临界值”的说明。
- Must Know:MacKinnon (2010), §§1–3 与 2010 Appendix,读不同回归维数、趋势项和样本的协整检验临界值如何校准。
- Must Know:Benjamini & Hochberg (1995), pp. 289–300,重点读 FDR 定义及独立检验下 BH step-up 程序;Benjamini & Yekutieli (2001), pp. 1165–1188,了解正回归依赖于子集(positive regression dependence on a subset, PRDS)下的扩展,并注意共享行业配对不能未经证明就当作满足条件。
- Should Know:Granger (1969), §§4–5,阅读预测意义下“因果”定义和二变量模型,同时留意作者对遗漏变量、样本频率与非平稳的限制。
- Should Know:statsmodels 0.15.0 官方
adfuller、coint、VAR 与grangercausalitytests文档,核对代码 API 与返回方向;软件文档是实现说明,不代替理论原文。 - Advanced:Said & Dickey (1984), Biometrika 71(3), 599–607,关于未知 ARMA 阶数时单位根检验的渐近理论。此次只核到 OUP 书目信息与摘要,未读全文,见来源笔记。
20. References
- Dickey, D. A., & Fuller, W. A. (1979). “Distribution of the Estimators for Autoregressive Time Series with a Unit Root.” Journal of the American Statistical Association, 74(366), 427–431. DOI。支持 §6.1 单位根原假设下的非标准分布。
- Engle, R. F., & Granger, C. W. J. (1987). “Co-Integration and Error Correction: Representation, Estimation, and Testing.” Econometrica, 55(2), 251–276. 官方文章页与摘要。支持 §§5、6.3 的两步估计和协整残差检验。
- Granger, C. W. J. (1969). “Investigating Causal Relations by Econometric Models and Cross-Spectral Methods.” Econometrica, 37(3), 424–438. DOI。支持 §§5、6.4 的预测因果定义与限制。
- MacKinnon, J. G. (2010). “Critical Values for Cointegration Tests.” Queen’s Economics Department Working Paper No. 1227. PDF。支持 §6.3 的协整临界值校准。
- Benjamini, Y., & Hochberg, Y. (1995). “Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing.” Journal of the Royal Statistical Society: Series B, 57(1), 289–300. DOI。引入并讨论错误发现率,BH 方法在独立检验假设下控制 FDR;不是家族错误率控制方法。
- Benjamini, Y., & Yekutieli, D. (2001). “The Control of the False Discovery Rate in Multiple Testing under Dependency.” The Annals of Statistics, 29(4), 1165–1188. DOI。讨论 BH 在正回归依赖(PRDS)条件下的 FDR 控制;不能由“检验相关”本身推出这些条件成立。
- Statsmodels 0.15.0 官方文档:ADF、Engle–Granger
coint、VAR、Granger 检验。仅支持代码行为。 - Kenneth R. French Data Library. 10 Industry Portfolios。支持 §11 行业月收益来源与数据区块定位;缓存修订、哈希和使用限制见
source_notes.md。