第 22 章/ 45
量化研究方法论(Quant Research Methodology)
主线:研究者在看到最终测试结果之前冻结假设、样本、评价方法,并记录每一次尝试;否则所有“显著”的数字都不能回答“这是真实规律还是搜索出来的噪声”。 先修:第3章(数据时点与清单)、第7章(均值推断与 Bootstrap)、第11章(收益复利)、第15章(回归与 HAC)、第21章(组合构造与换手)。完成后你能:写出一份含十个环节的冻结研究计划并给出哈希;维护试验账本(trial ledger);手算 Bonferroni、Holm、Benjamini–Hochberg 调整;推出
个零假设试验取最大值时的期望膨胀;区分“先写计划”和“事后挖掘”并说明本地哈希为什么证明不了先后;在真实 French 行业数据上完成一次含负结果的留出评价。
1. 本章目标
本章回答第22–28章共用的一个问题:当你声称“这个信号有效”时,别人凭什么相信你没有在二十个版本里挑了最好的那一个。
完成本章后,读者应能做到下列五件事:
- 把“经济假设 → 数据 → 清洗 → 特征 → 信号 → 组合 → 回测 → 验证 → 成本模型 → 样本外”十个环节各自的输入、输出、留痕和典型失败写成一张表,并说明每个环节与第3、7、11、15、21章的接口。
- 写一份冻结研究计划(research plan):假设与符号方向、样本窗口、唯一的主指标、通过与失败的数值判据、成本假设、尝试预算;计算它的 SHA-256;说明这个哈希证明了什么、没有证明什么。
- 维护试验账本:每个被评价过的变体都记录规格、指标、样本量和状态,包括已放弃的和未定义的结果。
- 手算并解释
、Bonferroni、Holm、Benjamini–Hochberg;写出 个独立标准正态变量最大值的期望并核对近似式;知道为什么相关的变体不等于独立的试验。 - 读懂一次完整的“发现—留出”评价,包括真实数据上不通过判据的结果,并按预先写好的规则写结论。
“完成”的标准不是得到小 p 值,而是任何一位读者仅凭你的计划文件、账本、代码与数据哈希,就能复算你报告的每一个数,并看到你尝试过的全部变体。
2. 为什么 Quant 需要它
第14–21章给了你测量工具:回归与 HAC 标准误(第15章)、单位根与协整(第17章)、组合构造与成本(第21章)。Part IV 开始进入“系统化 alpha 研究”,也就是同一份历史数据要被反复用来检验许多种信号。工具变多以后,错误的方式也变多了:你可以换回看窗口、换去极值水平、换分组数、换样本起点、换标签期限,每换一次就得到一个新的 t 统计量。
两类事实说明这不是理论上的担忧。其一,Harvey、Liu 与 Zhu 在 2014 年的 NBER 工作稿摘要中写道:数百篇论文和数百个因子试图解释股票预期收益的横截面,鉴于这种广泛的数据挖掘,对新发现的因子继续用 t 比率大于 2.0 的通常标准“在经济上和统计上都说不通”;他们的多重检验框架建议新因子的 t 比率应大于 3.0(对应 p 值 0.27%),并指出真实尝试次数还包括从未发表的失败尝试,所以 3.0 很可能还偏低。其二,Gelman 与 Loken(2013 年未发表稿)指出:即便研究者只做了一次分析、事先持有研究假设,只要分析细节(剔除哪些观测、测哪个对比、控制哪些变量)依赖于数据长什么样,就存在“分岔路径”(forking paths)形式的多重比较问题;他们还强调,即使所选分析是观测数据的确定性函数,这也不能消除多重比较,因为 p 值回答的是“换一份可能的数据会发生什么”。
这两点合在一起,决定了本章的逻辑链:先定义“尝试”要被计数,再用冻结计划把能固定的选择固定住,再用留出样本评价,再把调整后的显著性阈值写进决策规则,最后决定报告什么。本章不教某个具体信号,也不替后面的 Value、Momentum、Quality 提供结论;它提供让那些章节的结论可被检查的流程。
3. 直觉
想象你要证明自己能连续猜中硬币。第一种做法:在抛硬币之前把规则写在纸上,“我只猜 10 次,猜中 9 次及以上才算我有能力”,然后抛币。第二种做法:先抛 10 次看结果,再决定“我到底想预测前 5 次还是奇数次”,再找出一个能描述这串结果的规则。两种做法都可能报告“猜中 9 次”,但只有第一种让这个数字携带信息。
金融研究里的“规则”对应一组选择:回看多少个月、跳过几个月、是否去极值、分几组、哪一段样本、是否剔除小盘股。你不会觉得自己在“钓鱼”,因为每个选择都有理由。问题在于如果数据换了模样,你会为另一套选择找到同样好的理由。这种“事后总能找到合理故事”的自由度,才是 Gelman 与 Loken 所说的分岔路径。
简化的边界要说清楚。若32次尝试各自使用全新、相互独立的一整批10次抛币,才有32个独立机会;同一批10次抛币上的不同事后子集或规则并不因此独立。金融变体不是这样:回看 11 个月和回看 12 个月的信号高度相关,它们的 t 统计量几乎同涨同跌。本章的蒙特卡洛实验会显示,32 个互相相关的变体对应的有效独立试验数只有 4 到 5 个左右。这里的“有效数”按最大绝对统计量的均值匹配,只描述一个矩,不等于检验族的大小,也不保证尾部概率相同。Bonferroni 仍按实际尝试数32计数;不能因为变体相关就假装只看了一次。
3.1 从一个经济问题到可交付的研究对象
先问“为什么账面市值比高的股票可能有更高的下月收益?”一种经济解释是投资者要求补偿困境风险;另一种是价格对信息反应不足。两者都导出正方向预测,却需要不同的反证与风险控制。因此先写机制,再写可测量的陈述:“在预先规定的股票池、财报可得规则和月份内,较高 B/M 对应较高下月收益”。下面每一步都交付一个具体对象。
| 步骤 | 本例操作与单位 | 产物交给谁 |
|---|---|---|
| 可观测输入 | 截止时点已公开且已入库的同版本账面权益、当时市值,均用同一货币单位 | 特征计算 |
| 特征(feature) | 同日预处理 | |
| 信号(signal) | 同日有效 B/M 的百分位,范围 0–1;行业内版本若要比较须另记规格 | 预测评价与权重构造 |
| 预测(prediction) | 主预测是正方向的相对次序;若要预测收益数值,需在发现窗估计并冻结收益映射 | 留出期标签评价 |
| 组合(portfolio) | 买高桶卖低桶,各腿权重和为 |
成交/持仓账本 |
| 评价(evaluation) | 每日期 IC、成本前后收益、基准差异及有效日期;按冻结规则判断 | 研究结论与下一次研究日志 |
“信号高”不是“预测收益为 8%”;百分位只给次序。IC 评价次序或线性关系,组合收益还依赖权重、成交时点与成本。第23章承接预测评价,第21/29章承接权重与账本。数据已被反复看过时,这条流程仍能约束本次选择,却不能把历史曝光抹去。
4. 数学基础
本章只用到:
- 单样本均值的 t 统计量。若
是某个指标按月的取值,样本均值 ,样本标准差 ,则 。分母 是均值的标准误,单位与 相同; 无量纲。本章的指标是每月的横截面信息系数(Information Coefficient, IC,定义见第23章,这里只当作一个无量纲的月度相关系数), 是月数。 - 长期方差与 Newey–West 修正:若
序列相关,均值的方差不再是 。Bartlett 核长期方差为 ,其中 ;均值方差估计取 。 即独立同分布的公式(除数为 而非 )。第15章已用于回归系数,这里直接用于一个常数回归。 - 概率论的联合界(Boole 不等式):对任意事件
, ,不要求独立。 - 次序统计量:
个独立同分布变量的最大值 满足 。 - 零假设下 p 值的性质:若检验对零假设有效,则
, ;由正确连续零分布精确校准时等号成立,此时p值在零假设下服从均匀分布。
频率约定:除非另说明,本章的
5. 正式定义
研究假设(research hypothesis):一句含对象、方向和期限的可证伪陈述,例如“高账面市值比的股票在下一个月的收益高于低账面市值比的股票(符号为正)”。本章的经济方向性假说要求明确对象、方向和期限;“价值因子有效”没有具体判据,容易被事后任意解释。这不排除事前固定的双侧主要检验:它可以不预设效应符号,但必须预先说明对象、期限、零假设与双侧拒绝规则。
研究计划(research plan)与冻结(freeze):研究计划是把下列项目写成文件:假设、股票池、数据来源、发现样本与留出样本的窗口、信号定义、标签定义、组合规则、基准、唯一的主指标、通过与失败的数值判据、成本假设、尝试预算(最多看多少个变体)。冻结指计算该文件规范化 JSON 的 SHA-256 并记录当时的本地时钟。哈希承接上一步“写下计划”,输出给后一步“评价留出样本”一个不可悄悄改动的参照;它的限制写在下一条。
本地冻结与预注册(pre-registration):在抗碰撞等密码学假设下,本地冻结允许把当前规范化内容与受信保存的摘要比较;匹配支持它与该参照内容一致,摘要本身不记录写作或修改历史,时间戳来自你自己的机器。预注册需要研究者之外的、带独立时间戳的登记(例如公开登记库或第三方保管的文件);只有这样才对“计划先于数据结果”提供外部证据。本章的 ResearchPlan 与 freeze_plan 只做本地冻结。Gelman 与 Loken 还指出,对已被许多人反复分析过的公共数据,预注册“几乎没有意义”,因为研究者无法假装对数据一无所知。本章使用的 French 行业数据正属于这一类,所以第11节的结论只能当作流程演示。
试验(trial)与试验账本(trial ledger):一次试验是任何一次你为了判断假设成立与否而读取了结果的变体评价。账本是只增不删的表:试验编号、规格、指标、样本量、状态(primary / run / abandoned)和备注。重复运行同一规格仍记一行;结果未定义(NaN)的尝试也记一行,因为你仍然看过那个数据。账本行数是多重检验调整的下限输入。
研究日志(research log):账本记录“做了什么得到了什么”,日志记录“为什么做、为什么改”。两者分开:账本是数据,日志是叙述。
发现样本、留出样本与嵌入禁运(discovery, holdout, embargo):发现样本用于选择规格;留出样本只在规格确定之后评价一次。若标签跨
基准(benchmark):回答“没有这个信号会怎样”的参照。本章用三种:零信号(等权持有)、置换基准(placebo,在每个月把标签在资产间随机打乱,保留月内标签集合与时间顺序)、已发表的简单规则(例如固定的 12-1 动量)。
消融(ablation):在固定其余步骤的前提下,逐一去掉一个组件(去极值、秩变换、滞后等),观察结果变化,以判断每个组件承担了什么。消融也是试验,必须记入账本。
负结果(negative result)与复现(reproducibility):负结果指按预先判据不支持假设的结果,必须与正结果同等地报告。复现指任何人拿到代码、数据哈希、随机种子和账本,得到相同数字。
家族错误率与错误发现率(family-wise error rate, FWER;false discovery rate, FDR):
十环节研究链(pipeline):下表是本章的主结构。每个环节都有输入、输出、留痕和典型失败;读法是“左边一格的输出是右边一格的输入”,计划冻结位于第 1 环节,成本模型在第 9 环节,留出评价在第 10 环节。
| 环节 | 输入 | 输出与留痕 | 典型失败 | 相关章 |
|---|---|---|---|---|
| 1 经济假设 | 机制、文献、你的先验 | 含符号、对象、期限的一句话;计划文件与哈希 | 无符号、可事后任意解读 | 22 |
| 2 数据 | 来源、授权、版本 | 来源 URL、下载时间、SHA-256、available_at |
当前修订值冒充历史可得值 | 3、13 |
| 3 清洗 | 原始表 | 缺失与异常的书面规则;清洗日志 | 看到收益之后才决定剔除谁 | 3 |
| 4 特征 | 清洗后数据 | 带窗口、单位、可用时间的特征定义 | 用到 signal_time 之后的数据 |
11、12 |
| 5 信号 | 特征 | 同日截面变换后的信号 | 全样本标准化、未来均值入当期 | 23、28 |
| 6 组合 | 信号 | 目标权重、约束、换手 | 约束与信号混写 | 21、23 |
| 7 回测 | 权重、收益 | 标签区间、滞后、毛收益与账本 | 同一数据多次迭代不计数 | 22、29、30 |
| 8 验证 | 回测结果 | 留出评价、基准、消融、置换 | 用留出样本调参 | 22、31 |
| 9 成本模型 | 换手、费率 | 毛/净收益;容量假设 | 费率套用到错误的权重变动 | 21、35 |
| 10 样本外 | 冻结后的规格 | 一次性评价;负结果也报告 | 看结果后改假设再“样本外” | 22、31 |
时间字段贯穿所有环节:事件发生的 event_time;系统可获得的 available_at;本地入库的 ingested_at;决策的 signal_time;成交的 trade_time;收益区间与标签区间。可执行研究要求 available_at 与 ingested_at 均不晚于决策截止,且 signal_time < trade_time;收益测量从实际成交价起算。本章月收盘标签是虚拟月末成交的研究代理,不能因为标签的月份较晚就认定收益全部发生在真实成交之后。具体字段与时钟见第23章5.2节。
5.1 一个小账本:主假设、探索与留出怎样共存
以下五行是教学构造,不是本章旧市场结果。计划先规定主规格 B/M 正方向、发现窗
| ID | 规格与状态 | 读取哪段结果 | p 值 | 结论身份 |
|---|---|---|---|---|
| D01 | 主规格,同日百分位 | 0.01 | 主假设发现结果 | |
| D02 | 见 D01 后改为行业内排名 | 0.04 | 事后探索 | |
| D03 | 见结果后改去极值门槛 | 0.03 | 事后探索 | |
| D04 | 常数信号,IC 未定义 | 缺失 | 未定义尝试,保留原因与样本数 | |
| D05 | 改标签期限后最优 | 0.005 | 事后探索,不能追称主规格 |
这五次服务同一发现决策,按本章全尝试口径组成一个检验族(test family),
留出评价另记 H01,链接“究竟评价 D01 还是发现窗选出的 D05”。若计划登记仅 D01 为主确认,D05 的留出结果只能按探索后验证报告;若计划事先登记发现窗选规格、留出确认的完整算法,则 H01 评价的是该选择算法选定的规格。两种计划都要在打开
本地哈希绑定计划内容;第三方保存的先后记录支持冻结时间;此前使用过 French 历史的事实记录曝光。三者分别回答“内容是什么”“何时写下”“知道过哪些历史”,不会相互替代。发现窗与留出窗隔离减少标签交叉,并不保证金融时间序列统计独立,推断仍须检查相依与样本量。
6. 推导
6.1 多次检验的家族错误率
设有
推导只用了独立性:不拒绝的概率是
读法:32 次独立尝试里至少有一次“显著”的概率是 81%,这是计划里写“尝试预算”的原因。条件是各检验独立;相关本身不保证该概率一定低于81%;第13节的特定构造实验测得23.6%,不能把它推广成任意相依结构下的界。
6.2 Bonferroni 校正与联合界
不要求独立。设
第一步是联合界,第二步用零假设下
6.3 Holm 逐步下降程序为什么也控制 FWER
排序
设
比较:第 1 步 Holm 与 Bonferroni 的门槛相同(
6.4 Benjamini–Hochberg 与错误发现率
BH 程序:找最大的
6.5
设
Bailey 与 López de Prado(2014,式 (1),附录 A.1)给出大
| 近似式 | 数值积分 | 相对误差 | |
|---|---|---|---|
| 2 | 0.520 | 0.564 | −7.9% |
| 5 | 1.193 | 1.163 | +2.5% |
| 10 | 1.575 | 1.539 | +2.3% |
| 32 | 2.100 | 2.070 | +1.5% |
| 100 | 2.531 | 2.508 | +0.9% |
| 1000 | 3.255 | 3.241 | +0.4% |
近似式对小
6.6 选择之后的评价为什么需要新数据
设你在发现样本上选出
6.7 从
若每月多空收益
7. 金融解释
假设要先有经济机制。 一个能写进计划的假设至少属于三类机制之一:风险补偿(该特征对应投资者要求更高回报的风险暴露)、行为或信息反应不足(价格对公开信息调整缓慢)、制度或融资约束(某类投资者被迫买入或卖出)。第24–27章分别给 Value、Momentum、Quality、Carry 各自的机制与反对意见。机制的作用不是证明信号有效,而是限制你可以合法尝试的变体:机制说“过去一年赢家继续赢”,就不该因为数据好看而改成“过去 7 周”。
阈值随尝试数变化。 HLZ(2014)的建议
留出样本的含义有限。 留出样本把“选择”与“评价”分开,但它不是新的世界:它来自同一市场、同一数据供应商、通常是同一代理(proxy)。一个在留出样本通过的信号仍可能是容量很小、成本之后为负、或在下一个体制失效。方法论在边际 p 值有效且满足指定选择与依赖条件时控制 FWER 或 FDR;单次研究仍可能误报。误差率控制也不证明成本后收益为正。
负结果有信息。 如果预先写好“留出
8. 数值例题:手算每一步
本节所有数字都可以用纸笔复核;第9节的代码用断言再核对一遍。
8.1 五次试验的账本与三种校正
8.2 四个 p 值的另一个例子
8.3 冻结文件的哈希
第9节代码把一份价值假设的计划写成 ResearchPlan,固定本地时钟为 2026-10-06 09:00 UTC 后得到 SHA-256 前 16 位 40d38a74d67e0c08。若只把判据从 “holdout e8ba36254e34603b…,完全不同。若同事已受信保存原摘要,修改后的内容会在摘要比对中被识别(依赖抗碰撞假设)。只保存可同时替换的文件与摘要不提供防篡改历史;哈希也不能证明写计划之前没有看过数据。
8.4 32 个变体的家族错误率与 Bonferroni 门槛
32 个独立检验,水平 5%:
9. Python 实现
本章的可复用代码在 research_protocol.py,截面与 IC 工具在 factor_research.py(第23章详述),月频动量窗口在 factor_signals.py。接口:
| 函数/类 | 输入 | 输出与边界 |
|---|---|---|
ResearchPlan |
假设、股票池、数据来源、四个窗口端点、信号/标签/组合定义、基准、主指标、判据、成本假设、尝试预算 | 冻结数据类;任何必填项为空、预算不是正整数、发现窗口与留出窗口重叠都会报错 |
freeze_plan |
计划与可选的本地时钟 | FrozenPlan,含规范化 JSON 的 SHA-256 与本地时间字符串;不是外部时间戳 |
TrialLedger.record |
规格字典、指标、样本量、状态、备注 | 追加一行;指标须为有限实数或 NaN;无穷、布尔、未知状态拒绝;n_trials 数每一行 |
bonferroni_adjust、holm_adjust、benjamini_hochberg_adjust |
一维 p 值数组 | 按输入顺序返回调整后 p 值;空数组、越界、NaN 拒绝 |
expected_max_standard_normal、..._exact |
整数 |
DSR 近似式( |
split_discovery_holdout |
月频 PeriodIndex 与计划 |
两个互不相交的月份标签集合;窗口与样本无交集时报错 |
第一段代码冻结价值假设的计划并演示哈希:
import dataclasses
from datetime import datetime, timezone

from quant_course.research_protocol import ResearchPlan, freeze_plan

plan = ResearchPlan(
    hypothesis="Cheap stocks (high B/M) earn higher next-month returns (sign +)",
    universe="constructed 200 names x 180 months",
    data_sources=("constructed panel, seed 20261006",),
    discovery_start="2000-01", discovery_end="2009-12",
    holdout_start="2010-01", holdout_end="2014-12",
    signal_definition="percentile rank of B/M within month, no lag",
    label_definition="next-month simple return",
    portfolio_rule="top quintile minus bottom quintile, equal weight",
    benchmark="equal-weight universe",
    primary_metric="t of mean IC: Pearson correlation of within-month signal ranks with next-month return, Newey-West lag 0, holdout",
    decision_rule="holdout t >= 2.0 and positive sign",
    cost_assumption="10 bp per unit traded", trial_budget=1,
)
clock = datetime(2026, 10, 6, 9, 0, tzinfo=timezone.utc)
frozen = freeze_plan(plan, now=clock)
edited = freeze_plan(dataclasses.replace(plan, decision_rule="holdout t >= 1.5 and positive sign"), now=clock)
assert frozen.sha256.startswith("40d38a74d67e0c08")
assert edited.sha256.startswith("e8ba36254e34603b") and edited.sha256 != frozen.sha256
print(frozen.sha256[:16], edited.sha256[:16])
第二段代码重复 8.1 的五次试验:账本计数,三种调整,并与手算值核对:
import numpy as np
from scipy import stats

from quant_course.research_protocol import (
    TrialLedger, benjamini_hochberg_adjust, bonferroni_adjust, holm_adjust, pad_untested_attempts,
)

t = np.array([2.4, 1.1, 0.4, 1.9, 2.1])
ledger = TrialLedger()
for name, value in zip("abcde", t):
    ledger.record({"variant": name}, metric=float(value), n_obs=120, status="primary" if name == "a" else "run")
ledger.record({"variant": "f"}, metric=float("nan"), n_obs=0, status="abandoned", note="constant signal: IC undefined")
assert ledger.n_trials == 6          # the undefined attempt still counts as a look at the data

p = 2 * stats.norm.sf(t)
np.testing.assert_allclose(np.round(p, 4), [0.0164, 0.2713, 0.6892, 0.0574, 0.0357])
np.testing.assert_allclose(np.round(bonferroni_adjust(p), 3), [0.082, 1.0, 1.0, 0.287, 0.179], atol=1e-3)
np.testing.assert_allclose(np.round(holm_adjust(p), 3), [0.082, 0.543, 0.689, 0.172, 0.143], atol=1e-3)
np.testing.assert_allclose(np.round(benjamini_hochberg_adjust(p), 3), [0.082, 0.339, 0.689, 0.096, 0.089], atol=1e-3)
full = pad_untested_attempts(p, ledger.n_trials)            # the undefined attempt enters the family as p = 1: family size 6
np.testing.assert_allclose(np.round(bonferroni_adjust(full)[:5], 3), [0.098, 1.0, 1.0, 0.345, 0.214], atol=1e-3)
np.testing.assert_allclose(np.round(holm_adjust(full)[:5], 3), [0.098, 0.814, 1.0, 0.230, 0.179], atol=1e-3)
np.testing.assert_allclose(np.round(benjamini_hochberg_adjust(full)[:5], 3), [0.098, 0.407, 0.827, 0.115, 0.107], atol=1e-3)
print(ledger.to_frame()[["trial_id", "status", "metric"]])
注意 ledger.n_trials 是 6 而不是 5:第 6 个尝试结果未定义,但你为了得到它读取了数据。应报告的主口径是全账本的家族大小 pad_untested_attempts 把没有
第三段代码核对期望最大值近似式的精度(6.5 节表):
import numpy as np

from quant_course.research_protocol import expected_max_standard_normal, expected_max_standard_normal_exact

exact_two = expected_max_standard_normal_exact(2)
assert abs(exact_two - 1 / np.sqrt(np.pi)) < 1e-9                 # hand value 1/sqrt(pi) = 0.5642
for n, tol in ((10, 0.04), (100, 0.03), (1000, 0.02)):
    approx, exact = expected_max_standard_normal(n), expected_max_standard_normal_exact(n)
    assert abs(approx - exact) < tol
print(round(expected_max_standard_normal(32), 3), round(expected_max_standard_normal_exact(32), 3))   # 2.1 2.07
默认离线入口与历史实验分开。 在随书 I3 读者包根目录运行:
.venv/bin/python run_notebook.py notebooks/ch22_research_methodology.ipynb
默认 RUN_FRENCH=False。Notebook 展示冻结/哈希、六行账本与五个有效 p 值的两种族口径、最大值期望、单次32变体构造世界,以及60次零世界和60次备择世界模拟(不是第10/13节历史图表的各500次)。Notebook 只创建章级 RUN_DIR,不写CSV/PNG,也不生成历史图库。运行器另建 runs/execution_ch22_research_methodology_<uuid>/,保存执行副本与状态,不能与章级目录混称。默认五有效 p 值的演示不意味着有第六个有效 p 值;失败尝试的全族调整仍按前文补1的口径解释。
历史完整 CLI 为 code/ch22_research_methodology.py,包含 French 分支及各500次模拟,不能当作默认离线命令。其历史种子固定为20261006(零世界)和20261007(备择世界),并在计算留出数字前写本地冻结计划;本地时钟不提供外部先后证据。以上历史数字和图沿用原实验,本章不要求为阅读重新执行。
NaN策略:账本接受NaN指标并计数;ic_summary丢弃NaN日期并记入n_missing;丢弃后NW滞后按有效数组的位置计算,内部日期缺口须另查。有效日期少于三个时汇总报错。
数据频率为月频;信号时点 signal_time 是月末,标签是下一个月的简单收益,收益测量区间是该下一个月;French 行业月收益是已修订的历史快照,不是时点版本,所以 available_at 实际晚于月末,本章把月末当作信号时点是理想化假设。
10. 图形解读
图 22-1:十环节研究链。 两排各五个方框,从左到右、先上后下,每个框写环节名和它留下的痕迹。没有从第 10 环节指回第 1 环节的箭头:留出评价的结果不允许改写它本来要检验的假设。图是流程示意,不含数据。
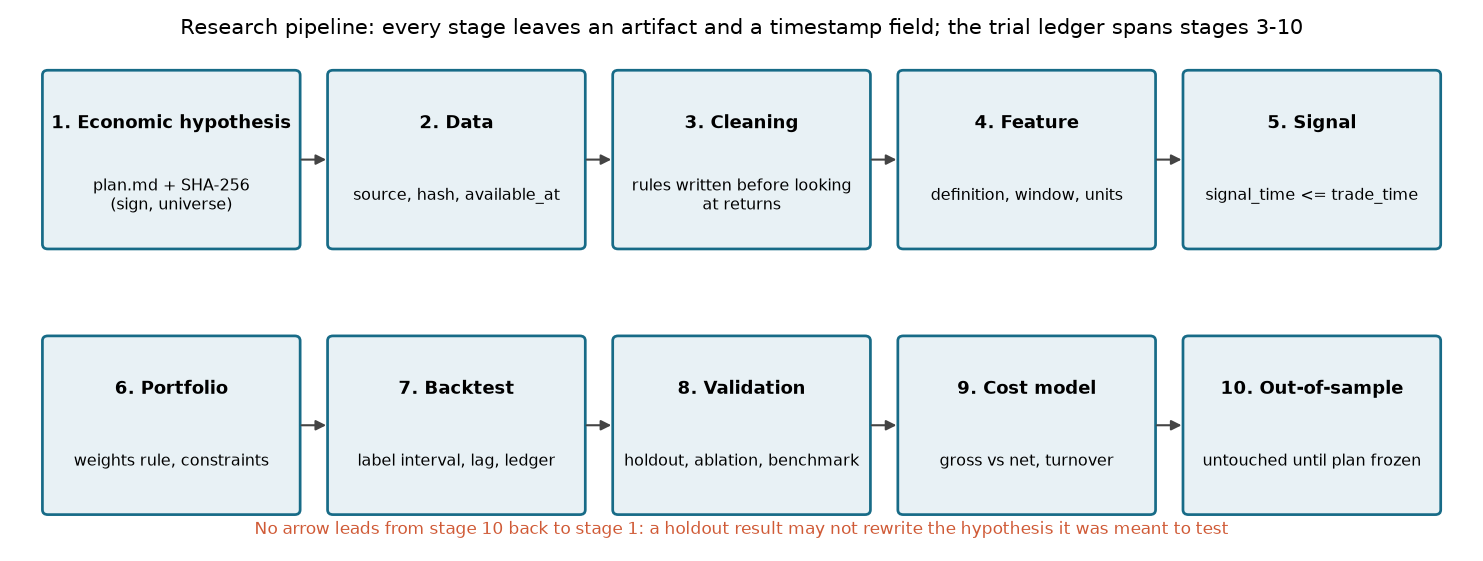
图 22-2:构造世界中搜索如何制造显著性,以及留出样本如何区分两种世界。 两个世界各 500 次独立模拟,每次 200 只股票、发现样本 120 个月、禁运 3 个月、留出样本 60 个月,零世界种子20261006、备择世界种子20261007(原图共同大标题仅写20261006,不能据此把两世界种子混同)。左图是零世界(真实 IC 为零):蓝色是预先登记的单一规格在发现样本上的
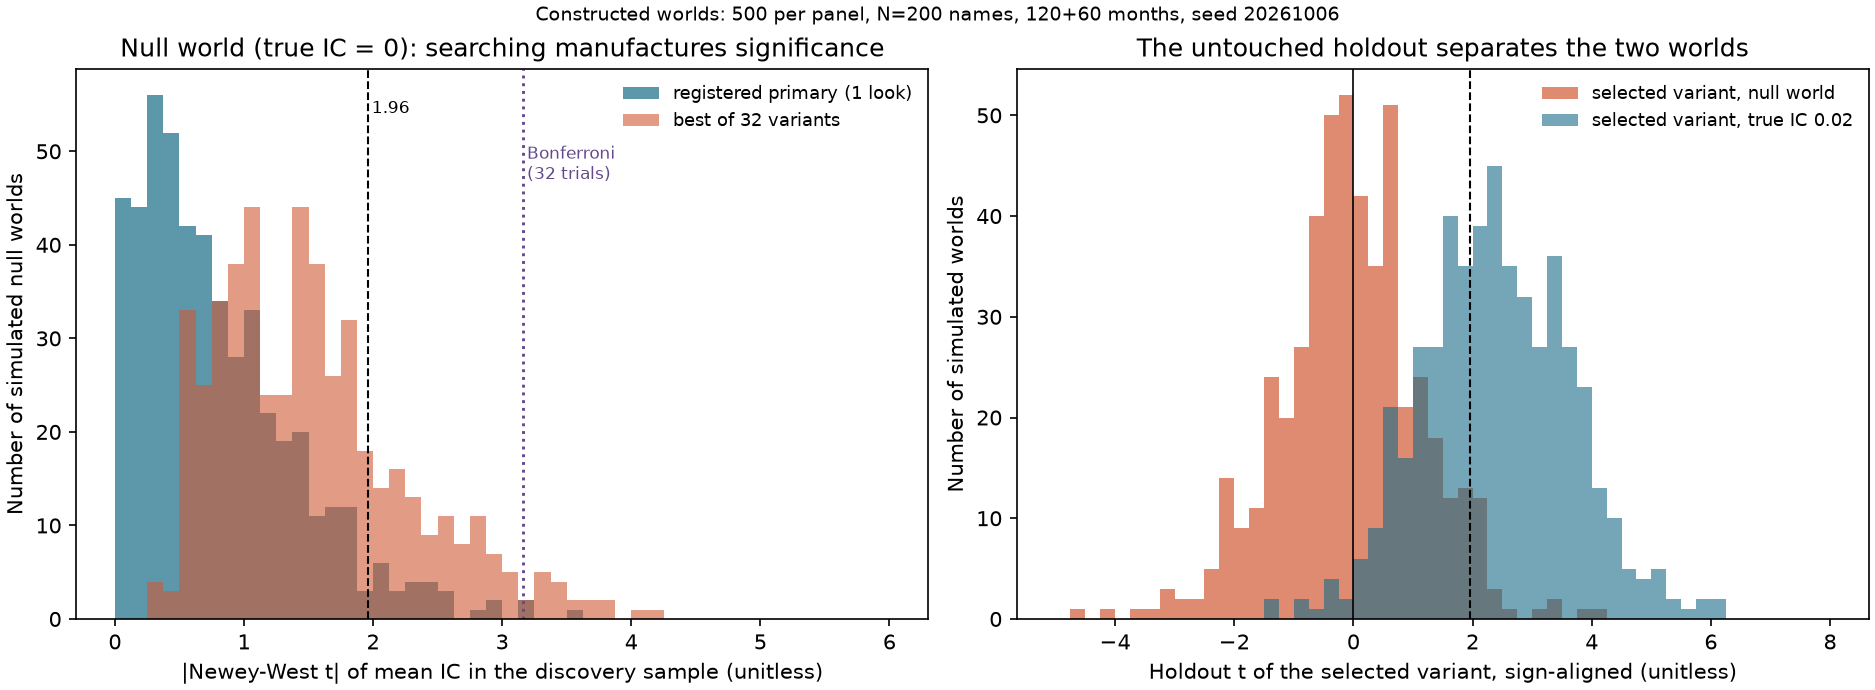
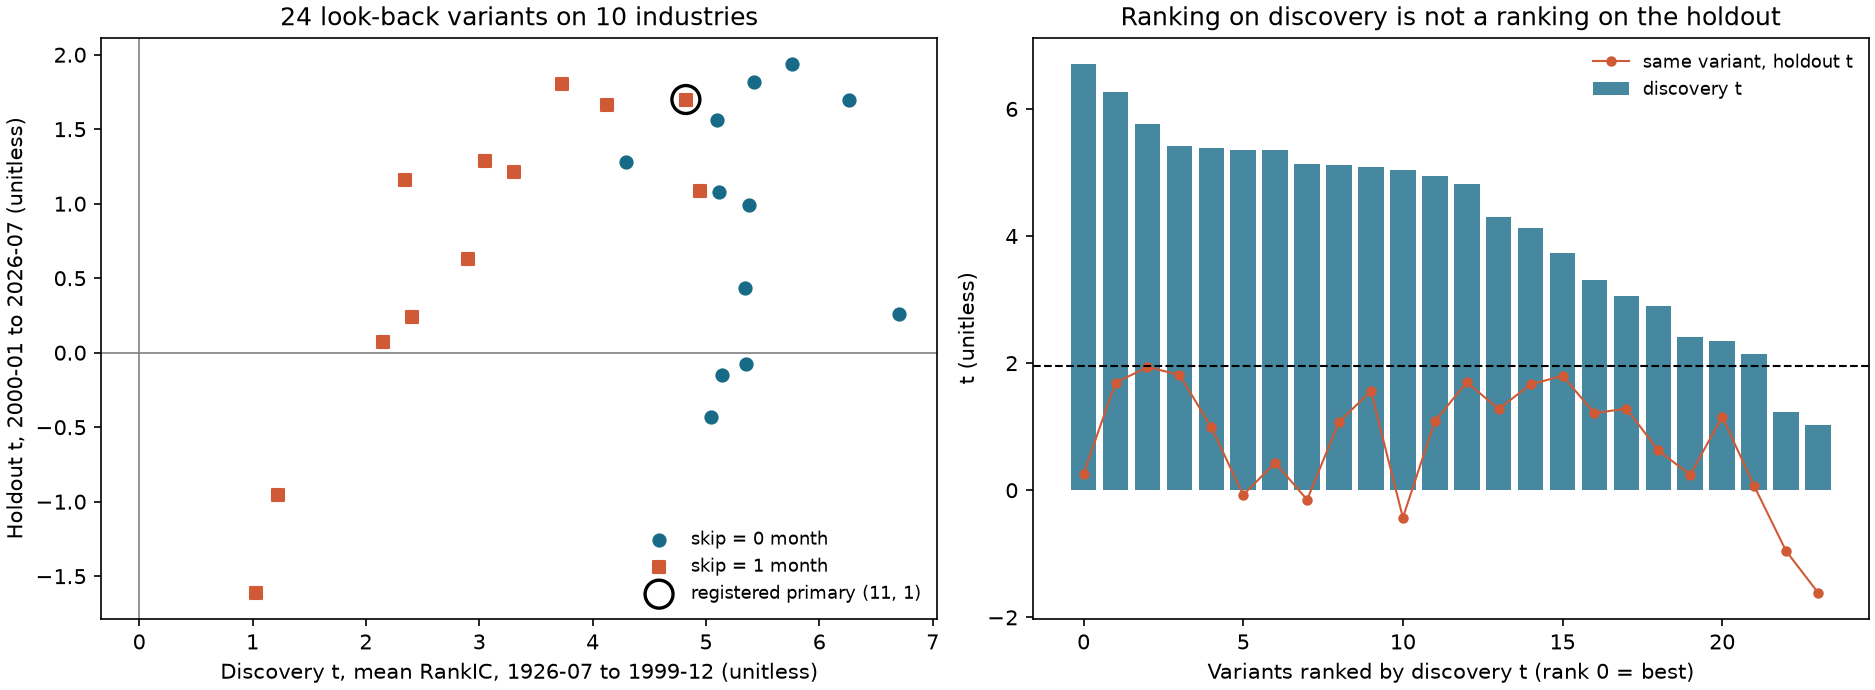
图 22-3:French 行业动量的 24 个回看窗口变体。 左图每个点是一个 (回看月数, 跳过月数) 组合,横轴是发现样本 1926-07 至 1999-12 的
11. 真实市场历史例
数据。 沿用 2026-10-05 冻结的 French 10 行业价值加权月收益:来源 Ken French 数据库 10 Industry Portfolios,ZIP SHA-256 ebd937a4b995d821867aeb956a96f09a666386f38fa82516b7d1767ee4a49ae5,处理后 CSV SHA-256 3b097d810c295d64eedfa1ece7067ff2a0707f5ca90e33935df9949251f70950,1,202 个月(1926-07 至 2026-08),单位为小数月简单收益。公开可下载不等于可任意再分发。本章不下载新数据。
计划(冻结)。 假设:过去 12-1 收益较高的行业,下个月收益较高(符号为正)。信号:月末
结果。 所有数字由 code/ch22_research_methodology.py 产生,并由 qa/a5/claude/recompute/ch22_recompute.py(不导入课程代码,用逐月循环和 scipy.stats.spearmanr)独立复算,两者一致。
| 变体(回看, 跳过) | 发现月数 | 发现平均 Rank IC | 发现 |
留出月数 | 留出平均 Rank IC | 留出 |
|---|---|---|---|---|---|---|
| 登记主规格 (11, 1) | 871 | 0.0688 | 4.82 | 319 | 0.0414 | 1.70 |
| 发现样本最优 (1, 0) | 882 | 0.0925 | 6.70 | 319 | 0.0061 | 0.26 |
| (12, 0) | 871 | 0.0877 | 6.26 | 319 | 0.0412 | 1.69 |
| (6, 1) | 876 | 0.0433 | 3.05 | 319 | 0.0304 | 1.28 |
24 个变体里发现样本
按预先写好的判据。 主规格留出
多重检验调整。 对发现样本 24 个变体的双侧 p 值,最优变体的原始 p 值约
换成多空组合与成本(演示)。 每月把 10 个行业按信号分为 5 组(每组 2 个),买最高组、卖最低组,各腿等权,毛暴露 2、净暴露 0。换手取相邻月份目标权重差的绝对值和(买卖合计,不折半,忽略漂移)。主规格 (11,1):发现样本毛平均 0.561% 每月(
这个例子证明了什么,没有证明什么。 它演示了:登记的主规格、发现样本选出的最优规格、留出样本三者可以给出很不同的结论;“按判据未支持”与“估计量显著为零”不是一回事。它不证明行业动量不存在,不验证第25章的任何结论,也不是对 12-1 动量的独立检验:留出样本不是纯净的,作者读过动量文献,前面章节已用这份数据;10 个资产的截面很小;数据是修订历史。
12. 常见错误
错误 1:只报告 N 个变体里最好的那个。 零世界里 20 个独立变体取最大
import numpy as np

rng = np.random.default_rng(7)
z = rng.standard_normal((20000, 20))                       # 20 independent null z-statistics per "paper"
reported_best = (np.abs(z).max(axis=1) > 1.96).mean()      # report only the best of 20
single = (np.abs(z[:, 0]) > 1.96).mean()                   # report the one pre-committed test
bonferroni = (np.abs(z).max(axis=1) > 3.0).mean()          # hurdle for 20 looks: z = 3.02 two-sided at 5%
assert abs(reported_best - (1 - 0.95**20)) < 0.015 and abs(single - 0.05) < 0.01 and bonferroni < 0.06
print(round(reported_best, 3), round(single, 3), round(bonferroni, 3))
修复:报告全部变体,或在计划里只登记一个并写明预算;若搜索不可避免,用 Bonferroni 或 Holm 门槛。
错误 2:看到结果后改判据。 8.3 节哈希已显示:改判据一个字符,哈希整个变化。修复是把判据写进计划并哈希;若确需修改,新建版本并在账本与日志里记录“改于看到留出结果之后”。
错误 3:反复用留出样本选择。 若你在留出样本上评价 10 个独立变体并挑最好的一个,零世界里它至少一个“显著”的概率是
错误 4:标准化或去极值参数用到了未来。 对时间序列做全样本标准化,早期信号就依赖晚期数据。
import numpy as np

x = np.array([0.5, -0.2, 0.1, 0.4, -0.1, 3.0])        # pretend x[5] arrives later
full = (x - x.mean()) / x.std(ddof=0)                  # full-sample: uses the future
causal = np.array([(x[: i + 1] - x[: i + 1].mean())[-1] / (x[: i + 1].std(ddof=0) or 1.0) for i in range(len(x))])
x2 = x.copy(); x2[5] = -3.0                            # the future value changes ...
full2 = (x2 - x2.mean()) / x2.std(ddof=0)
causal2 = np.array([(x2[: i + 1] - x2[: i + 1].mean())[-1] / (x2[: i + 1].std(ddof=0) or 1.0) for i in range(len(x2))])
assert not np.allclose(full[:5], full2[:5])            # ... and rewrites earlier "signals"
assert np.allclose(causal[:5], causal2[:5])            # expanding-window version does not
print(np.round(full[0], 3), np.round(full2[0], 3))
截面标准化(同一天内对所有股票)不属于这个错误,因为同一天的所有数据都在 signal_time 之前可得;第28章专门区分这两类。
错误 5:只数“成功”的试验。 账本必须记已放弃和未定义的尝试(第9节第二段代码里 n_trials 为 6)。只数成功者等于把
错误 6:重叠标签的朴素
错误 7:选择偏向偏差最大的统计量。 同一个零世界里,选出的“最优变体”留出
13. 量化研究应用:同一价值假设的事前固定研究计划与事后挖掘对照
本节把第 8.3 节的价值假设计划与一个“挖掘版”放在同一套构造数据上对照。数据是教学构造:200 只股票、发现样本 120 个月、禁运 3 个月、留出样本 60 个月;特征是一个月度自相关系数 0.9 的重尾(Student-
路径 A(事前固定规格):只评价冻结计划里的变体 0(秩变换、滞后 0、标签一个月),按判据决定。模拟里每个月的统计量是“秩变换后的信号与原始收益的皮尔逊相关”(为便于向量化,没有对收益取秩),所以它与第23章的 Rank IC(两边都取秩)不同;其余变体取“变换后的信号与原始收益的皮尔逊相关”,计划里的主指标文字与此一致。第11节的真实数据才使用两边取秩的斯皮尔曼 Rank IC。路径 B(事后挖掘):评价 32 个变体(秩/原值/1% 去极值/5% 去极值 × 信号滞后 0–3 个月 × 标签期限 1 或 3 个月),选发现样本
| 指标(500 次模拟) | 零世界:路径 A | 零世界:路径 B | 备择世界:路径 A | 备择世界:路径 B |
|---|---|---|---|---|
| 发现样本 |
5.4% | 23.6% | 82.6% | 93.6% |
| 发现样本 |
— | 3.6% | — | 65.8% |
| 留出样本 |
2.8% | 4.6% | 57.6% | 61.8% |
| 路径 B 选出的恰是登记变体 0 的比例 | — | 5.8% | — | 5.0% |
读法。零世界里路径 B 把假阳性率从 5.4% 抬到 23.6%,不是 1−0.95³² = 81%:变体相关,用发现样本最大
对 Project 4 的含义:多因子项目开始前必须先写冻结计划,至少含本章第 5 节列出的十二项,并规定账本格式、禁运规则与留出样本只评价一次。没有这份计划,Project 4 的任何“显著”都不能写进结论。第28章会把预处理、合成和约束作为独立步骤写进计划。Project 5 的配对筛选同理:训练期做了多少次协整检验,要进账本(准备层见 projects/project05/preparation/)。
基准与反证条件:基准是等权持有(零信号)与置换基准;反证条件是“留出
14. 本章小结
本章把一次因子研究拆成十个环节,要求每个环节都留下可检查的痕迹。核心关系有四条。第一,冻结计划约束看结果前能固定的选择,账本记录实际读取过结果的全部尝试。第二,独立且校准有效的检验给出
适用边界:本地哈希不是预注册;French 行业数据是已修订历史且已被前面章节使用;10 个资产的截面检验功效低;成本是假设值;整章结论是方法论演示,不是对任何因子的实证判决。
15. 练习题
22-E01(概念) 说出本地冻结与外部预注册各能证明什么、不能证明什么。若同事问“你的哈希时间戳早于数据吗”,你该如何回答?
22-E02(概念) 举一个只做了一次回归、事先持有假设,但仍存在分岔路径的金融研究例子,指出分岔点。
22-E03(手算) 独立检验,水平
22-E04(手算)
22-E05(推导) 用
22-E06(解释) 零世界的 32 个变体,发现样本最大
22-E07(手算) 你在留出样本上评价 10 个互相独立的零假设变体,并报告最好的一个。至少一个
22-E08(手算) 某多空策略
22-R01(账本诊断,延伸练习) 对5.1节五行账本,写出计算族中的原始 p 向量、Holm 排序乘数、5% 下三种方法拒绝哪些 ID。若在 H01 后把标签期限改成最优值,该次评价还能称未曝光留出吗?说明文件哈希能否改变答案。
16. 编程练习
22-P01 写出你自己的 ResearchPlan(任一假设),冻结并存成 JSON;再改动一个字段,验证哈希不同;断言发现窗口与留出窗口重叠会报错。验收:三条断言通过。
22-P02 用账本记录 8 个变体(含 1 个未定义结果),计算双侧 p 值,用 pad_untested_attempts 补足全账本的家族大小 n_trials==8,家族大小为 8,Bonferroni
22-P03 模拟 32 个相关系数为 0.8 的零假设
17. 挑战题
22-C01(证明) 证明
22-C02(开放) 为第25章的 12-1 动量写一份完整的冻结计划:十二项全部填写,给出账本字段、禁运规则、留出样本只评价一次的流程,并列出至少三个会使你把假设判为“未被支持”的具体数值结果。评分:计划完整性 30 分,判据可证伪性 30 分,对已被他人反复分析数据的局限陈述 20 分,成本与基准设计 20 分。
18. 完整答案与参考实现
22-E01 本地冻结把规范化JSON绑定到摘要;在抗碰撞等密码学假设下,与受信保存摘要匹配支持当前内容与该参照一致。它不证明期间从未改动又改回,也不证明写作先后;可同时替换的文件/摘要不能自行建立可信历史。本地时钟可调,不能证明计划先于曝光。外部登记由第三方保存内容摘要并给时间,为登记先后提供证据,但仍须记录此前已见的数据。回答同事:“当前内容可与受信保存的摘要比对;本地时间不是外部先后证据,本章数据以前已用过,因此这只是流程演示。”
22-E02 例:研究“过去 12 个月收益能否预测下月收益”。你事先持有假设,只跑了一个回归;但你在看到结果之前没有固定:是否去掉最低价格的股票、是否使用价值加权、是否剔除金融股、样本起点。如果数据显示效应主要在小盘股,你会为“剔除微型股”找到合理理由;如果显示在大盘股,你会为“价值加权”找到理由。无论你实际上跑了多少个回归,这些依赖数据的选择就是分岔路径。
22-E03
22-E04
22-E05 expected_max_standard_normal(2) 核对。)
22-E06
22-E07
22-E08
22-R01 计算向量为
22-P01 参考实现
import dataclasses
import json
from datetime import datetime, timezone

import pytest

from quant_course.research_protocol import ResearchPlan, freeze_plan

plan = ResearchPlan(
    hypothesis="Higher past 12-1 return predicts higher next-month return (sign +)",
    universe="10 French industries", data_sources=("french_10_industries_monthly.csv",),
    discovery_start="1926-07", discovery_end="1999-12", holdout_start="2000-01", holdout_end="2026-07",
    signal_definition="12-1 compounded return", label_definition="next-month simple return",
    portfolio_rule="top 2 minus bottom 2, equal weight", benchmark="equal-weight 10 industries",
    primary_metric="t of mean RankIC in holdout", decision_rule="holdout t >= 2.0 and positive",
    cost_assumption="10 bp per unit traded", trial_budget=24,
)
clock = datetime(2026, 10, 6, 9, 0, tzinfo=timezone.utc)
first = freeze_plan(plan, now=clock)
second = freeze_plan(dataclasses.replace(plan, trial_budget=25), now=clock)
assert first.sha256 != second.sha256
saved = json.dumps({"sha256": first.sha256, "frozen_at_local": first.frozen_at_local}, indent=1)
assert json.loads(saved)["sha256"] == first.sha256
with pytest.raises(ValueError):
    dataclasses.replace(plan, holdout_start="1999-06")        # overlaps the discovery window
22-P02 参考实现
import numpy as np
import pandas as pd
from scipy import stats

from quant_course.research_protocol import (
    TrialLedger, benjamini_hochberg_adjust, bonferroni_adjust, holm_adjust, pad_untested_attempts,
)

t_values = [2.8, 2.1, 1.7, 1.2, 0.9, 0.5, -0.4]
ledger = TrialLedger()
for i, value in enumerate(t_values):
    ledger.record({"variant": i}, metric=value, n_obs=120, status="primary" if i == 0 else "run")
ledger.record({"variant": 7}, metric=float("nan"), n_obs=0, status="abandoned", note="constant signal")
assert ledger.n_trials == 8
p = np.append(2 * stats.norm.sf(np.abs(np.array(t_values))), np.nan)          # the undefined attempt has no p-value
family = pad_untested_attempts(p[:-1], ledger.n_trials)                          # ... and enters the family as p = 1: M = 8
assert family.size == 8 and family[-1] == 1.0
table = pd.DataFrame({"t": t_values + [np.nan], "p": family, "bonf": bonferroni_adjust(family), "holm": holm_adjust(family),
                      "bh": benjamini_hochberg_adjust(family)})
assert (table["bonf"] >= table["holm"] - 1e-12).all() and (table["holm"] >= table["bh"] - 1e-12).all()
assert (table["bonf"].iloc[-1], table["holm"].iloc[-1], table["bh"].iloc[-1]) == (1.0, 1.0, 1.0)
print(table.round(4))
(这里的 7 个
22-P03 参考实现
import numpy as np
from scipy import integrate, optimize, stats


def mean_max_abs_normal(n):
    cdf = lambda x: 2 * stats.norm.cdf(x) - 1
    pdf = lambda x: 2 * stats.norm.pdf(x)
    return integrate.quad(lambda x: x * n * pdf(x) * cdf(x) ** (n - 1), 0, 12, limit=200)[0]


rng = np.random.default_rng(1)
m, rho, worlds = 32, 0.8, 20000
common = rng.standard_normal((worlds, 1))
z = np.sqrt(rho) * common + np.sqrt(1 - rho) * rng.standard_normal((worlds, m))
observed = np.abs(z).max(axis=1).mean()
n_eff = optimize.brentq(lambda n: mean_max_abs_normal(n) - observed, 1.0, 500.0)
assert 1.55 < observed < 1.75 and 5.0 < n_eff < 7.0
assert abs(mean_max_abs_normal(32) - 2.347) < 0.01
print(round(observed, 3), round(n_eff, 2), round((np.abs(z).max(axis=1) > 1.96).mean(), 3))
输出约为 1.648、5.92、0.258:相关系数0.8的32个变体在最大绝对值均值这个矩上约匹配6个独立试验;零假设下取最大后拒绝 1.96 的比例是 26%,远低于独立情形的 81%。
22-C01 设
22-C02(评分依据与参考) 参考计划(节选):假设“过去 12-1 复利收益越高,下一个月收益越高,符号为正”;股票池须写明是否含小盘与金融股;数据须写明价格口径(总回报)和 available_at;发现样本与留出样本的端点;信号 12-1(11 个月窗口,跳过 1 个月);标签下一个月;组合十分位多空、等权、月度再平衡;基准等权与置换;主指标留出 Rank IC 的
19. 进一步阅读
- Must Know:Harvey–Liu–Zhu 工作稿 §4.3–4.4(FWER、FDR、Bonferroni、Holm 的定义与例子),先读摘要与引言,再读这两节。用途:理解为什么
不再足够。 - Must Know:Gelman–Loken,读 §1.1–1.2 与 §4.3,理解分岔路径与预注册的限制。
- Should Know:Bailey–López de Prado 的 Deflated Sharpe Ratio 前半部分,读式 (1) 与附录 A.1;第32章再读完整构造。
- Should Know:Bailey 等的 PBO 论文 §2 定义,理解“选择过程”的过拟合;第30–32章使用。
- Advanced:Holm(1979)、Benjamini–Hochberg(1995)与 Benjamini–Yekutieli(2001)的原文,核对 6.3 与 6.4 的结论;本章未读这些原文。
- Optional:任何公开的预注册平台说明,了解外部时间戳如何运作。
20. 参考文献
引用键与读取范围见 source_notes.md。
- CH22_HLZ2014:Harvey, C. R., Liu, Y., Zhu, H. (2014). “… and the Cross-Section of Expected Returns.” NBER Working Paper 20592。支持第 2、5、6.3、7 节;期刊版 RFS 2016 未读。
- CH22_DSR2014:Bailey, D. H., López de Prado, M. (2014). “The Deflated Sharpe Ratio.” 作者预印本 2014-07-31 版。支持第 6.5 节式 (1)。
- CH22_PBO2015:Bailey, D. H., Borwein, J. M., López de Prado, M., Zhu, Q. J. (2015). “The Probability of Backtest Overfitting.” 作者预印本。仅用于第 5、19 节的概念预告。
- CH22_GELMANLOKEN2013:Gelman, A., Loken, E. (2013). “The garden of forking paths.” 未发表工作稿。支持第 2、3、5 节。
- CH22_JT1993:Jegadeesh, N., Titman, S. (1993). “Returns to Buying Winners and Selling Losers.” Journal of Finance 48(1),印刷页 68–69;支持第 7 节关于 32 个策略的 Bonferroni 说明。
- FRENCH:Kenneth R. French Data Library,10 Industry Portfolios(冻结快照与哈希见第11节与
data/manifests/french_industries_2026-10-05.json)。