第 39 章/ 45
正则化线性模型(Regularized Linear Models)
历史展示沿用A8-R1冻结结果,旧A8-A接受版本保留;本章不重训、不补造历史预测。主线:特征多、信号弱时,OLS 的系数方差会吞掉样本外表现;Ridge、Lasso、Elastic Net 用可控的偏差换方差,但正则强度必须在训练内选,结果必须与零预测和训练均值比较,并在成本后评价。
先修:第8章回归(OLS、标准化、软件中的正则化入门)、第38章管线。完成后你能:写出 scikit-learn 中三种估计器的目标函数与缩放约定;在正交设计下手算四个估计量;推导 Ridge 单系数的偏差、方差与最优强度;解释 L1/L2 的几何与共线性下的行为;在第38章管线上比较六个模型的预测指标与成本后组合结果。
1. 本章目标
写出 OLS、Ridge、Lasso、Elastic Net 的目标函数,说明 scikit-learn 1.9.1 中 Ridge 不除以 2 n 2n 2 n 2 n 2n 2 n
在 X ⊤ X = n I X^\top X=nI X ⊤ X = n I
推导 Ridge 的闭式解、奇异值收缩因子,以及单系数的偏差、方差、均方误差和最优强度 α ∗ = σ 2 / w 2 \alpha^\ast=\sigma^2/w^2 α ∗ = σ 2 / w 2
推导 Lasso 软阈值与 Elastic Net 的正交解,用几何说明 L1 产生零系数、L2 不主动产生稀疏解。
说明标准化为何必须在训练内拟合,且决定了“惩罚同等对待每个特征”是否成立。
解释共线性下 OLS 的符号翻转、Ridge 的平分、Lasso 的二选一,以及系数不能直接解释为因果。
用第38章的日期 walk-forward 与训练内调参,在“噪声特征多于有效信号”的构造面板上比较零预测、训练均值、OLS、Ridge、Lasso、Elastic Net 的样本外与成本后表现。
完成条件:第15–17节可独立完成;能追溯第8–10节冻结输入与输出,并解释第9节新运行与冻结回放的身份边界;本批不运行或重训。
2. 为什么 Quant 需要它
截面选股模型常常有几十到几百个候选特征,其中真正有用的只有少数几个,而且很弱。在固定设计、条件零均值误差等假设下,满秩OLS系数无偏,但可有很大的方差;当特征多、样本有效信息少(第37章:重叠标签、低信噪比)时,这些方差直接变成样本外误差。Gu、Kelly、Xiu(2020)在美国个股月度数据上报告:用全部特征的 OLS 样本外 R 2 R^2 R 2 − 3.46 % -3.46\% − 3.46%
第8章已经在单序列上演示了训练内的正则化选择。本章补上三件事:目标函数的精确缩放(不同软件的 α \alpha α
3. 直觉
一个只有两个特征、四个观测的例子:
X = ( 1 1 1 − 1 − 1 1 − 1 − 1 ) , y = ( 3 1 − 1 − 3 ) .
X=\begin{pmatrix}1&1\\1&-1\\-1&1\\-1&-1\end{pmatrix},\qquad y=\begin{pmatrix}3\\1\\-1\\-3\end{pmatrix}.
X = 1 1 − 1 − 1 1 − 1 1 − 1 , y = 3 1 − 1 − 3 . 两列均值为 0、总体标准差为 1、彼此正交,X ⊤ X = 4 I X^\top X=4I X ⊤ X = 4 I ( 2 , 1 ) (2,1) ( 2 , 1 )
Ridge 把两个系数按同一比例往 0 拉:α = 4 \alpha=4 α = 4 ( 1 , 0.5 ) (1,0.5) ( 1 , 0.5 )
Lasso 把两个系数各减去同一个量,减到 0 就停:α = 1.5 \alpha=1.5 α = 1.5 ( 0.5 , 0 ) (0.5,0) ( 0.5 , 0 )
Elastic Net 先减再按比例拉:α = 1 \alpha=1 α = 1 ( 1 , 1 / 3 ) (1,1/3) ( 1 , 1/3 )
“按比例拉”与“减去固定量”是 L2 与 L1 惩罚的区别,第6节推导。简化的边界:真实特征不正交,系数之间互相影响,闭式解只在正交时这么简单;但这个例子里每个数都能用 scikit-learn 原样复现(第9节)。
4. 数学基础
符号
含义
维度/单位
n n n 训练样本行数
—
X ∈ R n × p X\in\mathbb R^{n\times p} X ∈ R n × p 已在训练集上中心化并标准化的特征矩阵
每列单位为“训练集 1 个标准差”
y ∈ R n y\in\mathbb R^n y ∈ R n 已中心化的标签
小数收益
w ∈ R p w\in\mathbb R^p w ∈ R p 系数
每单位标准化特征对应的收益(小数)
α ≥ 0 \alpha\ge0 α ≥ 0 正则强度(scikit-learn 记号)
依估计器而异,见下
ρ ∈ ( 0 , 1 ) \rho\in(0,1) ρ ∈ ( 0 , 1 ) Elastic Net 的 L1 比例(scikit-learn 的 l1_ratio)
—
X = U D V ⊤ X=UDV^\top X = U D V ⊤ 奇异值分解,d j d_j d j
—
z = X ⊤ y / n z=X^\top y/n z = X ⊤ y / n 正交设计下每个特征与标签的样本协方差
收益单位
截距:先在训练集上把 X X X y y y fit_intercept=True 时做同样的事。先修:第8章 OLS 正规方程与投影,第9章凸优化中的次梯度(Lasso 推导用到)。
5. 正式定义
OLS(普通最小二乘)。 w ^ OLS = arg min w ∥ y − X w ∥ 2 2 \hat w^{\text{OLS}}=\arg\min_w\|y-Xw\|_2^2 w ^ OLS = arg min w ∥ y − X w ∥ 2 2 X ⊤ X X^\top X X ⊤ X
Ridge(岭回归)。 scikit-learn 1.9.1:
w ^ R = arg min w ∥ y − X w ∥ 2 2 + α ∥ w ∥ 2 2 .
\hat w^{\text{R}}=\arg\min_w\;\|y-Xw\|_2^2+\alpha\|w\|_2^2 .
w ^ R = arg w min ∥ y − X w ∥ 2 2 + α ∥ w ∥ 2 2 . 目标中的残差平方和不除以 n n n X ⊤ X X^\top X X ⊤ X p p p
Lasso(最小绝对收缩与选择算子)。 scikit-learn 1.9.1:
w ^ L = arg min w 1 2 n ∥ y − X w ∥ 2 2 + α ∥ w ∥ 1 .
\hat w^{\text{L}}=\arg\min_w\;\frac1{2n}\|y-Xw\|_2^2+\alpha\|w\|_1 .
w ^ L = arg w min 2 n 1 ∥ y − X w ∥ 2 2 + α ∥ w ∥ 1 . 残差平方和除以 2 n 2n 2 n
Elastic Net(弹性网)。 scikit-learn 1.9.1:
w ^ EN = arg min w 1 2 n ∥ y − X w ∥ 2 2 + α ρ ∥ w ∥ 1 + α ( 1 − ρ ) 2 ∥ w ∥ 2 2 .
\hat w^{\text{EN}}=\arg\min_w\;\frac1{2n}\|y-Xw\|_2^2+\alpha\rho\|w\|_1+\frac{\alpha(1-\rho)}2\|w\|_2^2 .
w ^ EN = arg w min 2 n 1 ∥ y − X w ∥ 2 2 + α ρ ∥ w ∥ 1 + 2 α ( 1 − ρ ) ∥ w ∥ 2 2 . 它同时有选择(L1)和稳定(L2)作用,用于特征相关、又希望稀疏的情形。
缩放约定的后果。 把 Ridge 写成与 Lasso 同样的形式:∥ y − X w ∥ 2 + α ∥ w ∥ 2 = 2 n [ 1 2 n ∥ y − X w ∥ 2 + α 2 n ∥ w ∥ 2 ] \|y-Xw\|^2+\alpha\|w\|^2=2n\big[\frac1{2n}\|y-Xw\|^2+\frac{\alpha}{2n}\|w\|^2\big] ∥ y − X w ∥ 2 + α ∥ w ∥ 2 = 2 n [ 2 n 1 ∥ y − X w ∥ 2 + 2 n α ∥ w ∥ 2 ] 1 2 n ∥ y − X w ∥ 2 + λ 2 ∥ w ∥ 2 \frac1{2n}\|y-Xw\|^2+\frac\lambda2\|w\|^2 2 n 1 ∥ y − X w ∥ 2 + 2 λ ∥ w ∥ 2 λ / 2 = α / ( 2 n ) \lambda/2=\alpha/(2n) λ /2 = α / ( 2 n ) λ = α / n \lambda=\alpha/n λ = α / n α = 1 \alpha=1 α = 1 n n n α \alpha α
正则化路径(regularization path)。 把 α \alpha α α \alpha α α \alpha α α \alpha α
标准化(scaling)。 用训练集的均值 μ j \mu_j μ j s j s_j s j ( x j − μ j ) / s j (x_j-\mu_j)/s_j ( x j − μ j ) / s j ∥ w ∥ \|w\| ∥ w ∥ μ , s \mu,s μ , s
尺度怎样进入惩罚:把系数换回原单位
令原特征为x x x b b b S S S u = S − 1 ( x − μ ) u=S^{-1}(x-\mu) u = S − 1 ( x − μ ) w w w w ⊤ u = b ⊤ ( x − μ ) w^\top u=b^\top(x-\mu) w ⊤ u = b ⊤ ( x − μ ) b = S − 1 w b=S^{-1}w b = S − 1 w w = S b w=Sb w = S b
∥ w ∥ 2 2 = ∑ j s j 2 b j 2 , ∥ w ∥ 1 = ∑ j s j ∣ b j ∣ .
\|w\|_2^2=\sum_j s_j^2b_j^2,\qquad
\|w\|_1=\sum_j s_j|b_j|.
∥ w ∥ 2 2 = j ∑ s j 2 b j 2 , ∥ w ∥ 1 = j ∑ s j ∣ b j ∣. 它惩罚的是“变动一个训练标准差的预测贡献”,不是把不同单位的原斜率直接等额相加。若不标准化,把x 2 x_2 x 2 b 2 b_2 b 2 1 / 10 4 1/10^4 1/1 0 4 1 / 100 1/100 1/100 s 2 s_2 s 2 s 2 b 2 s_2b_2 s 2 b 2 s j = 0 s_j=0 s j = 0
还要检查标签单位。本章y y y x x x w w w α \alpha α α \alpha α α \alpha α y y y c > 0 c>0 c > 0 c c c α \alpha α α ′ = c α \alpha'=c\alpha α ′ = c α α ′ ρ ′ = c α ρ \alpha'\rho'=c\alpha\rho α ′ ρ ′ = c α ρ α ′ ( 1 − ρ ′ ) = α ( 1 − ρ ) \alpha'(1-\rho')=\alpha(1-\rho) α ′ ( 1 − ρ ′ ) = α ( 1 − ρ )
α ′ = α [ ( 1 − ρ ) + c ρ ] , ρ ′ = c ρ ( 1 − ρ ) + c ρ .
\alpha'=\alpha[(1-\rho)+c\rho],\qquad
\rho'=\frac{c\rho}{(1-\rho)+c\rho}.
α ′ = α [( 1 − ρ ) + c ρ ] , ρ ′ = ( 1 − ρ ) + c ρ c ρ . 推导只需把变换后的目标除以c 2 c^2 c 2 1 / c 1/c 1/ c ρ \rho ρ α \alpha α
偏差—方差(bias-variance)。 估计量 w ^ \hat w w ^ E ∥ w ^ − w ∥ 2 = ∥ E w ^ − w ∥ 2 + tr Var ( w ^ ) E\|\hat w-w\|^2=\|E\hat w-w\|^2+\operatorname{tr}\operatorname{Var}(\hat w) E ∥ w ^ − w ∥ 2 = ∥ E w ^ − w ∥ 2 + tr Var ( w ^ )
嵌套调参(nested tuning)。 α \alpha α ρ \rho ρ
基准(baseline)。 零预测与训练均值预测,用同一折、同一组合规则和同一成本评价(第37章)。
稀疏(sparsity)与共线性(collinearity)。 稀疏指许多系数恰好为 0;共线性指特征之间高度相关,X ⊤ X X^\top X X ⊤ X
6. 推导
6.1 OLS 与 Ridge 的闭式解
对 Ridge 目标求梯度并令其为 0:
∇ w ( ∥ y − X w ∥ 2 + α ∥ w ∥ 2 ) = − 2 X ⊤ ( y − X w ) + 2 α w = 0 ⇒ w ^ R = ( X ⊤ X + α I ) − 1 X ⊤ y .
\nabla_w\big(\|y-Xw\|^2+\alpha\|w\|^2\big)=-2X^\top(y-Xw)+2\alpha w=0\;\Rightarrow\;\hat w^{\text{R}}=(X^\top X+\alpha I)^{-1}X^\top y .
∇ w ( ∥ y − X w ∥ 2 + α ∥ w ∥ 2 ) = − 2 X ⊤ ( y − X w ) + 2 α w = 0 ⇒ w ^ R = ( X ⊤ X + α I ) − 1 X ⊤ y . α > 0 \alpha>0 α > 0 X ⊤ X + α I X^\top X+\alpha I X ⊤ X + α I p > n p>n p > n α = 0 \alpha=0 α = 0
正交设计 (X ⊤ X = n I X^\top X=nI X ⊤ X = n I w ^ OLS = X ⊤ y / n = z \hat w^{\text{OLS}}=X^\top y/n=z w ^ OLS = X ⊤ y / n = z w ^ R = X ⊤ y / ( n + α ) = n n + α z \hat w^{\text{R}}=X^\top y/(n+\alpha)=\frac{n}{n+\alpha}z w ^ R = X ⊤ y / ( n + α ) = n + α n z n / ( n + α ) n/(n+\alpha) n / ( n + α ) n = 4 n=4 n = 4 z = ( 2 , 1 ) z=(2,1) z = ( 2 , 1 ) α = 4 \alpha=4 α = 4 1 / 2 1/2 1/2 ( 1 , 0.5 ) (1,0.5) ( 1 , 0.5 )
一般设计的奇异值形式 :代入 X = U D V ⊤ X=UDV^\top X = U D V ⊤
X w ^ R = ∑ j u j d j 2 d j 2 + α u j ⊤ y .
X\hat w^{\text{R}}=\sum_{j}u_j\frac{d_j^2}{d_j^2+\alpha}u_j^\top y .
X w ^ R = j ∑ u j d j 2 + α d j 2 u j ⊤ y . 推导:若用秩 r r r X = U r D r V r ⊤ X=U_rD_rV_r^\top X = U r D r V r ⊤ V r V_r V r α > 0 \alpha>0 α > 0
( X ⊤ X + α I ) − 1 = V r ( D r 2 + α I r ) − 1 V r ⊤ + I − V r V r ⊤ α .
(X^\top X+\alpha I)^{-1}=V_r(D_r^2+\alpha I_r)^{-1}V_r^\top+\frac{I-V_rV_r^\top}{\alpha}.
( X ⊤ X + α I ) − 1 = V r ( D r 2 + α I r ) − 1 V r ⊤ + α I − V r V r ⊤ . 后一项作用于零空间;左乘 X X X U r D r ( D r 2 + α I r ) − 1 D r U r ⊤ U_rD_r(D_r^2+\alpha I_r)^{-1}D_rU_r^\top U r D r ( D r 2 + α I r ) − 1 D r U r ⊤ u j u_j u j d j 2 / ( d j 2 + α ) d_j^2/(d_j^2+\alpha) d j 2 / ( d j 2 + α ) d j d_j d j d j d_j d j
6.2 Ridge 单系数的偏差、方差与最优强度
假设 :一个标准化特征,x ⊤ x = n x^\top x=n x ⊤ x = n ∑ x = 0 \sum x=0 ∑ x = 0 y = w x + ε y=wx+\varepsilon y = w x + ε ε i \varepsilon_i ε i σ 2 \sigma^2 σ 2
w ^ = x ⊤ y n + α = n w + x ⊤ ε n + α .
\hat w=\frac{x^\top y}{n+\alpha}=\frac{nw+x^\top\varepsilon}{n+\alpha}.
w ^ = n + α x ⊤ y = n + α n w + x ⊤ ε . 期望:E w ^ = n n + α w E\hat w=\frac{n}{n+\alpha}w E w ^ = n + α n w − α n + α w -\frac{\alpha}{n+\alpha}w − n + α α w Var ( x ⊤ ε ) = σ 2 x ⊤ x = n σ 2 \operatorname{Var}(x^\top\varepsilon)=\sigma^2x^\top x=n\sigma^2 Var ( x ⊤ ε ) = σ 2 x ⊤ x = n σ 2 Var w ^ = n σ 2 ( n + α ) 2 \operatorname{Var}\hat w=\frac{n\sigma^2}{(n+\alpha)^2} Var w ^ = ( n + α ) 2 n σ 2
M S E ( α ) = α 2 w 2 + n σ 2 ( n + α ) 2 .
\mathrm{MSE}(\alpha)=\frac{\alpha^2w^2+n\sigma^2}{(n+\alpha)^2}.
MSE ( α ) = ( n + α ) 2 α 2 w 2 + n σ 2 . 对 α \alpha α 2 α w 2 ( n + α ) 2 − 2 ( n + α ) ( α 2 w 2 + n σ 2 ) 2\alpha w^2(n+\alpha)^2-2(n+\alpha)(\alpha^2w^2+n\sigma^2) 2 α w 2 ( n + α ) 2 − 2 ( n + α ) ( α 2 w 2 + n σ 2 ) 2 ( n + α ) 2(n+\alpha) 2 ( n + α ) α w 2 ( n + α ) − α 2 w 2 − n σ 2 = 0 \alpha w^2(n+\alpha)-\alpha^2w^2-n\sigma^2=0 α w 2 ( n + α ) − α 2 w 2 − n σ 2 = 0 n α w 2 = n σ 2 n\alpha w^2=n\sigma^2 n α w 2 = n σ 2
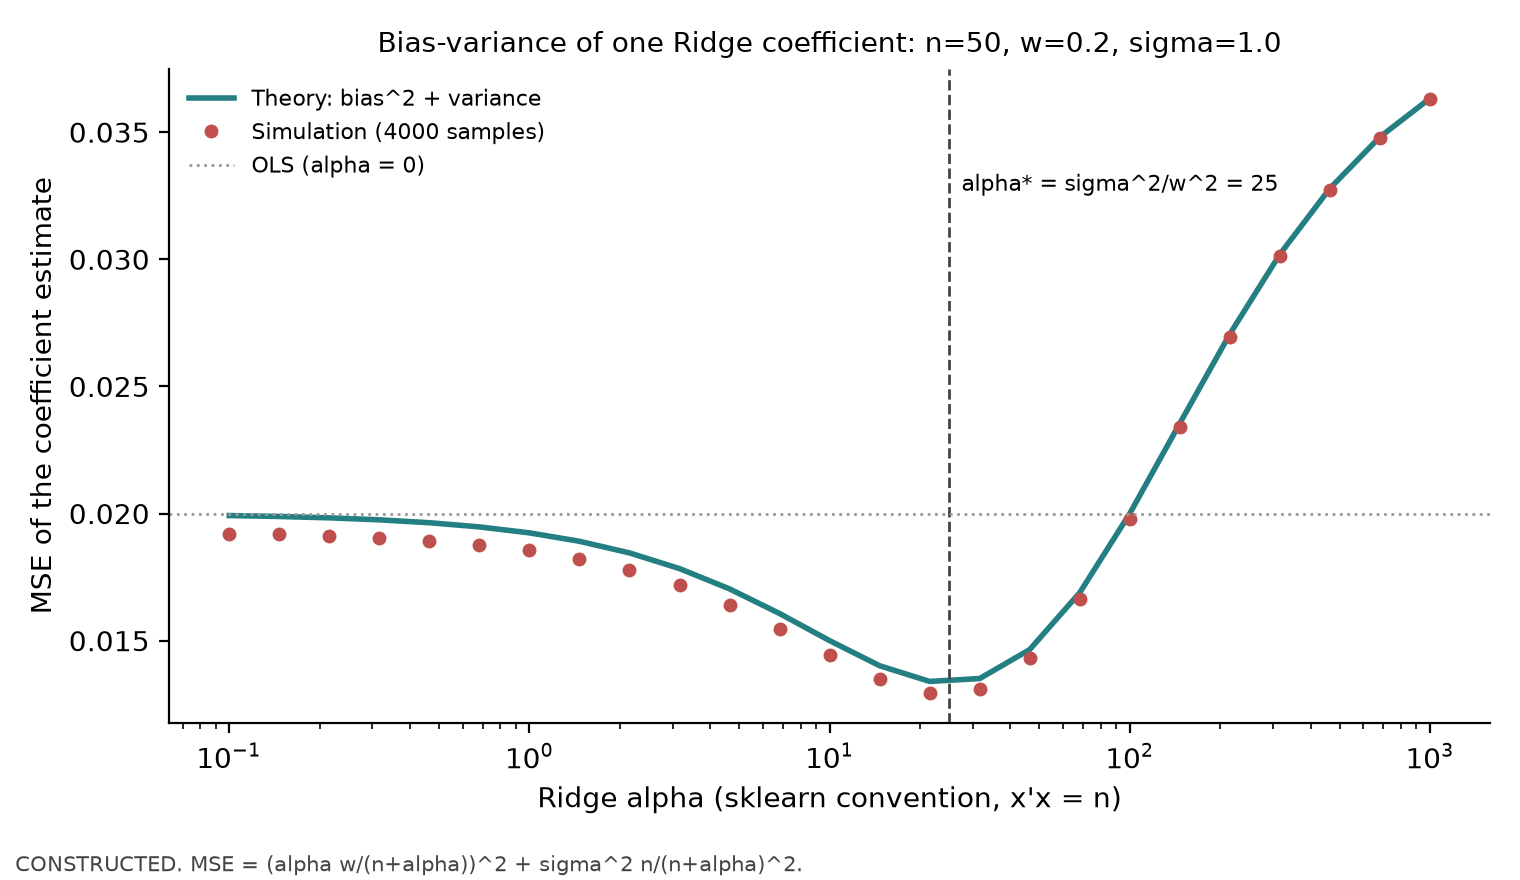
α ∗ = σ 2 w 2 , M S E ( α ∗ ) = σ 2 n + α ∗ < σ 2 n = M S E ( 0 ) .
\alpha^\ast=\frac{\sigma^2}{w^2},\qquad \mathrm{MSE}(\alpha^\ast)=\frac{\sigma^2}{n+\alpha^\ast}<\frac{\sigma^2}{n}=\mathrm{MSE}(0).
α ∗ = w 2 σ 2 , MSE ( α ∗ ) = n + α ∗ σ 2 < n σ 2 = MSE ( 0 ) . 最后一步:把 α ∗ w 2 = σ 2 \alpha^\ast w^2=\sigma^2 α ∗ w 2 = σ 2 α ∗ σ 2 + n σ 2 = σ 2 ( n + α ∗ ) \alpha^\ast\sigma^2+n\sigma^2=\sigma^2(n+\alpha^\ast) α ∗ σ 2 + n σ 2 = σ 2 ( n + α ∗ )
此最优式与严格改进要求 w ≠ 0 , σ 2 > 0 w\ne0,\sigma^2>0 w = 0 , σ 2 > 0 w = 0 , σ 2 > 0 w=0,\sigma^2>0 w = 0 , σ 2 > 0 n σ 2 / ( n + α ) 2 n\sigma^2/(n+\alpha)^2 n σ 2 / ( n + α ) 2 σ 2 / w 2 \sigma^2/w^2 σ 2 / w 2 α = 0 \alpha=0 α = 0
金融含义 :信号越弱(w w w σ \sigma σ α ∗ \alpha^\ast α ∗ n n n n n n 不能用的情形 :w w w σ \sigma σ α ∗ \alpha^\ast α ∗
6.3 Lasso 的软阈值
假设 :正交设计 X ⊤ X = n I X^\top X=nI X ⊤ X = n I 1 2 n \frac1{2n} 2 n 1
展开目标:1 2 n ∥ y − X w ∥ 2 = 1 2 n y ⊤ y − z ⊤ w + 1 2 ∥ w ∥ 2 \frac1{2n}\|y-Xw\|^2=\frac1{2n}y^\top y-z^\top w+\frac12\|w\|^2 2 n 1 ∥ y − X w ∥ 2 = 2 n 1 y ⊤ y − z ⊤ w + 2 1 ∥ w ∥ 2 X ⊤ X = n I X^\top X=nI X ⊤ X = n I z = X ⊤ y / n z=X^\top y/n z = X ⊤ y / n
min w j 1 2 w j 2 − z j w j + α ∣ w j ∣ .
\min_{w_j}\;\tfrac12w_j^2-z_jw_j+\alpha|w_j| .
w j min 2 1 w j 2 − z j w j + α ∣ w j ∣. 次梯度条件 0 ∈ w j − z j + α ∂ ∣ w j ∣ 0\in w_j-z_j+\alpha\,\partial|w_j| 0 ∈ w j − z j + α ∂ ∣ w j ∣ w j > 0 w_j>0 w j > 0 w j = z j − α w_j=z_j-\alpha w j = z j − α z j > α z_j>\alpha z j > α w j < 0 w_j<0 w j < 0 w j = z j + α w_j=z_j+\alpha w j = z j + α z j < − α z_j<-\alpha z j < − α w j = 0 w_j=0 w j = 0 ∣ z j ∣ ≤ α |z_j|\le\alpha ∣ z j ∣ ≤ α
w ^ j L = S ( z j , α ) = sign ( z j ) ( ∣ z j ∣ − α ) + .
\hat w^{\text{L}}_j=S(z_j,\alpha)=\operatorname{sign}(z_j)\,(|z_j|-\alpha)_+ .
w ^ j L = S ( z j , α ) = sign ( z j ) ( ∣ z j ∣ − α ) + . 第3节例子:z = ( 2 , 1 ) z=(2,1) z = ( 2 , 1 ) α = 1.5 \alpha=1.5 α = 1.5 S ( 2 , 1.5 ) = 0.5 S(2,1.5)=0.5 S ( 2 , 1.5 ) = 0.5 S ( 1 , 1.5 ) = 0 S(1,1.5)=0 S ( 1 , 1.5 ) = 0
6.4 Elastic Net 的正交解
同样展开,每个坐标
min w j 1 2 w j 2 − z j w j + α ρ ∣ w j ∣ + α ( 1 − ρ ) 2 w j 2 = min w j 1 + α ( 1 − ρ ) 2 w j 2 − z j w j + α ρ ∣ w j ∣ .
\min_{w_j}\;\tfrac12w_j^2-z_jw_j+\alpha\rho|w_j|+\tfrac{\alpha(1-\rho)}2w_j^2
=\min_{w_j}\;\tfrac{1+\alpha(1-\rho)}2w_j^2-z_jw_j+\alpha\rho|w_j| .
w j min 2 1 w j 2 − z j w j + α ρ ∣ w j ∣ + 2 α ( 1 − ρ ) w j 2 = w j min 2 1 + α ( 1 − ρ ) w j 2 − z j w j + α ρ ∣ w j ∣. 与 6.3 节同样的次梯度论证(二次项系数换成 1 + α ( 1 − ρ ) 1+\alpha(1-\rho) 1 + α ( 1 − ρ )
w ^ j EN = S ( z j , α ρ ) 1 + α ( 1 − ρ ) .
\hat w^{\text{EN}}_j=\frac{S(z_j,\alpha\rho)}{1+\alpha(1-\rho)} .
w ^ j EN = 1 + α ( 1 − ρ ) S ( z j , α ρ ) . 先软阈值、再按比例收缩。例子:α = 1 \alpha=1 α = 1 ρ = 0.5 \rho=0.5 ρ = 0.5 S ( z , 0.5 ) / 1.5 = ( 1.5 / 1.5 , 0.5 / 1.5 ) = ( 1 , 1 / 3 ) S(z,0.5)/1.5=(1.5/1.5,\;0.5/1.5)=(1,1/3) S ( z , 0.5 ) /1.5 = ( 1.5/1.5 , 0.5/1.5 ) = ( 1 , 1/3 )
6.5 几何:为什么 L1 产生零系数
Lasso 与约束形式等价:在 ∥ w ∥ 1 ≤ t \|w\|_1\le t ∥ w ∥ 1 ≤ t t t t α \alpha α z j = 0 z_j=0 z j = 0 ∣ z j ∣ ≤ α |z_j|\le\alpha ∣ z j ∣ ≤ α
6.6 共线性:OLS、Ridge、Lasso 各自怎么做
假设 :两个标准化特征,样本相关系数 r r r X ⊤ X / n = ( 1 r r 1 ) X^\top X/n=\begin{pmatrix}1&r\\r&1\end{pmatrix} X ⊤ X / n = ( 1 r r 1 )
OLS 方差:Var ( w ^ ) = σ 2 ( X ⊤ X ) − 1 = σ 2 n ( 1 − r 2 ) ( 1 − r − r 1 ) \operatorname{Var}(\hat w)=\sigma^2(X^\top X)^{-1}=\frac{\sigma^2}{n(1-r^2)}\begin{pmatrix}1&-r\\-r&1\end{pmatrix} Var ( w ^ ) = σ 2 ( X ⊤ X ) − 1 = n ( 1 − r 2 ) σ 2 ( 1 − r − r 1 ) 1 / ( 1 − r 2 ) 1/(1-r^2) 1/ ( 1 − r 2 ) r = 0.99 r=0.99 r = 0.99 = 50.25 =50.25 = 50.25 r ≈ + 1 r\approx+1 r ≈ + 1 r ≈ − 1 r\approx-1 r ≈ − 1 − r -r − r w ^ 1 + w ^ 2 \hat w_1+\hat w_2 w ^ 1 + w ^ 2
Ridge:X ⊤ X X^\top X X ⊤ X n ( 1 + r ) n(1+r) n ( 1 + r ) n ( 1 − r ) n(1-r) n ( 1 − r ) ( 1 , 1 ) / 2 (1,1)/\sqrt2 ( 1 , 1 ) / 2 ( 1 , − 1 ) / 2 (1,-1)/\sqrt2 ( 1 , − 1 ) / 2 n ( 1 + r ) n ( 1 + r ) + α \frac{n(1+r)}{n(1+r)+\alpha} n ( 1 + r ) + α n ( 1 + r ) n ( 1 − r ) n ( 1 − r ) + α \frac{n(1-r)}{n(1-r)+\alpha} n ( 1 − r ) + α n ( 1 − r ) r = 1 r=1 r = 1
Lasso:固定 ( w 1 , w 2 ) (w_1,w_2) ( w 1 , w 2 ) ∣ w 1 ∣ + ∣ w 2 ∣ |w_1|+|w_2| ∣ w 1 ∣ + ∣ w 2 ∣ r = 1 r=1 r = 1 X ⊤ X / n X^\top X/n X ⊤ X / n y = X 1 + X 2 y=X_1+X_2 y = X 1 + X 2 ( 1 , 1 ) (1,1) ( 1 , 1 ) ( 2 , 0 ) (2,0) ( 2 , 0 )
6.7 当 α \alpha α
当 α \alpha α X ⊤ X X^\top X X ⊤ X α → ∞ \alpha\to\infty α → ∞ ( X ⊤ X + α I ) − 1 ≈ I / α (X^\top X+\alpha I)^{-1}\approx I/\alpha ( X ⊤ X + α I ) − 1 ≈ I / α w ^ R ≈ X ⊤ y / α \hat w^{\text{R}}\approx X^\top y/\alpha w ^ R ≈ X ⊤ y / α y ^ = y ˉ + x ⊤ X ⊤ y / α \hat y=\bar y+x^\top X^\top y/\alpha y ^ = y ˉ + x ⊤ X ⊤ y / α 水平 趋于训练均值,截面差异 的方向趋于 X ⊤ y X^\top y X ⊤ y 1 / α 1/\alpha 1/ α α = 10 5 \alpha=10^5 α = 1 0 5 10 7 10^7 1 0 7 y = ( − 0.01 , 0 , 0.01 ) y=(-0.01,0,0.01) y = ( − 0.01 , 0 , 0.01 ) p = ( − 0.02 , 0 , 0.02 ) p=(-0.02,0,0.02) p = ( − 0.02 , 0 , 0.02 ) a p ap a p a > 0 a>0 a > 0 2 ( 0.01 − 0.02 a ) 2 2(0.01-0.02a)^2 2 ( 0.01 − 0.02 a ) 2 a = 0.5 a=0.5 a = 0.5 a = 1 a=1 a = 1 α \alpha α
7. 金融解释
系数不是因果效应。 标准化系数 w j w_j w j j j j w j w_j w j α \alpha α
为什么零系数不等于“无用”。 Lasso 把系数压到 0,可能因为特征真的无关,也可能因为它和另一个被选中的特征高度相关,或者信号弱于当前 α \alpha α
正则化与组合。 美元中性只消掉共同水平,实际连续权重还看去均值预测的相对幅度。共同正比例缩放会在L1归一后抵消;一般Ridge不是给全部原系数统一乘一个因子,可能改变排序与权重;Lasso 删除特征,会改变排序;OLS 在噪声特征上的大系数会把噪声加进排序。所以预测层的 R OS 2 R^2_{\text{OS}} R OS 2
成本把差距拉开。 每 5 日调仓的组合年换手约 14–24 倍(第8.4节)。单边 10 个基点的成本每年吃掉约 1.4%–2.4% 的收益。换手低的模型在成本后占便宜。
8. Numerical Example
8.1 手算四个估计量(教学构造)
X X X y y y n = 4 n=4 n = 4 X ⊤ y = ( 8 , 4 ) X^\top y=(8,4) X ⊤ y = ( 8 , 4 ) z = ( 2 , 1 ) z=(2,1) z = ( 2 , 1 )
估计量
公式
结果
OLS
z z z ( 2 , 1 ) (2,\;1) ( 2 , 1 )
Ridge,α = 4 \alpha=4 α = 4
n n + α z = 4 8 z \frac{n}{n+\alpha}z=\frac48z n + α n z = 8 4 z ( 1 , 0.5 ) (1,\;0.5) ( 1 , 0.5 )
Lasso,α = 1.5 \alpha=1.5 α = 1.5
S ( z , 1.5 ) S(z,1.5) S ( z , 1.5 ) ( 0.5 , 0 ) (0.5,\;0) ( 0.5 , 0 )
Elastic Net,α = 1 , ρ = 0.5 \alpha=1,\rho=0.5 α = 1 , ρ = 0.5
S ( z , 0.5 ) / ( 1 + 0.5 ) S(z,0.5)/(1+0.5) S ( z , 0.5 ) / ( 1 + 0.5 ) ( 1 , 0.3333 ) (1,\;0.3333) ( 1 , 0.3333 )
scikit-learn 1.9.1 拟合结果与闭式解的最大差 2.2 × 10 − 16 2.2\times10^{-16} 2.2 × 1 0 − 16 X X X StandardScaler 是恒等变换。
8.2 偏差与方差
n = 50 n=50 n = 50 w = 0.2 w=0.2 w = 0.2 σ = 1 \sigma=1 σ = 1 α ∗ = σ 2 / w 2 = 25 \alpha^\ast=\sigma^2/w^2=25 α ∗ = σ 2 / w 2 = 25 M S E = σ 2 / n = 0.02 \mathrm{MSE}=\sigma^2/n=0.02 MSE = σ 2 / n = 0.02 α ∗ \alpha^\ast α ∗ − 25 75 × 0.2 = − 0.0667 -\frac{25}{75}\times0.2=-0.0667 − 75 25 × 0.2 = − 0.0667 50 / 75 2 = 0.008889 50/75^2=0.008889 50/7 5 2 = 0.008889
8.3 共线性模拟
n = 40 n=40 n = 40 ( 1 , 1 ) (1,1) ( 1 , 1 )
方法
系数均值
系数标准差
一个系数为 0 的比例
出现负号的比例
OLS
(0.967, 0.982)
(1.211, 1.216)
0
41.8%
Ridge,α = 10 \alpha=10 α = 10
(0.866, 0.865)
(0.127, 0.126)
0
0
Lasso,α = 0.1 \alpha=0.1 α = 0.1
(0.932, 0.920)
(0.745, 0.751)
44.8%
0
VIF = 1 / ( 1 − 0.99 2 ) = 50.25 =1/(1-0.99^2)=50.25 = 1/ ( 1 − 0.9 9 2 ) = 50.25
8.4 噪声特征多于有效信号的面板
构造面板(种子 3904):40 只资产、1,260 日;3 个真实特征(日预期收益载荷 0.04%、0.02%、0.01% 每单位)、40 个噪声特征、3 个价格特征,共 46 个特征。ℓ = 1 \ell=1 ℓ = 1 h = 5 h=5 h = 5 α ∈ { 10 2 , … , 10 7 } \alpha\in\{10^2,\dots,10^7\} α ∈ { 1 0 2 , … , 1 0 7 } α ∈ { 3 × 10 − 3 , 10 − 3 , 3 × 10 − 4 , 10 − 4 , 3 × 10 − 5 } \alpha\in\{3\times10^{-3},10^{-3},3\times10^{-4},10^{-4},3\times10^{-5}\} α ∈ { 3 × 1 0 − 3 , 1 0 − 3 , 3 × 1 0 − 4 , 1 0 − 4 , 3 × 1 0 − 5 } α ∈ { 3 × 10 − 3 , 10 − 3 , 3 × 10 − 4 , 10 − 4 } × ρ ∈ { 0.2 , 0.5 , 0.8 } \alpha\in\{3\times10^{-3},10^{-3},3\times10^{-4},10^{-4}\}\times\rho\in\{0.2,0.5,0.8\} α ∈ { 3 × 1 0 − 3 , 1 0 − 3 , 3 × 1 0 − 4 , 1 0 − 4 } × ρ ∈ { 0.2 , 0.5 , 0.8 }
模型
R OS 2 R^2_{\text{OS}} R OS 2 相对训练均值
IC 均值(自身有效日)
自身有效日 / 候选标签日
成本前总收益 / 夏普
成本后总收益 / 夏普
年换手
成本后最大回撤
零预测
0
+0.070%
—
0/750
0 / —
0 / —
0
0
训练均值
−0.070%
0
—
0/750
0 / —
0 / —
0
0
OLS
−0.699%
−0.629%
0.0316
750/750
+34.51% / 1.62
+25.08% / 1.23
24.2
−4.43%
Ridge
−0.001%
+0.069%
0.0349
750/750
+37.31% / 1.71
+27.67% / 1.33
24.2
−5.41%
Lasso
−0.037%
+0.033%
0.0380
441/750
+20.83% / 1.37
+15.91% / 1.08
13.9
−4.18%
Elastic Net
+0.025%
+0.095%
0.0499
624/750
+41.49% / 2.08
+33.64% / 1.75
19.0
−5.27%
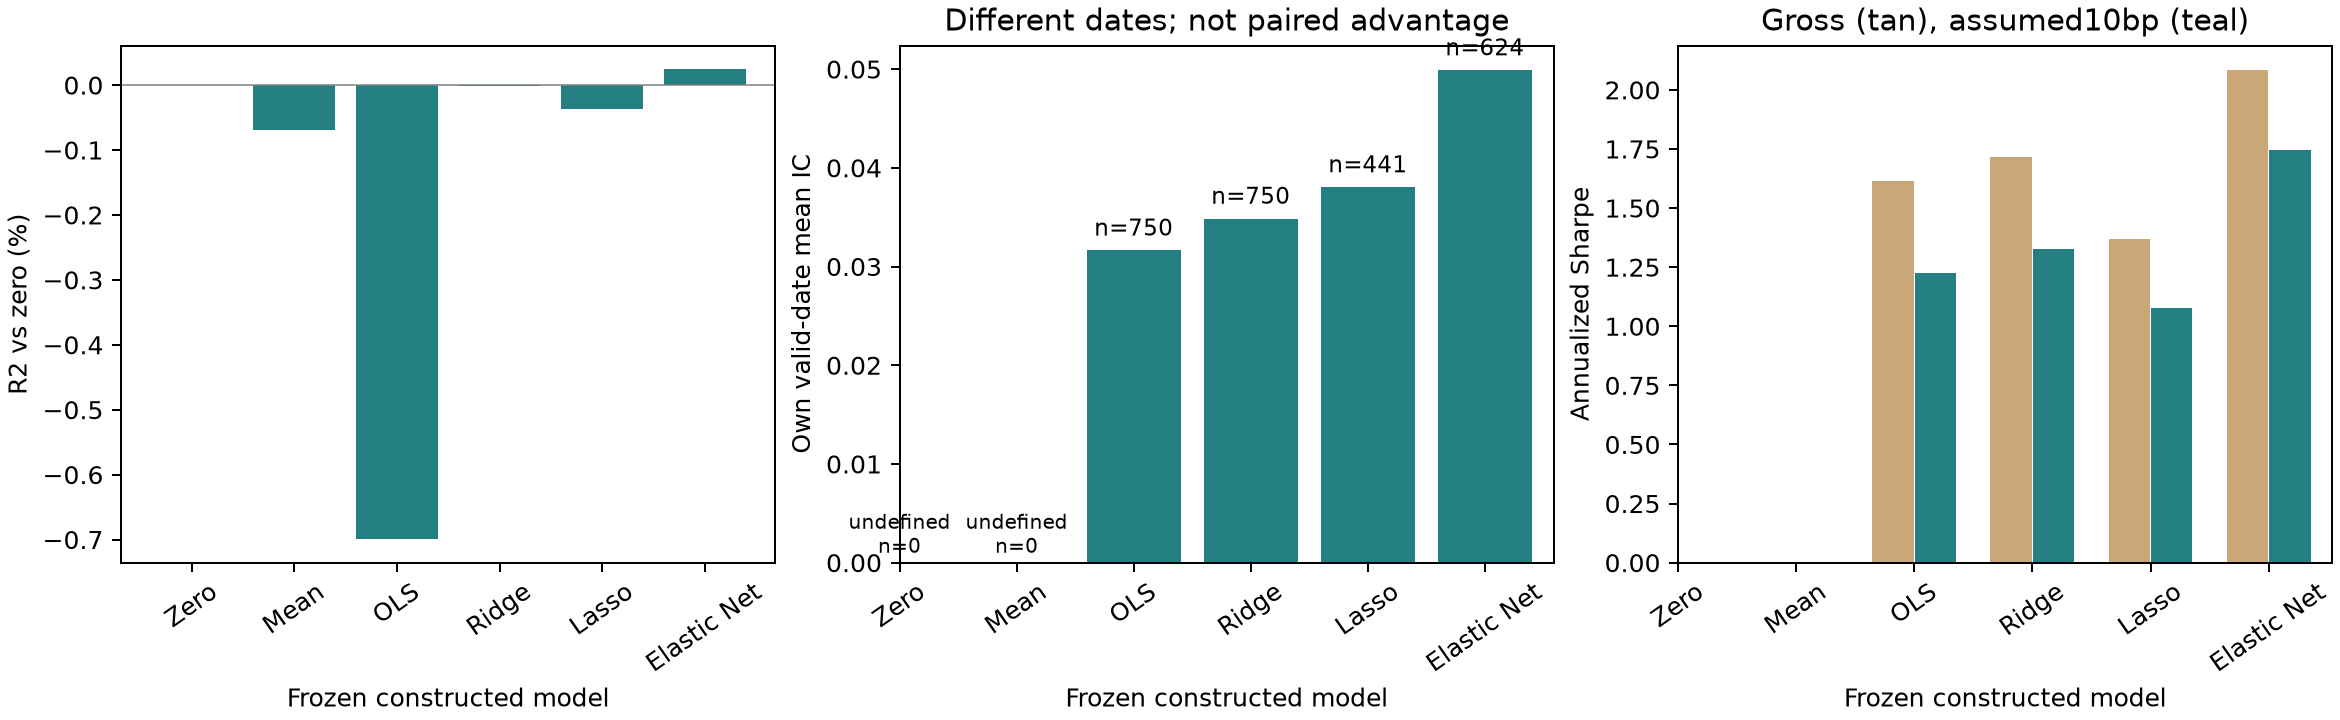
日期与推断展示(A8-R1) :上表IC是各模型自身有效日的冻结摘要均值,不是统一日期集上的排名。候选标签日期为750;Ridge有效750,Lasso441,Elastic Net624。零预测与训练均值是常数,IC未定义,不能以0充当观测IC。缺少第39章冻结逐行预测,Ridge–Lasso及Ridge–Elastic Net的共同日期、两方配对均值/均值差、逐日缺失成因均未能复算 ;有效日期少于750只能从摘要确认,不能由P06另一个实验的行数据补出。旧折记录支持部分Lasso折全零,但不等于已独立证明每个缺失日期的原因。
先问在哪些日期取平均。 对模型m m m D m = { d : I C m , d 有定义 } D_m=\{d:\mathrm{IC}_{m,d}\text{有定义}\} D m = { d : IC m , d 有定义 } ∣ D m ∣ − 1 ∑ d ∈ D m I C m , d |D_m|^{-1}\sum_{d\in D_m}\mathrm{IC}_{m,d} ∣ D m ∣ − 1 ∑ d ∈ D m IC m , d D m R = D m ∩ D R D_{mR}=D_m\cap D_R D m R = D m ∩ D R D m R D_{mR} D m R
Δ m R = 1 ∣ D m R ∣ ∑ d ∈ D m R ( I C m , d − I C R , d ) .
\Delta_{mR}=\frac1{|D_{mR}|}\sum_{d\in D_{mR}}(\mathrm{IC}_{m,d}-\mathrm{IC}_{R,d}).
Δ m R = ∣ D m R ∣ 1 d ∈ D m R ∑ ( IC m , d − IC R , d ) . 共同集为空时该量未定义。先做交集、再做差,才是在同一市场日期比较。一个独立构造小例:Ridge在日期1、2、3的IC为0.1、0.9、0.2,模型m只在日期1、3有IC 0.2、0.3。自身均值分别为0.4与0.25,表面上m较低;共同集为{1,3},Ridge均值0.15、m均值0.25,配对差反而为+0.10。这个例子只说明日期选择会改变问题,没有补出本章750/441/624日的任何历史配对数值。P06冻结行可展示P06自己的交集操作,不能充当本章的行记录。
旧共享实现先删除缺失IC,再按剩余观察下标计算NW(4)。第4个观察滞后可能跨越多于4个交易日,不能称为“四交易日HAC”。新候选撤下原表t值及其显著性判断,旧摘要/PDF仍保留历史t。此处没有新日历感知HAC估计,也不把未能复算写成已证明错误。若将来要重估,须另立协议及保有逐行冻结数据。
(测试期 750 个信号日、756 个日收益;夏普为年化、无风险利率 0。)
读表要点:
OLS 的 R OS 2 R^2_{\text{OS}} R OS 2 − 0.70 % -0.70\% − 0.70%
Ridge 的 R OS 2 R^2_{\text{OS}} R OS 2 α = 10 7 \alpha=10^7 α = 1 0 7 10 6 10^6 1 0 6 10 5 10^5 1 0 5
Lasso 在 12 个折中有 5 个折(第1–4、12 折)选出的 α = 3 × 10 − 3 \alpha=3\times10^{-3} α = 3 × 1 0 − 3
Elastic Net在该冻结账本上的成本后夏普为1.75;IC 0.050是自身624个有效日的描述均值,不支持未复算共同日期上的IC优势。这是本构造 下的结果:真实特征彼此独立、信号强度由作者设定。它不说明 Elastic Net 在真实数据上更好。
成本:单边 10 个基点使年化平均收益减少约 2.4 个百分点(OLS 10.08% → 7.65%),与年换手 24.2 倍 × 0.1% 一致。
9. Python Implementation
脚本 code/ch39_regularized_models.py;共享模块 quant_course.ml_pipeline(第38章),其中 backtest_predictions 把预测接到第29章账本 run_backtest(滞后成交、比例费用、N N N N + 1 N+1 N + 1
种子 3901–3904;输出 ch39_results.json 与三张图。频率日频;signal_time 为收盘 D k D_k D k D k + 1 D_{k+1} D k + 1 tests/test_ch39_regularized.py(手算估计量、α ∗ \alpha^\ast α ∗ tests/test_ml_pipeline.py。
手算例子:
import numpy as np
from sklearn.linear_model import ElasticNet, Lasso, LinearRegression, Ridge
X = np.array([[1.0 , 1.0 ], [1.0 , -1.0 ], [-1.0 , 1.0 ], [-1.0 , -1.0 ]])
y = np.array([3.0 , 1.0 , -1.0 , -3.0 ])
for name, model in [("ols" , LinearRegression()), ("ridge a=4" , Ridge(alpha=4.0 )),
("lasso a=1.5" , Lasso(alpha=1.5 )), ("enet a=1 r=0.5" , ElasticNet(alpha=1.0 , l1_ratio=0.5 ))]:
print (name, np.round (model.fit(X, y).coef_, 4 ))
预期:ols [2. 1.]、ridge a=4 [1. 0.5]、lasso a=1.5 [0.5 0. ]、enet a=1 r=0.5 [1. 0.3333]。
单系数偏差—方差:
import numpy as np
n, w, sigma = 50 , 0.2 , 1.0
mse = lambda a: (a * w / (n + a)) ** 2 + sigma ** 2 * n / (n + a) ** 2
grid = np.logspace(-1 , 3 , 4001 )
print (round (grid[np.argmin(mse(grid))], 2 ), round (mse(sigma ** 2 / w ** 2 ), 6 ), sigma ** 2 / n)
预期:25.0 0.013333 0.02。
10. Visualization
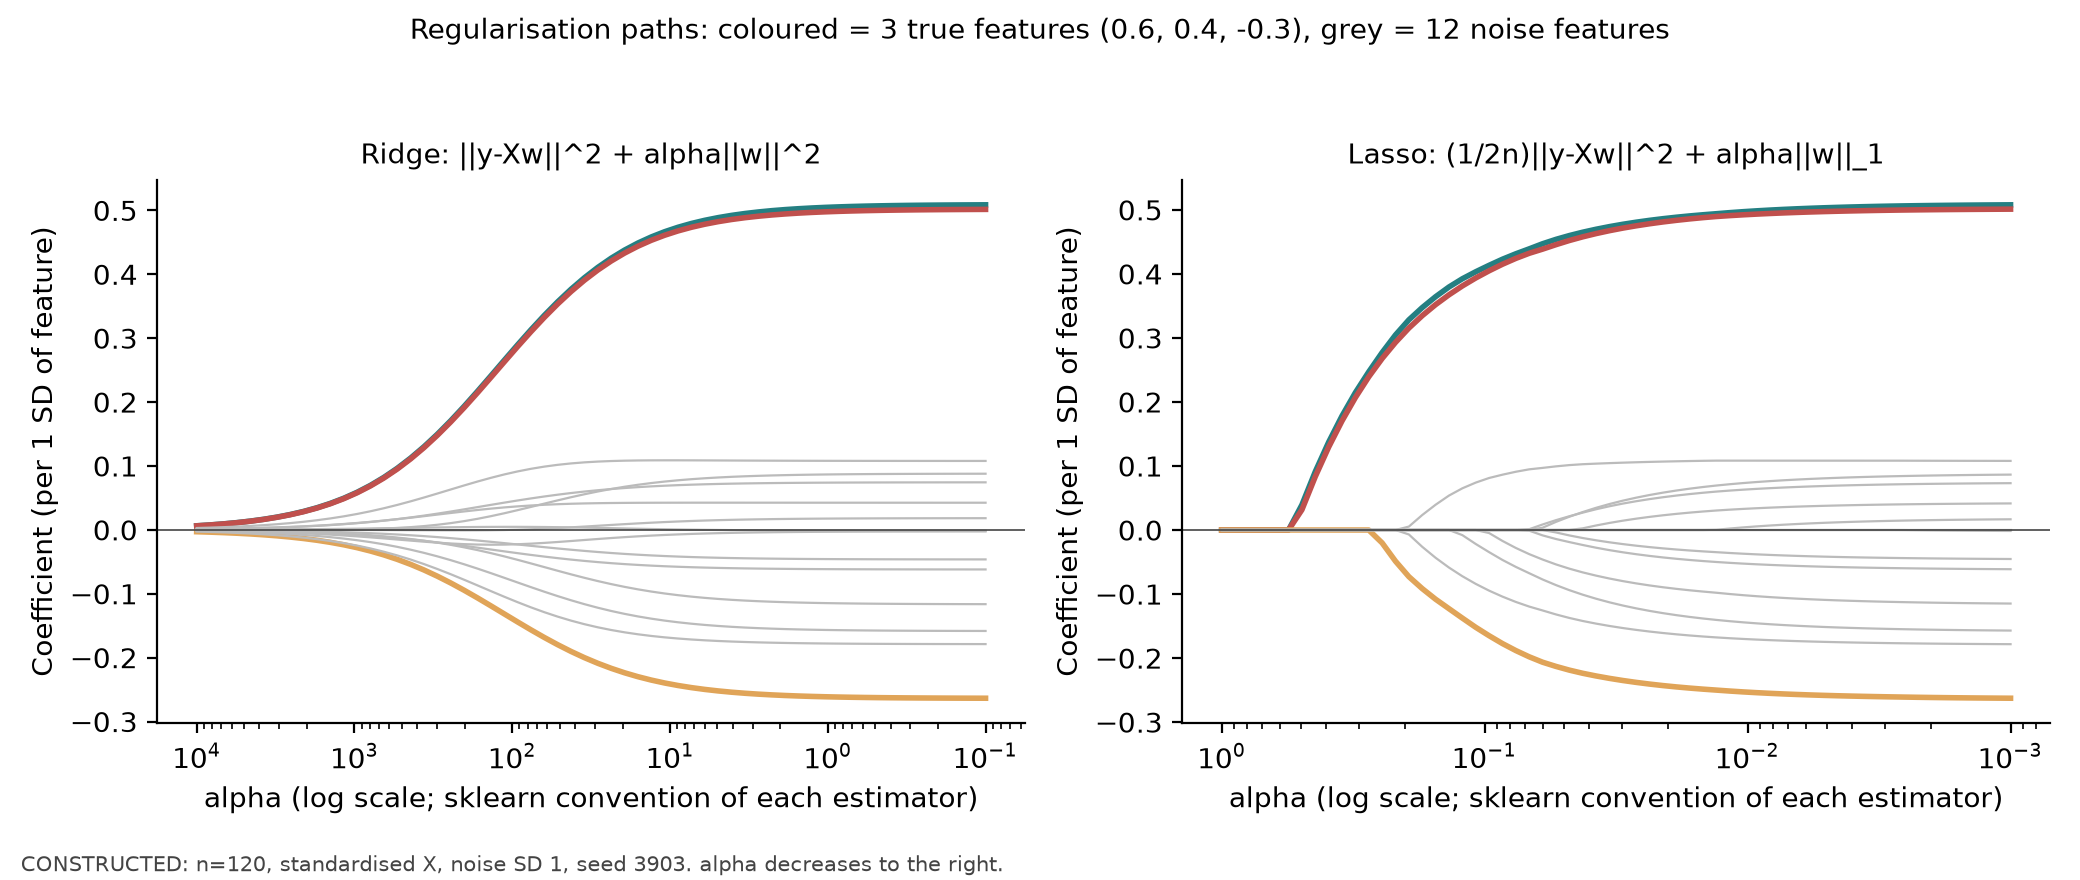
图39-1:横轴为 α \alpha α n = 120 n=120 n = 120 α \alpha α α ≈ 0.50 \alpha\approx0.50 α ≈ 0.50 0.25 0.25 0.25 α → 0 \alpha\to0 α → 0 n = 120 n=120 n = 120 1 / 120 ≈ 0.09 1/\sqrt{120}\approx0.09 1/ 120 ≈ 0.09
图39-2:横轴为 Ridge α \alpha α ( α w / ( n + α ) ) 2 + σ 2 n / ( n + α ) 2 (\alpha w/(n+\alpha))^2+\sigma^2n/(n+\alpha)^2 ( α w / ( n + α ) ) 2 + σ 2 n / ( n + α ) 2 α ∗ = 25 \alpha^\ast=25 α ∗ = 25 α ∗ \alpha^\ast α ∗ α \alpha α
图39-3:三个面板的横轴均为六个模型。左:相对零预测的 R OS 2 R^2_{\text{OS}} R OS 2
11. Real Market Example
本章不报告真实市场的实测数字:Project6 真实数据为 blocked(见 projects/project06/data_manifest.json)。作者实际读到的文献结果(Gu、Kelly、Xiu 2020,表1,第2250页;美国个股、月度、成本前):全部特征的 OLS R OS 2 = − 3.46 % R^2_{\text{OS}}=-3.46\% R OS 2 = − 3.46% R 2 R^2 R 2
获得数据后,应在同一份冻结的股票池与样本期上,按第8.4节表格的全部列报告六个模型,并加报各折的 α \alpha α
12. Common Mistakes
12.1 不标准化就正则化
import numpy as np
from sklearn.linear_model import Lasso
rng = np.random.default_rng(0 )
x1 = rng.normal(size=200 ); x2 = rng.normal(size=200 )
y = 0.5 * x1 + 0.5 * x2 + rng.normal(size=200 )
X_pct = np.column_stack([x1, x2 * 100 ])
coef = Lasso(alpha=0.3 ).fit(X_pct, y).coef_
print (np.round (coef, 4 ))
X_std = (X_pct - X_pct.mean(0 )) / X_pct.std(0 )
print (np.round (Lasso(alpha=0.3 ).fit(X_std, y).coef_, 4 ))
本书运行输出 [0.2408 0.0054] 与 [0.2243 0.2528]。错误:同一个信息,用百分数记录的 x 2 x_2 x 2 x 2 x_2 x 2 x 1 x_1 x 1
12.2 直接比较 Ridge 与 Lasso 的 α \alpha α
错误:“两个模型都用 α = 1 \alpha=1 α = 1 2 n 2n 2 n
12.3 用全样本选 α \alpha α
错误:RidgeCV 或 LassoCV 在全部样本上用随机 K 折选 α \alpha α ml_pipeline.fit_select_predict)。
12.4 把系数当因果或当重要性排名
错误:“Lasso 选中了特征 A、没选 B,所以 A 驱动收益,B 无关。”原因:共线下 Lasso 二选一(第8.3节 44.8% 的样本只留一个),选择随样本与 α \alpha α
12.5 只看 R 2 R^2 R 2
错误:选 R OS 2 R^2_{\text{OS}} R OS 2 R 2 R^2 R 2
12.6 在面板上用 StandardScaler 拟合全部日期
错误:先 StandardScaler().fit(X_all),再 walk-forward。训练设计满列秩时对 OLS 预测无影响;有精确共线(秩亏)时 OLS 的新点预测也会随标准化改变(第38章 6.3 节反例:2.20 对 1.75);对 Ridge、Lasso 通常可能影响:惩罚基于全样本标准差,含测试期信息。修复:Pipeline 内拟合。
13. Quant Research Application
假设 :在收盘可得的 46 个特征中,少数几个对未来 5 日截面收益有弱预测力;正则化线性模型在成本后能产生正的美元中性收益,且优于零预测与训练均值。
设计(冻结) :第8.4节的面板、折、网格、组合规则与成本;每折记录选出的超参数与 Lasso 支持集。
检验 :预测层(两种基准的R OS 2 R^2_{\text{OS}} R OS 2
反证条件 :成本后夏普不为正;预先冻结共同日期的配对检验后未见优势(本章历史逐行数据缺失,未能评估);结论只在少数折成立;最优模型随网格边界变化(如 Ridge 总选到最大 α \alpha α
调参判断 :选择网格边界或更换评价准则需在训练内按预先冻结协议比较,不能从外层表现倒推“必须改IC目标”。
结论写法 :本章冻结账本中Elastic Net成本后夏普较高;不同有效日IC均值不能单独证明配对预测优势,在真实数据上,要用同样的协议重新比较,并保留负结果。
14. Chapter Summary
在固定设计/条件零均值误差等假设下OLS无偏,但方差可大;Ridge 按 n / ( n + α ) n/(n+\alpha) n / ( n + α ) d j 2 / ( d j 2 + α ) d_j^2/(d_j^2+\alpha) d j 2 / ( d j 2 + α ) S ( z , α ) S(z,\alpha) S ( z , α ) 2 n 2n 2 n α \alpha α w ≠ 0 , σ 2 > 0 w\ne0,\sigma^2>0 w = 0 , σ 2 > 0 α ∗ = σ 2 / w 2 \alpha^\ast=\sigma^2/w^2 α ∗ = σ 2 / w 2
15. Exercises
39-E01(OLS)
X X X y = ( 2 , 0 , 2 , − 4 ) y=(2,0,2,-4) y = ( 2 , 0 , 2 , − 4 ) X ⊤ y X^\top y X ⊤ y z z z
39-E02(Ridge 与缩放约定)
沿用 39-E01。(a) 求 scikit-learn Ridge 在 α = 2 \alpha=2 α = 2 α = 12 \alpha=12 α = 12 1 2 n ∥ y − X w ∥ 2 + λ 2 ∥ w ∥ 2 \frac1{2n}\|y-Xw\|^2+\frac{\lambda}2\|w\|^2 2 n 1 ∥ y − X w ∥ 2 + 2 λ ∥ w ∥ 2 α = 12 \alpha=12 α = 12 λ \lambda λ
39-E03(偏差—方差)
n = 250 n=250 n = 250 w = 0.05 w=0.05 w = 0.05 σ = 1 \sigma=1 σ = 1 α ∗ \alpha^\ast α ∗ α ∗ \alpha^\ast α ∗
39-E04(Lasso 软阈值)
沿用 39-E01 的 z z z α = 0.5 \alpha=0.5 α = 0.5 1 1 1 2 2 2 α \alpha α
39-E05(Elastic Net)
沿用 39-E01,α = 1 \alpha=1 α = 1 ρ = 0.8 \rho=0.8 ρ = 0.8 ρ = 0.2 \rho=0.2 ρ = 0.2
39-E06(标准化)
特征 x 2 x_2 x 2 x 2 x_2 x 2
39-E07(共线性)
两个标准化特征相关 r = 0.95 r=0.95 r = 0.95 n = 100 n=100 n = 100 σ = 1 \sigma=1 σ = 1 α = 10 \alpha=10 α = 10
39-E08(系数解释)
Ridge 在训练集上给出标准化特征“账面市值比”的系数 0.002(5 日收益,每个训练标准差)。训练集该特征的标准差为 0.4。(a) 换算成每单位账面市值比的系数。(b) 写出两条理由,说明不能据此说“提高账面市值比 0.4 会让 5 日收益提高 0.2%”。
39-T01(新增:两种单位与两项惩罚)
(a) 未标准化特征x 2 x_2 x 2 y y y α \alpha α α = 0.01 , ρ = 0.5 \alpha=0.01,\rho=0.5 α = 0.01 , ρ = 0.5 α ′ , ρ ′ \alpha',\rho' α ′ , ρ ′
39-T02(新增:自身均值与配对差)
用第8.4节的三日独立构造例,写出D R , D m , D m R D_R,D_m,D_{mR} D R , D m , D m R
16. Programming Exercises
39-P01(正则化路径)
在 n = 120 n=120 n = 120 α \alpha α α \alpha α α \alpha α
39-P02(面板比较)
用 ml_pipeline 复现第8.4节表格。验收:(1) 每折的训练行满足 label_available_at ≤ \le ≤ DateFold);(2) 零与训练均值的组合总收益为 0;(3) 相同预测下成本后NAV不高于成本前,发生正费用且财富因子为正的路径终点应严格较低;零/均值空仓基准两者相等;(4) 输出各折超参数;(5) 在不改变任何设定的前提下,把种子换成 3905 重跑,并报告结论是否改变(保留结果,不挑种子)。
17. Challenge Problems
39-C01(完全共线时的 Ridge 与 Lasso)
两个特征完全相同(x 1 = x 2 = x x_1=x_2=x x 1 = x 2 = x x ⊤ x = n x^\top x=n x ⊤ x = n α > 0 \alpha>0 α > 0 w ^ 1 = w ^ 2 = x ⊤ y 2 n + α \hat w_1=\hat w_2=\frac{x^\top y}{2n+\alpha} w ^ 1 = w ^ 2 = 2 n + α x ⊤ y α ( 1 − ρ ) > 0 \alpha(1-\rho)>0 α ( 1 − ρ ) > 0 α = 0 \alpha=0 α = 0
39-C02(用 MSE 还是用 IC 调参)
第8.4节中 Ridge 用内层验证 MSE 选 α \alpha α 逐日 Spearman IC 均值 为准则的调参方案。(a) 写出它与 MSE 准则在 6.7 节机制下的差别;(b) 指出新准则可能带来的风险(如更多的选择次数、对少数日期敏感);(c) 说明如何在不看外层测试的前提下比较两种准则。开放题,评分见第18节。
39-C03(日期与旧t展示诊断)
Ridge/Lasso/Elastic Net分别有750/441/624个有效日,但只有摘要。能否直接比较三者IC均值?能否把P06预测补作本章配对证据?若有效日交易序号为0、2、3、5、8,删除缺失后的NW第4个观察滞后连哪两天?
18. Solutions / Solution Hints
39-E01
X ⊤ y X^\top y X ⊤ y 2 + 0 − 2 + 4 = 4 2+0-2+4=4 2 + 0 − 2 + 4 = 4 2 − 0 + 2 + 4 = 8 2-0+2+4=8 2 − 0 + 2 + 4 = 8 z = ( 1 , 2 ) z=(1,2) z = ( 1 , 2 ) = ( 1 , 2 ) =(1,2) = ( 1 , 2 ) y ˉ = 0 \bar y=0 y ˉ = 0
39-E02
(a) 4 4 + α z \frac{4}{4+\alpha}z 4 + α 4 z α = 2 \alpha=2 α = 2 ( 0.6667 , 1.3333 ) (0.6667,1.3333) ( 0.6667 , 1.3333 ) α = 12 \alpha=12 α = 12 ( 0.25 , 0.5 ) (0.25,0.5) ( 0.25 , 0.5 ) 1 2 n ∥ y − X w ∥ 2 + λ 2 ∥ w ∥ 2 \frac1{2n}\|y-Xw\|^2+\frac\lambda2\|w\|^2 2 n 1 ∥ y − X w ∥ 2 + 2 λ ∥ w ∥ 2 2 n 2n 2 n ∥ y − X w ∥ 2 + n λ ∥ w ∥ 2 \|y-Xw\|^2+n\lambda\|w\|^2 ∥ y − X w ∥ 2 + nλ ∥ w ∥ 2 n λ = α n\lambda=\alpha nλ = α λ = 12 / 4 = 3 \lambda=12/4=3 λ = 12/4 = 3
39-E03
α ∗ = 1 / 0.0025 = 400 \alpha^\ast=1/0.0025=400 α ∗ = 1/0.0025 = 400 − 400 650 × 0.05 = − 0.03077 -\frac{400}{650}\times0.05=-0.03077 − 650 400 × 0.05 = − 0.03077 250 / 650 2 = 0.000592 250/650^2=0.000592 250/65 0 2 = 0.000592 = 1 / 650 =1/650 = 1/650 1 / 250 = 0.004 1/250=0.004 1/250 = 0.004 250 / 650 250/650 250/650
39-E04
z = ( 1 , 2 ) z=(1,2) z = ( 1 , 2 ) α = 0.5 \alpha=0.5 α = 0.5 ( 0.5 , 1.5 ) (0.5,1.5) ( 0.5 , 1.5 ) α = 1 \alpha=1 α = 1 ( 0 , 1 ) (0,1) ( 0 , 1 ) α = 2 \alpha=2 α = 2 ( 0 , 0 ) (0,0) ( 0 , 0 ) α ≥ max ∣ z j ∣ = 2 \alpha\ge\max|z_j|=2 α ≥ max ∣ z j ∣ = 2
39-E05
ρ = 0.8 \rho=0.8 ρ = 0.8 S ( z , 0.8 ) / ( 1 + 0.2 ) = ( 0.2 , 1.2 ) / 1.2 = ( 0.1667 , 1 ) S(z,0.8)/(1+0.2)=(0.2,1.2)/1.2=(0.1667,1) S ( z , 0.8 ) / ( 1 + 0.2 ) = ( 0.2 , 1.2 ) /1.2 = ( 0.1667 , 1 ) ρ = 0.2 \rho=0.2 ρ = 0.2 S ( z , 0.2 ) / ( 1 + 0.8 ) = ( 0.8 , 1.8 ) / 1.8 = ( 0.4444 , 1 ) S(z,0.2)/(1+0.8)=(0.8,1.8)/1.8=(0.4444,1) S ( z , 0.2 ) / ( 1 + 0.8 ) = ( 0.8 , 1.8 ) /1.8 = ( 0.4444 , 1 )
39-E06
OLS:在训练设计满列秩时,x 2 x_2 x 2 x 2 x_2 x 2 x 2 x_2 x 2 x 2 x_2 x 2 x 1 x_1 x 1
39-E07
VIF = 1 / ( 1 − 0.9025 ) = 10.26 =1/(1-0.9025)=10.26 = 1/ ( 1 − 0.9025 ) = 10.26 10.26 / 100 = 0.320 \sqrt{10.26/100}=0.320 10.26/100 = 0.320 n ( 1 + r ) n ( 1 + r ) + α = 195 205 = 0.951 \frac{n(1+r)}{n(1+r)+\alpha}=\frac{195}{205}=0.951 n ( 1 + r ) + α n ( 1 + r ) = 205 195 = 0.951 5 15 = 0.333 \frac{5}{15}=0.333 15 5 = 0.333
39-E08
(a) 0.002 / 0.4 = 0.005 0.002/0.4=0.005 0.002/0.4 = 0.005 α \alpha α
39-P01
参考实现 code/ch39_regularized_models.py::path_data。本书运行:Lasso 首次进入的 α \alpha α α \alpha α 10 0 … 10 − 3 10^0\ldots10^{-3} 1 0 0 … 1 0 − 3 10 − 1 … 10 4 10^{-1}\ldots10^4 1 0 − 1 … 1 0 4 w j ← S ( x j ⊤ ( y − X w + x j w j ) / n , α ) / ( x j ⊤ x j / n ) w_j\leftarrow S(x_j^\top(y-Xw+x_jw_j)/n,\alpha)/(x_j^\top x_j/n) w j ← S ( x j ⊤ ( y − X w + x j w j ) / n , α ) / ( x j ⊤ x j / n ) lasso_path。断言与输出:
assert np.max (np.abs (lasso_coefs[:, 0 ])) < 1e-8
ols = LinearRegression(fit_intercept=False ).fit(X, y).coef_
assert np.max (np.abs (lasso_coefs[:, -1 ] - ols)) < 0.01
for j in range (X.shape[1 ]):
nz = np.flatnonzero(np.abs (lasso_coefs[j]) > 1e-8 )
print (j, None if len (nz) == 0 else alphas_l[nz[0 ]])
图例区分3真实与12噪声,横轴分别注明估计器约定;最大/最小网格端点与非零容差都要保存。这里提供方法,未重新运行历史路径。
39-P02
参考实现 panel_case 与 backtest_predictions。完整执行方法如下,供后续明确授权的新实验使用,本批不运行3904重训或3905:
固定第8.4节全部构造参数,simulate_return_panel→make_forward_labels(horizon=5,execution_lag=1)→price_features与characteristics合并→stack_features,核46列。
对同一标签表调用 date_walk_forward(504/63日期),保存每折fit_time、train_rows/test_rows;断言每个训练标签成熟、训练信号日期小于fit日期、训练与当前测试跨集合的真实标签区间无重叠(训练内部及测试内部的五日标签允许重叠)。
按第8.4节固定六模型网格,分别 walk_forward_predict(...,inner_val_dates=63,inner_folds=2,inner_min_train_dates=252);保存逐行预测与每折 chosen_params,再计算两基准R2、每个模型有效IC日期集和共同集。
每个模型同一预测分别 backtest_predictions(close,pred,rebalance_every=5,fee_rate=0.0) 与费用0.001;比较相同日期NAV、成本和换手。零与训练均值空仓应总收益0;非零费用且实际交易路径成本后终点较低,无交易应相等。每路径 N N N N + 1 N+1 N + 1
将完整参数原样封存后仅把seed改3905,另存唯一新目录,保留正负结果及参数选择,不回头选有利种子。新运行是新身份,不能填作3904历史缺失行。若未获运行授权,应像本批一样写“未执行”,不填想象数值。
测试见 tests/test_ml_pipeline.py 中以 test_host_backtest 开头的用例。展示数值见第8.4节;IC自身日数750/441/624来自冻结摘要。共同日期与配对均值未能复算,旧压缩NW t不作四交易日HAC推断;不能重训补造这次历史证据。各折超参数存于 ch39_results.json。(5) 的结果无论好坏都写进报告。
39-C01 参考证明
(1) 目标 ∥ y − ( w 1 + w 2 ) x ∥ 2 + α ( w 1 2 + w 2 2 ) \|y-(w_1+w_2)x\|^2+\alpha(w_1^2+w_2^2) ∥ y − ( w 1 + w 2 ) x ∥ 2 + α ( w 1 2 + w 2 2 ) s = w 1 + w 2 s=w_1+w_2 s = w 1 + w 2 s s s w 1 2 + w 2 2 w_1^2+w_2^2 w 1 2 + w 2 2 w 1 = w 2 = s / 2 w_1=w_2=s/2 w 1 = w 2 = s /2 s s s ∥ y − s x ∥ 2 + α s 2 / 2 \|y-sx\|^2+\alpha s^2/2 ∥ y − s x ∥ 2 + α s 2 /2 s = 2 x ⊤ y 2 n + α s=\frac{2x^\top y}{2n+\alpha} s = 2 n + α 2 x ⊤ y w ^ j = x ⊤ y 2 n + α \hat w_j=\frac{x^\top y}{2n+\alpha} w ^ j = 2 n + α x ⊤ y s s s ∣ w 1 ∣ + ∣ w 2 ∣ |w_1|+|w_2| ∣ w 1 ∣ + ∣ w 2 ∣ ∣ w 1 ∣ + ∣ w 2 ∣ = ∣ s ∣ |w_1|+|w_2|=|s| ∣ w 1 ∣ + ∣ w 2 ∣ = ∣ s ∣ s ∗ = S ( x ⊤ y / n , α ) s^\ast=S(x^\top y/n,\alpha) s ∗ = S ( x ⊤ y / n , α ) { ( w 1 , w 2 ) : w 1 + w 2 = s ∗ , w 1 w 2 ≥ 0 } \{(w_1,w_2):w_1+w_2=s^\ast,\ w_1w_2\ge0\} {( w 1 , w 2 ) : w 1 + w 2 = s ∗ , w 1 w 2 ≥ 0 } s ∗ = 0 s^\ast=0 s ∗ = 0 α > 0 \alpha>0 α > 0 α = 0 \alpha=0 α = 0 x ⊤ y / n x^\top y/n x ⊤ y / n α ( 1 − ρ ) > 0 \alpha(1-\rho)>0 α ( 1 − ρ ) > 0 ρ < 1 \rho<1 ρ < 1 α = 0 \alpha=0 α = 0
39-C02 评分准则
满分 10 分。(a) 指出 MSE 惩罚预测幅度与校准错误,IC 只看截面排序;即使共同正比例缩放不改秩,两种准则也可能偏好不同的 α \alpha α
39-C03 完整解答
不能将不同日期集上的自身IC均值当成共同日期的配对优势。应定义有效集D m D_m D m D m ∩ D R D_m\cap D_R D m ∩ D R
39-T01 完整解答
(a) 原斜率b 2 b_2 b 2 s 2 s_2 s 2 w 2 = s 2 b 2 w_2=s_2b_2 w 2 = s 2 b 2 α \alpha α ∣ w ∣ |w| ∣ w ∣ α ′ = 100 α \alpha'=100\alpha α ′ = 100 α α ′ = 0.01 ( 0.5 + 100 × 0.5 ) = 0.505 \alpha'=0.01(0.5+100\times0.5)=0.505 α ′ = 0.01 ( 0.5 + 100 × 0.5 ) = 0.505 ρ ′ = 50 / 50.5 = 100 / 101 \rho'=50/50.5=100/101 ρ ′ = 50/50.5 = 100/101 α ′ ρ ′ = 0.5 = 100 α ρ \alpha'\rho'=0.5=100\alpha\rho α ′ ρ ′ = 0.5 = 100 α ρ α ′ ( 1 − ρ ′ ) = 0.005 = α ( 1 − ρ ) \alpha'(1-\rho')=0.005=\alpha(1-\rho) α ′ ( 1 − ρ ′ ) = 0.005 = α ( 1 − ρ )
39-T02 完整解答
D R = { 1 , 2 , 3 } D_R=\{1,2,3\} D R = { 1 , 2 , 3 } D m = { 1 , 3 } D_m=\{1,3\} D m = { 1 , 3 } D m R = { 1 , 3 } D_{mR}=\{1,3\} D m R = { 1 , 3 } ( 0.1 + 0.9 + 0.2 ) / 3 = 0.4 (0.1+0.9+0.2)/3=0.4 ( 0.1 + 0.9 + 0.2 ) /3 = 0.4 ( 0.2 + 0.3 ) / 2 = 0.25 (0.2+0.3)/2=0.25 ( 0.2 + 0.3 ) /2 = 0.25 Δ m R = [ ( 0.2 − 0.1 ) + ( 0.3 − 0.2 ) ] / 2 = 0.10 \Delta_{mR}=[(0.2-0.1)+(0.3-0.2)]/2=0.10 Δ m R = [( 0.2 − 0.1 ) + ( 0.3 − 0.2 )] /2 = 0.10
19. Further Reading
Must Know:第8章(OLS、标准化、单序列正则化选择)与第38章(管线)。
Must Know:scikit-learn 1.9.1 的 Ridge、Lasso、ElasticNet 文档(CH08_DOC_08–CH08_DOC_10),读目标函数与 alpha、l1_ratio 的说明。
Should Know:Hastie、Tibshirani、Friedman《The Elements of Statistical Learning》第2版第3.4节(ESL_2ND_ED):岭回归的奇异值收缩、Lasso、L1/L2 几何。
Should Know:Zou、Hastie(2005)定理1 的分组效应(CH08_DOC_17);Friedman、Hastie、Tibshirani(2010)坐标下降与正则化路径(CH39_FHT2010)。
Should Know:Gu、Kelly、Xiu(2020)第2.2节与表1(CH37_GKX2020):大规模个股预测中线性模型、正则化与非线性方法的样本外比较。
Optional:Hoerl、Kennard(1970)与 Tibshirani(1996)原始论文(CH08_DOC_15、CH08_DOC_16,第8章登记为出版商记录)。
20. References
CH08_DOC_08、CH08_DOC_09、CH08_DOC_10:scikit-learn Ridge、Lasso、ElasticNet。作者在本机 scikit-learn 1.9.1 的 docstring 中核对第5节三个目标函数(见 source_notes)。ESL_2ND_ED:Hastie, T., Tibshirani, R., Friedman, J. (2009). The Elements of Statistical Learning, 2nd ed. 第3.4节;侦察报告读到式(3.41)(3.44)(3.47)、表3.4、图3.11;作者未重新打开(下载页需要浏览器交互),本章第6.1–6.5节的推导自洽,并由第8.1节代码核对。CH08_DOC_17:Zou, H., Hastie, T. (2005). Regularization and variable selection via the elastic net. JRSS-B 67(2), 301–320。定理1 分组效应,侦察报告核读。CH39_FHT2010:Friedman, J., Hastie, T., Tibshirani, R. (2010). Regularization Paths for Generalized Linear Models via Coordinate Descent. Journal of Statistical Software 33(1), 1–22。侦察报告核读第1–2节。CH37_GKX2020:Gu, Kelly, Xiu (2020),作者核读式(19)第2249页与表1第2250页。核读记录:course/zh/chapters/ch39/source_notes.md。