主线:把不确定性写成可检查的事件与分布,再用条件信息更新判断;模拟输出不能代替对假设的检查。
先修:第 4 章微积分、第 5 章线性代数与协方差。完成后,你能计算条件概率与矩,辨认常见分布,解释大数定律(law of large numbers,LLN)和中心极限定理(central limit theorem,CLT)的适用条件,并实现几类基础随机过程。
本章首次给出英文术语,便于你对照课程资料、NumPy/SciPy 文档和程序输出;首次出现的符号也会说明它代表什么、单位是什么,帮助你把公式对应到实际计算量。
1. 本章目标
读完本章,你应能:
从样本空间(sample space)和事件(event)定义概率,使用条件概率(conditional probability)、全概率公式(law of total probability)与贝叶斯(Bayes)公式更新判断。
区分离散型与连续型随机变量(random variable),正确使用概率质量函数(probability mass function,PMF)、概率密度函数(probability density function,PDF)和累积分布函数(cumulative distribution function,CDF)。
计算期望(expectation)、方差(variance)、协方差(covariance)和条件期望(conditional expectation),并说明它们如何进入组合风险与预测。
识别伯努利(Bernoulli)、二项(binomial)、正态(normal)、对数正态(lognormal)、泊松(Poisson)和学生 t(Student’s t)分布的参数与矩条件。
说明大数定律和中心极限定理的样本假设;解释时间依赖(Temporal Dependence)、厚尾(heavy tail)与参数不确定性为什么会改变结论。
用固定随机种子生成样本均值(sample mean)、随机游走(random walk)和泊松(Poisson)计数过程,并区分构造模拟与真实市场证据。
完成标准:你可以手算第 8 节的低基率 Bayes 例子,指出哪些分布矩不存在,运行第 9 节脚本,并从图上说出实验展示的性质和没有展示的性质。
2. 为什么量化(Quant)需要它
量化研究要回答的问题常带随机性:一次信号后发生亏损的概率是多少?多个资产一起下跌的风险有多大?有限样本中的平均收益为什么会偏离总体均值?到达事件的次数能否由一个计数模型近似?
概率论为这些问题提供共同语言,但模型输出不是事实本身。概率 0.02 0.02 0.02
路径随机性(path randomness) :即使参数给定,下一步结果仍不确定。参数不确定性(parameter uncertainty) :概率、均值、波动率或强度本身由有限样本估计,真实值也未知。模型不确定性(model uncertainty) :所选分布或过程未必能描述目标对象。
在风险监控中,低基率事件(low-base-rate event)尤其容易造成直觉错误。一个告警即便有较高灵敏度(sensitivity),也可能主要是假阳性(false positive);判断告警价值必须结合事件先验概率(prior probability)。本章用可手算的构造数字展示这一点,再把相同的条件化逻辑推广到收益、过程与模拟。
3. 直觉
先想象每天从一个袋子里独立(independent)抽出一张红或蓝卡片。红色概率固定为 p p p p p p p = 0.3 p=0.3 p = 0.3
袋子类比只把“每次结果”和“重复试验”分开。金融收益还可能有波动聚集、共同冲击和时间依赖,不能由这个类比推出收益独立。
条件概率的直觉是缩小观察范围。若只看“告警为阳性”的日子,就要问这些日子中真实事件所占比例,而不是只看检测器在事件发生时的命中率。贝叶斯(Bayes)公式把先验、命中率和误报率放到同一个分母里。
再想一条对称随机游走(random walk):每步向上或向下一个单位,每一步增量的总体均值是零,增量的样本平均在独立条件下趋近零;累计位置的方差却随步数增长,单条路径可以远离零。不能把平均增量收敛翻译成累计位置收敛。大数定律谈样本平均在重复试验下的收敛,不表示单条金融价格路径会收敛到一个常数。中心极限定理描述标准化样本均值的近似分布,也不意味着原始单期收益是正态分布。
本章所有数值实验都从指定参数和伪随机数生成器(pseudorandom number generator,PRNG)构造样本。固定种子让同一环境下的输出可复核;它不会把模拟变成市场数据,也不会证明参数适合现实资产。
4. 数学基础
4.1 概率与事件
定义:概率模型与事件
设 Ω \Omega Ω F \mathcal{F} F σ \sigma σ P \mathbb{P} P A ∈ F A\in\mathcal{F} A ∈ F
P ( A ) ≥ 0 , P ( Ω ) = 1 , P ( ⋃ j = 1 ∞ A j ) = ∑ j = 1 ∞ P ( A j ) 若 A j 两两互斥。
\mathbb{P}(A)\ge 0,\qquad
\mathbb{P}(\Omega)=1,\qquad
\mathbb{P}\left(\bigcup_{j=1}^{\infty}A_j\right)=
\sum_{j=1}^{\infty}\mathbb{P}(A_j)
\quad\text{若 } A_j \text{ 两两互斥。}
P ( A ) ≥ 0 , P ( Ω ) = 1 , P ( j = 1 ⋃ ∞ A j ) = j = 1 ∑ ∞ P ( A j ) 若 A j 两两互斥。 Ω \Omega Ω A j A_j A j P \mathbb{P} P [ 0 , 1 ] [0,1] [ 0 , 1 ] P ( ∅ ) = 0 \mathbb{P}(\varnothing)=0 P ( ∅ ) = 0 P ( A c ) = 1 − P ( A ) \mathbb{P}(A^c)=1-\mathbb{P}(A) P ( A c ) = 1 − P ( A ) P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) \mathbb{P}(A\cup B)=\mathbb{P}(A)+\mathbb{P}(B)-\mathbb{P}(A\cap B) P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) A ∩ B = ∅ A\cap B=\varnothing A ∩ B = ∅
4.2 条件概率与更新
当 P ( B ) > 0 \mathbb{P}(B)>0 P ( B ) > 0 B B B A A A
P ( A ∣ B ) = P ( A ∩ B ) P ( B ) .
\mathbb{P}(A\mid B)=
\frac{\mathbb{P}(A\cap B)}{\mathbb{P}(B)}.
P ( A ∣ B ) = P ( B ) P ( A ∩ B ) . A , B A,B A , B A , B A,B A , B P ( A ∩ B ) = P ( A ) P ( B ) \mathbb{P}(A\cap B)=\mathbb{P}(A)\mathbb{P}(B) P ( A ∩ B ) = P ( A ) P ( B ) P ( A ∣ B ) = P ( A ) \mathbb{P}(A\mid B)=\mathbb{P}(A) P ( A ∣ B ) = P ( A )
若 B 1 , … , B k B_1,\dots,B_k B 1 , … , B k
P ( A ) = ∑ j = 1 k P ( A ∣ B j ) P ( B j ) .
\mathbb{P}(A)=\sum_{j=1}^{k}\mathbb{P}(A\mid B_j)\mathbb{P}(B_j).
P ( A ) = j = 1 ∑ k P ( A ∣ B j ) P ( B j ) . 把它代入条件概率,可得 Bayes 公式:
P ( B i ∣ A ) = P ( A ∣ B i ) P ( B i ) ∑ j = 1 k P ( A ∣ B j ) P ( B j ) .
\mathbb{P}(B_i\mid A)=
\frac{\mathbb{P}(A\mid B_i)\mathbb{P}(B_i)}
{\sum_{j=1}^{k}\mathbb{P}(A\mid B_j)\mathbb{P}(B_j)}.
P ( B i ∣ A ) = ∑ j = 1 k P ( A ∣ B j ) P ( B j ) P ( A ∣ B i ) P ( B i ) . P ( B i ) \mathbb{P}(B_i) P ( B i ) P ( A ∣ B i ) \mathbb{P}(A\mid B_i) P ( A ∣ B i ) P ( B i ∣ A ) \mathbb{P}(B_i\mid A) P ( B i ∣ A ) A A A A A A
条件概率回答“在已观察到 B B B A A A B B B A A A B B B B B B P ( A ∣ B ) \mathbb{P}(A\mid B) P ( A ∣ B )
4.3 随机变量与分布
随机变量(random variable)X : Ω → R X:\Omega\rightarrow\mathbb{R} X : Ω → R
F X ( x ) = P ( X ≤ x ) .
F_X(x)=\mathbb{P}(X\le x).
F X ( x ) = P ( X ≤ x ) . x x x X X X F X F_X F X a < b a<b a < b P ( a < X ≤ b ) = F X ( b ) − F X ( a ) \mathbb{P}(a<X\le b)=F_X(b)-F_X(a) P ( a < X ≤ b ) = F X ( b ) − F X ( a )
离散型 X X X p X ( x ) = P ( X = x ) p_X(x)=\mathbb{P}(X=x) p X ( x ) = P ( X = x ) X X X f X f_X f X
F X ( x ) = ∫ − ∞ x f X ( u ) d u , P ( a < X ≤ b ) = ∫ a b f X ( u ) d u .
F_X(x)=\int_{-\infty}^{x} f_X(u)\,du,\qquad
\mathbb{P}(a<X\le b)=\int_a^b f_X(u)\,du.
F X ( x ) = ∫ − ∞ x f X ( u ) d u , P ( a < X ≤ b ) = ∫ a b f X ( u ) d u . u , x u,x u , x X X X f X f_X f X 1 / X 1/X 1/ X
把第3节的袋子固定为10张卡,其中3张红、7张蓝。每次抽卡后放回并混匀,连续抽两次作为一份有序试验记录;红卡记为成功1,蓝卡记为失败0。再次按同一机制抽两次,就得到另一份记录。模型规定每次抽取相互独立,成功概率固定为 p = 0.30 p=0.30 p = 0.30 A A A B B B X X X
结果 ω \omega ω
结果概率
事件 A
事件 B
次数 X
00
0.7 × 0.7 = 0.49 0.7\times0.7=0.49 0.7 × 0.7 = 0.49 0
0
0
01
0.7 × 0.3 = 0.21 0.7\times0.3=0.21 0.7 × 0.3 = 0.21 0
1
1
10
0.3 × 0.7 = 0.21 0.3\times0.7=0.21 0.3 × 0.7 = 0.21 0
1
1
11
0.3 × 0.3 = 0.09 0.3\times0.3=0.09 0.3 × 0.3 = 0.09 1
1
2
样本空间为 Ω = { 00 , 01 , 10 , 11 } \Omega=\{00,01,10,11\} Ω = { 00 , 01 , 10 , 11 } { ω } \{\omega\} { ω } B B B A A A P ( A ∣ B ) = 0.09 / ( 0.21 + 0.21 + 0.09 ) = 3 / 17 \mathbb{P}(A\mid B)=0.09/(0.21+0.21+0.09)=3/17 P ( A ∣ B ) = 0.09/ ( 0.21 + 0.21 + 0.09 ) = 3/17 X X X P ( X = 0 ) = 0.49 \mathbb{P}(X=0)=0.49 P ( X = 0 ) = 0.49 P ( X = 1 ) = 0.42 \mathbb{P}(X=1)=0.42 P ( X = 1 ) = 0.42 P ( X = 2 ) = 0.09 \mathbb{P}(X=2)=0.09 P ( X = 2 ) = 0.09
4.4 期望、方差与协方差
若矩存在,期望(expectation)是概率加权的长期平均。离散型与连续型写法分别为
E [ X ] = ∑ x x p X ( x ) , E [ X ] = ∫ − ∞ ∞ x f X ( x ) d x .
\mathbb{E}[X]=\sum_x x p_X(x),\qquad
\mathbb{E}[X]=\int_{-\infty}^{\infty}x f_X(x)\,dx.
E [ X ] = x ∑ x p X ( x ) , E [ X ] = ∫ − ∞ ∞ x f X ( x ) d x . X X X X X X
Var ( X ) = E [ ( X − E X ) 2 ] = E [ X 2 ] − ( E X ) 2 .
\operatorname{Var}(X)=\mathbb{E}[(X-\mathbb{E}X)^2]
=\mathbb{E}[X^2]-(\mathbb{E}X)^2.
Var ( X ) = E [( X − E X ) 2 ] = E [ X 2 ] − ( E X ) 2 . 协方差(covariance)描述两个变量共同偏离其均值的方向:
Cov ( X , Y ) = E [ ( X − E X ) ( Y − E Y ) ] .
\operatorname{Cov}(X,Y)=
\mathbb{E}[(X-\mathbb{E}X)(Y-\mathbb{E}Y)].
Cov ( X , Y ) = E [( X − E X ) ( Y − E Y )] . 协方差单位是 X X X Y Y Y [ − 1 , 1 ] [-1,1] [ − 1 , 1 ]
Corr ( X , Y ) = Cov ( X , Y ) σ X σ Y ,
\operatorname{Corr}(X,Y)=\frac{\operatorname{Cov}(X,Y)}{\sigma_X\sigma_Y},
Corr ( X , Y ) = σ X σ Y Cov ( X , Y ) , 其中 σ X , σ Y \sigma_X,\sigma_Y σ X , σ Y X , Y X,Y X , Y
若 X , Y X,Y X , Y Y = X 2 Y=X^2 Y = X 2
回到上一节的两次 Bernoulli 试验,成功次数分布为 ( 0 , 0.49 ) , ( 1 , 0.42 ) , ( 2 , 0.09 ) (0,0.49),(1,0.42),(2,0.09) ( 0 , 0.49 ) , ( 1 , 0.42 ) , ( 2 , 0.09 )
E [ X ] = 0 ( 0.49 ) + 1 ( 0.42 ) + 2 ( 0.09 ) = 0.60 , E [ X 2 ] = 0 2 ( 0.49 ) + 1 2 ( 0.42 ) + 2 2 ( 0.09 ) = 0.78 ,
\mathbb{E}[X]=0(0.49)+1(0.42)+2(0.09)=0.60,
\qquad
\mathbb{E}[X^2]=0^2(0.49)+1^2(0.42)+2^2(0.09)=0.78,
E [ X ] = 0 ( 0.49 ) + 1 ( 0.42 ) + 2 ( 0.09 ) = 0.60 , E [ X 2 ] = 0 2 ( 0.49 ) + 1 2 ( 0.42 ) + 2 2 ( 0.09 ) = 0.78 , Var ( X ) = 0.78 − ( 0.60 ) 2 = 0.42.
\operatorname{Var}(X)=0.78-(0.60)^2=0.42.
Var ( X ) = 0.78 − ( 0.60 ) 2 = 0.42. 先从结果得到各个概率,再按定义加权;这一步把试验、PMF、期望和方差连成同一条计算链。
对权重固定的 n n n R R R R p = w ⊤ R R_p=w^\top R R p = w ⊤ R
Var ( R p ) = w ⊤ Σ w = ∑ i = 1 n ∑ j = 1 n w i w j Cov ( R i , R j ) .
\operatorname{Var}(R_p)=w^\top\Sigma w
=\sum_{i=1}^{n}\sum_{j=1}^{n}w_iw_j\operatorname{Cov}(R_i,R_j).
Var ( R p ) = w ⊤ Σ w = i = 1 ∑ n j = 1 ∑ n w i w j Cov ( R i , R j ) . w i w_i w i Σ \Sigma Σ
4.5 条件期望
给定事件 B B B E [ X ∣ B ] \mathbb{E}[X\mid B] E [ X ∣ B ] G \mathcal{G} G E [ X ∣ G ] \mathbb{E}[X\mid\mathcal{G}] E [ X ∣ G ] G \mathcal{G} G X X X
E [ X ] = E [ E ( X ∣ G ) ] ,
\mathbb{E}[X]=\mathbb{E}[\mathbb{E}(X\mid\mathcal{G})],
E [ X ] = E [ E ( X ∣ G )] , Var ( X ) = E [ Var ( X ∣ G ) ] + Var ( E [ X ∣ G ] ) .
\operatorname{Var}(X)=
\mathbb{E}[\operatorname{Var}(X\mid\mathcal{G})]
+\operatorname{Var}(\mathbb{E}[X\mid\mathcal{G}]).
Var ( X ) = E [ Var ( X ∣ G )] + Var ( E [ X ∣ G ]) . 第一项是状态内的平均随机波动,第二项是状态条件均值之间的波动。只报告第一项会漏掉状态均值不确定性。
4.6 本章用到的过程与收敛符号
独立同分布(independent and identically distributed,i.i.d.)样本 X 1 , … , X n X_1,\ldots,X_n X 1 , … , X n X ˉ n = n − 1 ∑ i = 1 n X i \bar X_n=n^{-1}\sum_{i=1}^nX_i X ˉ n = n − 1 ∑ i = 1 n X i → p \xrightarrow{p} p → a . s . \xrightarrow{a.s.} a . s . → d \xrightarrow{d} d
弱白噪声(weak white noise,WN)是二阶概念:E [ X t ] = 0 \mathbb E[X_t]=0 E [ X t ] = 0
随机过程(stochastic process)是一组按时间索引的随机变量。随机游走把增量逐步累加;马尔可夫(Markov)过程满足给定当前状态后,未来与更早历史条件独立;泊松(Poisson)过程描述单位时间内的随机计数;布朗(Brownian)运动是连续时间、连续路径的标准扩散过程。本章第 6 节给出定义与条件。
5. 正式定义与常见分布
5.1 Bernoulli 与二项分布
伯努利(Bernoulli)随机变量 X ∼ Bernoulli ( p ) X\sim\operatorname{Bernoulli}(p) X ∼ Bernoulli ( p ) P ( X = 1 ) = p \mathbb{P}(X=1)=p P ( X = 1 ) = p p p p p ( 1 − p ) p(1-p) p ( 1 − p ) n n n K = ∑ i = 1 n X i K=\sum_{i=1}^{n}X_i K = ∑ i = 1 n X i
P ( K = k ) = ( n k ) p k ( 1 − p ) n − k , k = 0 , … , n .
\mathbb{P}(K=k)=\binom{n}{k}p^k(1-p)^{n-k},\quad k=0,\ldots,n.
P ( K = k ) = ( k n ) p k ( 1 − p ) n − k , k = 0 , … , n . n n n k k k p p p n p np n p n p ( 1 − p ) np(1-p) n p ( 1 − p )
5.2 正态、对数正态与 Student t
正态分布(normal distribution)X ∼ N ( μ , σ 2 ) X\sim N(\mu,\sigma^2) X ∼ N ( μ , σ 2 ) μ \mu μ X X X σ > 0 \sigma>0 σ > 0 σ 2 \sigma^2 σ 2
先把 Y Y Y Z = ln Y ∼ N ( μ , σ 2 ) Z=\ln Y\sim N(\mu,\sigma^2) Z = ln Y ∼ N ( μ , σ 2 ) Y = e Z Y=e^Z Y = e Z Y > 0 Y>0 Y > 0 μ , σ \mu,\sigma μ , σ e μ + σ 2 / 2 e^{\mu+\sigma^2/2} e μ + σ 2 /2 e μ e^\mu e μ V V V V 0 > 0 V_0>0 V 0 > 0 V = V 0 Y V=V_0Y V = V 0 Y Z = ln ( V / V 0 ) Z=\ln(V/V_0) Z = ln ( V / V 0 ) E [ V ] = V 0 e μ + σ 2 / 2 \mathbb E[V]=V_0e^{\mu+\sigma^2/2} E [ V ] = V 0 e μ + σ 2 /2 V 0 2 V_0^2 V 0 2
学生 t 分布(Student’s t distribution)由自由度 ν > 0 \nu>0 ν > 0 ν > 1 \nu>1 ν > 1 ν > 2 \nu>2 ν > 2 ν / ( ν − 2 ) \nu/(\nu-2) ν / ( ν − 2 ) 1 < ν ≤ 2 1<\nu\le2 1 < ν ≤ 2 ν ≤ 1 \nu\le1 ν ≤ 1
5.3 Poisson 分布
泊松分布(Poisson distribution)N ∼ Poisson ( λ ) N\sim\operatorname{Poisson}(\lambda) N ∼ Poisson ( λ )
P ( N = k ) = e − λ λ k k ! , k = 0 , 1 , … .
\mathbb{P}(N=k)=e^{-\lambda}\frac{\lambda^k}{k!},\quad k=0,1,\ldots.
P ( N = k ) = e − λ k ! λ k , k = 0 , 1 , … . λ ≥ 0 \lambda\ge0 λ ≥ 0 λ \lambda λ Δ t \Delta t Δ t λ = ρ Δ t \lambda=\rho\Delta t λ = ρ Δ t ρ \rho ρ
5.4 分布表
分布
参数与支持集
均值与方差
典型用途与限制
Bernoulli
p ∈ [ 0 , 1 ] p\in[0,1] p ∈ [ 0 , 1 ] { 0 , 1 } \{0,1\} { 0 , 1 } p , p ( 1 − p ) p,\ p(1-p) p , p ( 1 − p ) 单次二元结果;不自动意味着跨期独立
二项
n ∈ N , p ∈ [ 0 , 1 ] n\in\mathbb{N}, p\in[0,1] n ∈ N , p ∈ [ 0 , 1 ] { 0 , … , n } \{0,\ldots,n\} { 0 , … , n } n p , n p ( 1 − p ) np,\ np(1-p) n p , n p ( 1 − p ) 固定数量的独立同概率试验
正态
μ ∈ R , σ > 0 \mu\in\mathbb{R},\sigma>0 μ ∈ R , σ > 0 R \mathbb{R} R μ , σ 2 \mu,\sigma^2 μ , σ 2 加总误差/渐近近似;不保证尾部拟合
对数正态
ln Y ∼ N ( μ , σ 2 ) \ln Y\sim N(\mu,\sigma^2) ln Y ∼ N ( μ , σ 2 ) Y > 0 Y>0 Y > 0 e μ + σ 2 / 2 , ( e σ 2 − 1 ) e 2 μ + σ 2 e^{\mu+\sigma^2/2},(e^{\sigma^2}-1)e^{2\mu+\sigma^2} e μ + σ 2 /2 , ( e σ 2 − 1 ) e 2 μ + σ 2 正值乘法量;不适合可为负的单期收益本身
Poisson
λ ≥ 0 \lambda\ge0 λ ≥ 0 λ , λ \lambda,\lambda λ , λ 区间事件计数;要求等均值方差等建模结构
Student t
ν > 0 \nu>0 ν > 0 R \mathbb{R} R ν > 1 \nu>1 ν > 1 ν > 2 \nu>2 ν > 2 ν / ( ν − 2 ) \nu/(\nu-2) ν / ( ν − 2 ) 有限自由度厚尾;低自由度矩不存在
SciPy 的分布对象使用各自应用程序编程接口(application programming interface,API)参数名。尤其 lognormal 的 shape=sigma、scale=exp(mu) 与这里 Y = e Z , Z ∼ N ( μ , σ 2 ) Y=e^Z,\ Z\sim N(\mu,\sigma^2) Y = e Z , Z ∼ N ( μ , σ 2 )
5.5 均匀与指数分布:模拟入口和等待时间
均匀分布(Uniform Distribution)U ∼ Uniform ( a , b ) U\sim\operatorname{Uniform}(a,b) U ∼ Uniform ( a , b ) a < b a<b a < b 1 / ( b − a ) 1/(b-a) 1/ ( b − a ) ( a + b ) / 2 (a+b)/2 ( a + b ) /2 ( b − a ) 2 / 12 (b-a)^2/12 ( b − a ) 2 /12 U ∼ Uniform ( 0 , 1 ) U\sim\operatorname{Uniform}(0,1) U ∼ Uniform ( 0 , 1 ) P ( 0.2 < U < 0.5 ) = 0.3 \mathbb P(0.2<U<0.5)=0.3 P ( 0.2 < U < 0.5 ) = 0.3
指数分布(Exponential Distribution)T ∼ Exponential ( ρ ) T\sim\operatorname{Exponential}(\rho) T ∼ Exponential ( ρ ) ρ > 0 \rho>0 ρ > 0 ρ e − ρ t \rho e^{-\rho t} ρ e − ρt t ≥ 0 t\ge0 t ≥ 0 P ( T > t ) = e − ρ t \mathbb P(T>t)=e^{-\rho t} P ( T > t ) = e − ρt 1 / ρ 1/\rho 1/ ρ 1 / ρ 2 1/\rho^2 1/ ρ 2 T T T ρ \rho ρ 1 / ρ 1/\rho 1/ ρ
若 N ( t ) N(t) N ( t ) ρ > 0 \rho>0 ρ > 0 T 1 > t T_1>t T 1 > t N ( t ) = 0 N(t)=0 N ( t ) = 0
P ( T 1 > t ) = P ( N ( t ) = 0 ) = e − ρ t .
\mathbb P(T_1>t)=\mathbb P(N(t)=0)=e^{-\rho t}.
P ( T 1 > t ) = P ( N ( t ) = 0 ) = e − ρt . 这就把计数分布和等待时间分布连起来。进一步,
P ( T 1 > s + t ∣ T 1 > s ) = e − ρ ( s + t ) e − ρ s = e − ρ t , s , t ≥ 0.
\mathbb P(T_1>s+t\mid T_1>s)=
\frac{e^{-\rho(s+t)}}{e^{-\rho s}}=e^{-\rho t},
\quad s,t\ge0.
P ( T 1 > s + t ∣ T 1 > s ) = e − ρ s e − ρ ( s + t ) = e − ρt , s , t ≥ 0. 这称无记忆性(Memorylessness)。它在此模型下成立,不表示实际订单到达没有季节性或簇集。取 ρ = 0.7 \rho=0.7 ρ = 0.7
6. 推导与成立条件
6.1 Bayes 公式从定义得出
由条件概率定义,
P ( B i ∣ A ) = P ( B i ∩ A ) / P ( A ) \mathbb{P}(B_i\mid A)=\mathbb{P}(B_i\cap A)/\mathbb{P}(A) P ( B i ∣ A ) = P ( B i ∩ A ) / P ( A ) P ( B i ∩ A ) = P ( A ∣ B i ) P ( B i ) \mathbb{P}(B_i\cap A)=\mathbb{P}(A\mid B_i)\mathbb{P}(B_i) P ( B i ∩ A ) = P ( A ∣ B i ) P ( B i ) P ( A ) = ∑ j P ( A ∣ B j ) P ( B j ) \mathbb{P}(A)=\sum_j\mathbb{P}(A\mid B_j)\mathbb{P}(B_j) P ( A ) = ∑ j P ( A ∣ B j ) P ( B j ) A A A
6.2 Bernoulli 与二项矩
对 X ∈ { 0 , 1 } X\in\{0,1\} X ∈ { 0 , 1 } E [ X ] = 0 ( 1 − p ) + 1 p = p \mathbb{E}[X]=0(1-p)+1p=p E [ X ] = 0 ( 1 − p ) + 1 p = p X 2 = X X^2=X X 2 = X
Var ( X ) = E [ X 2 ] − E [ X ] 2 = p − p 2 = p ( 1 − p ) .
\operatorname{Var}(X)=\mathbb{E}[X^2]-\mathbb{E}[X]^2
=p-p^2=p(1-p).
Var ( X ) = E [ X 2 ] − E [ X ] 2 = p − p 2 = p ( 1 − p ) . 令 K = ∑ i = 1 n X i K=\sum_{i=1}^nX_i K = ∑ i = 1 n X i E [ K ] = n p \mathbb{E}[K]=np E [ K ] = n p Var ( K ) = ∑ i Var ( X i ) = n p ( 1 − p ) \operatorname{Var}(K)=\sum_i\operatorname{Var}(X_i)=np(1-p) Var ( K ) = ∑ i Var ( X i ) = n p ( 1 − p )
二项概率公式是在 n n n k k k ( n k ) \binom nk ( k n ) p k ( 1 − p ) n − k p^k(1-p)^{n-k} p k ( 1 − p ) n − k
6.3 对数正态均值
若 Z ∼ N ( μ , σ 2 ) Z\sim N(\mu,\sigma^2) Z ∼ N ( μ , σ 2 ) E [ e t Z ] = e t μ + t 2 σ 2 / 2 \mathbb{E}[e^{tZ}]=e^{t\mu+t^2\sigma^2/2} E [ e tZ ] = e t μ + t 2 σ 2 /2 t = 1 t=1 t = 1 E [ Y ] = E [ e Z ] = e μ + σ 2 / 2 \mathbb{E}[Y]=\mathbb{E}[e^Z]=e^{\mu+\sigma^2/2} E [ Y ] = E [ e Z ] = e μ + σ 2 /2 t = 2 t=2 t = 2 E [ Y 2 ] = e 2 μ + 2 σ 2 \mathbb{E}[Y^2]=e^{2\mu+2\sigma^2} E [ Y 2 ] = e 2 μ + 2 σ 2
Var ( Y ) = e 2 μ + 2 σ 2 − e 2 μ + σ 2 = ( e σ 2 − 1 ) e 2 μ + σ 2 .
\operatorname{Var}(Y)=e^{2\mu+2\sigma^2}-e^{2\mu+\sigma^2}
=(e^{\sigma^2}-1)e^{2\mu+\sigma^2}.
Var ( Y ) = e 2 μ + 2 σ 2 − e 2 μ + σ 2 = ( e σ 2 − 1 ) e 2 μ + σ 2 . μ , σ \mu,\sigma μ , σ
6.4 大数定律
适用条件:两种大数定律结论
大数定律(law of large numbers,LLN)说在适当条件下样本平均趋近总体期望。若 X i X_i X i E ∣ X i ∣ < ∞ \mathbb{E}|X_i|<\infty E ∣ X i ∣ < ∞ X ˉ n → a . s . μ \bar X_n\xrightarrow{a.s.}\mu X ˉ n a . s . μ μ = E X i \mu=\mathbb{E}X_i μ = E X i σ 2 \sigma^2 σ 2
E [ X ˉ n ] = μ , Var ( X ˉ n ) = σ 2 n .
\mathbb{E}[\bar X_n]=\mu,\qquad
\operatorname{Var}(\bar X_n)=\frac{\sigma^2}{n}.
E [ X ˉ n ] = μ , Var ( X ˉ n ) = n σ 2 . 切比雪夫(Chebyshev)不等式给出
P ( ∣ X ˉ n − μ ∣ ≥ ϵ ) ≤ σ 2 / ( n ϵ 2 ) \mathbb{P}(|\bar X_n-\mu|\ge\epsilon)\le\sigma^2/(n\epsilon^2) P ( ∣ X ˉ n − μ ∣ ≥ ϵ ) ≤ σ 2 / ( n ϵ 2 ) ϵ > 0 \epsilon>0 ϵ > 0
6.5 中心极限定理
经典 i.i.d. 中心极限定理(central limit theorem,CLT)在 0 < σ 2 < ∞ 0<\sigma^2<\infty 0 < σ 2 < ∞
n ( X ˉ n − μ ) σ → d N ( 0 , 1 ) .
\frac{\sqrt n(\bar X_n-\mu)}{\sigma}\xrightarrow{d}N(0,1).
σ n ( X ˉ n − μ ) d N ( 0 , 1 ) . n n n μ \mu μ σ \sigma σ 标准化样本均值 ,不是原始观测 X i X_i X i t / n t/\sqrt n t / n n n n e − t 2 / 2 e^{-t^2/2} e − t 2 /2
对具有有限二阶矩的弱平稳(Weakly Stationary)序列,样本均值方差为
Var ( X ˉ n ) = 1 n 2 [ n γ 0 + 2 ∑ k = 1 n − 1 ( n − k ) γ k ] ,
\operatorname{Var}(\bar X_n)=
\frac{1}{n^2}\left[n\gamma_0+
2\sum_{k=1}^{n-1}(n-k)\gamma_k\right],
Var ( X ˉ n ) = n 2 1 [ n γ 0 + 2 k = 1 ∑ n − 1 ( n − k ) γ k ] , 其中 γ k = Cov ( X t , X t − k ) \gamma_k=\operatorname{Cov}(X_t,X_{t-k}) γ k = Cov ( X t , X t − k ) γ 0 \gamma_0 γ 0 X 2 X^2 X 2 σ 2 / n \sigma^2/n σ 2 / n
6.5a 零自协方差为什么仍不够:共享尺度的反例
完整反例:零自协方差下的非正态均值
令共同随机尺度(shared random scale) A A A 1 / 2 1/2 1/2 ε t \varepsilon_t ε t A A A X t = A ε t X_t=A\varepsilon_t X t = A ε t E [ A 2 ] = ( 1 + 4 ) / 2 = 2.5 \mathbb E[A^2]=(1+4)/2=2.5 E [ A 2 ] = ( 1 + 4 ) /2 = 2.5 s , t s,t s , t Cov ( X s , X t ) = E [ A 2 ] E [ ε s ε t ] = 0 \operatorname{Cov}(X_s,X_t)=\mathbb E[A^2]\mathbb E[\varepsilon_s\varepsilon_t]=0 Cov ( X s , X t ) = E [ A 2 ] E [ ε s ε t ] = 0
但一段中所有观察共用同一个尺度:看到较大的平方值,会改变你对其余观察波动大小的判断。直接核对得 Cov ( X s 2 , X t 2 ) = E [ A 4 ] − ( E [ A 2 ] ) 2 = ( 1 + 16 ) / 2 − 2.5 2 = 2.25 > 0 \operatorname{Cov}(X_s^2,X_t^2)=\mathbb E[A^4]-(\mathbb E[A^2])^2=(1+16)/2-2.5^2=2.25>0 Cov ( X s 2 , X t 2 ) = E [ A 4 ] − ( E [ A 2 ] ) 2 = ( 1 + 16 ) /2 − 2. 5 2 = 2.25 > 0
四阶矩(fourth moment)是 E [ Z 4 ] \mathbb E[Z^4] E [ Z 4 ] M Z ( t ) = e t 2 / 2 M_Z(t)=e^{t^2/2} M Z ( t ) = e t 2 /2 M Z ( 4 ) ( t ) = ( t 4 + 6 t 2 + 3 ) e t 2 / 2 M_Z^{(4)}(t)=(t^4+6t^2+3)e^{t^2/2} M Z ( 4 ) ( t ) = ( t 4 + 6 t 2 + 3 ) e t 2 /2 E [ Z 4 ] = M Z ( 4 ) ( 0 ) = 3 \mathbb E[Z^4]=M_Z^{(4)}(0)=3 E [ Z 4 ] = M Z ( 4 ) ( 0 ) = 3 Y = v Z Y=\sqrt v Z Y = v Z v v v E [ Y 4 ] = v 2 E [ Z 4 ] = 3 v 2 \mathbb E[Y^4]=v^2\mathbb E[Z^4]=3v^2 E [ Y 4 ] = v 2 E [ Z 4 ] = 3 v 2
对任意样本量 n n n A A A n X ˉ n ∼ N ( 0 , A 2 ) \sqrt n\bar X_n\sim N(0,A^2) n X ˉ n ∼ N ( 0 , A 2 ) 2.5 \sqrt{2.5} 2.5 N ( 0 , 0.4 ) N(0,0.4) N ( 0 , 0.4 ) N ( 0 , 1.6 ) N(0,1.6) N ( 0 , 1.6 ) 1 2 [ 3 ( 0.4 ) 2 + 3 ( 1.6 ) 2 ] = 4.08 \tfrac12[3(0.4)^2+3(1.6)^2]=4.08 2 1 [ 3 ( 0.4 ) 2 + 3 ( 1.6 ) 2 ] = 4.08 n n n 2.5 / n 2.5/n 2.5/ n
6.6 厚尾限制
厚尾(heavy tail)通常指尾概率相对正态或指数型基准衰减较慢;不同定义并不完全等同。Student t 是可计算的例子:自由度 ν ≤ 2 \nu\le2 ν ≤ 2
6.7 从离散过程到连续过程
对称随机游走令 ϵ i \epsilon_i ϵ i ± 1 \pm1 ± 1 1 / 2 1/2 1/2 S n = ∑ i = 1 n ϵ i S_n=\sum_{i=1}^n\epsilon_i S n = ∑ i = 1 n ϵ i E S n = 0 \mathbb{E}S_n=0 E S n = 0 Var ( S n ) = n \operatorname{Var}(S_n)=n Var ( S n ) = n 1 / n 1/n 1/ n 1 / n 1/\sqrt n 1/ n
W t ( n ) = 1 n ∑ i = 1 ⌊ n t ⌋ ϵ i , Var ( W t ( n ) ) = ⌊ n t ⌋ n → t .
W^{(n)}_t=\frac{1}{\sqrt n}\sum_{i=1}^{\lfloor nt\rfloor}\epsilon_i,
\qquad
\operatorname{Var}(W^{(n)}_t)=\frac{\lfloor nt\rfloor}{n}\to t.
W t ( n ) = n 1 i = 1 ∑ ⌊ n t ⌋ ϵ i , Var ( W t ( n ) ) = n ⌊ n t ⌋ → t . 功能型中心极限定理(functional central limit theorem)在合适条件下可将缩放随机游走的路径分布联系到 Brownian 运动;本章只用方差缩放解释直觉,不给出该定理的证明。
标准 Brownian 运动 ( W t ) t ≥ 0 (W_t)_{t\ge0} ( W t ) t ≥ 0 W 0 = 0 W_0=0 W 0 = 0 W t − W s ∼ N ( 0 , t − s ) W_t-W_s\sim N(0,t-s) W t − W s ∼ N ( 0 , t − s ) t t t W t W_t W t 时间 \sqrt{\text{时间}} 时间 Var ( W t ) = t \operatorname{Var}(W_t)=t Var ( W t ) = t
一个可核对的随机游走极限入口是 Donsker 不变原理:若增量 ϵ i \epsilon_i ϵ i S m = ∑ i = 1 m ϵ i S_m=\sum_{i=1}^m\epsilon_i S m = ∑ i = 1 m ϵ i 1 / n 1/n 1/ n 1 / n 1/\sqrt n 1/ n W n ( t ) = S ⌊ n t ⌋ / n W_n(t)=S_{\lfloor nt\rfloor}/\sqrt n W n ( t ) = S ⌊ n t ⌋ / n n n n ± 1 \pm1 ± 1
Brownian 运动若要驱动随机微积分,还必须相对于一个过滤族 ( F t ) (\mathcal F_t) ( F t ) F t \mathcal F_t F t t t t F t \mathcal F_t F t W t W_t W t W t − W s W_t-W_s W t − W s F s \mathcal F_s F s
6.8 全方差、组合方差与 Poisson 极限
令 m = E [ X ∣ G ] m=\mathbb{E}[X\mid\mathcal{G}] m = E [ X ∣ G ] μ = E [ X ] \mu=\mathbb{E}[X] μ = E [ X ] X − μ = ( X − m ) + ( m − μ ) X-\mu=(X-m)+(m-\mu) X − μ = ( X − m ) + ( m − μ ) E [ X − m ∣ G ] = 0 \mathbb{E}[X-m\mid\mathcal{G}]=0 E [ X − m ∣ G ] = 0 m − μ m-\mu m − μ G \mathcal{G} G
Var ( X ) = E [ ( X − m ) 2 ] + E [ ( m − μ ) 2 ] = E [ Var ( X ∣ G ) ] + Var ( m ) .
\operatorname{Var}(X)=
\mathbb{E}[(X-m)^2]+\mathbb{E}[(m-\mu)^2]
=\mathbb{E}[\operatorname{Var}(X\mid\mathcal{G})]
+\operatorname{Var}(m).
Var ( X ) = E [( X − m ) 2 ] + E [( m − μ ) 2 ] = E [ Var ( X ∣ G )] + Var ( m ) . 各项单位都是 X 2 X^2 X 2 R p = w ⊤ R R_p=w^\top R R p = w ⊤ R
Var ( R p ) = E [ ( w ⊤ ( R − E R ) ) 2 ] = w ⊤ E [ ( R − E R ) ( R − E R ) ⊤ ] w = w ⊤ Σ w .
\operatorname{Var}(R_p)
=\mathbb{E}\!\left[(w^\top(R-\mathbb{E}R))^2\right]
=w^\top\mathbb{E}\!\left[(R-\mathbb{E}R)(R-\mathbb{E}R)^\top\right]w
=w^\top\Sigma w.
Var ( R p ) = E [ ( w ⊤ ( R − E R ) ) 2 ] = w ⊤ E [ ( R − E R ) ( R − E R ) ⊤ ] w = w ⊤ Σ w . w w w Σ \Sigma Σ
Poisson 分布也可看作稀疏独立事件的极限。把长度 T T T m m m ρ T / m \rho T/m ρT / m K m ∼ Binomial ( m , ρ T / m ) K_m\sim\operatorname{Binomial}(m,\rho T/m) K m ∼ Binomial ( m , ρT / m ) k k k m → ∞ m\to\infty m → ∞
P ( K m = k ) = ( m k ) ( ρ T m ) k ( 1 − ρ T m ) m − k ⟶ e − ρ T ( ρ T ) k k ! .
\mathbb{P}(K_m=k)
=\binom{m}{k}\left(\frac{\rho T}{m}\right)^k
\left(1-\frac{\rho T}{m}\right)^{m-k}
\longrightarrow e^{-\rho T}\frac{(\rho T)^k}{k!}.
P ( K m = k ) = ( k m ) ( m ρT ) k ( 1 − m ρT ) m − k ⟶ e − ρT k ! ( ρT ) k . ρ \rho ρ T T T ρ T \rho T ρT
6.9 Markov 与 Poisson 过程
离散时间 Markov 性质表达“当前状态概括了预测未来所需的历史”:
P ( X t + 1 ∈ A ∣ X 0 , … , X t ) = P ( X t + 1 ∈ A ∣ X t ) .
\mathbb{P}(X_{t+1}\in A\mid X_0,\ldots,X_t)=
\mathbb{P}(X_{t+1}\in A\mid X_t).
P ( X t + 1 ∈ A ∣ X 0 , … , X t ) = P ( X t + 1 ∈ A ∣ X t ) . A A A P P P P i j = P ( X t + 1 = j ∣ X t = i ) P_{ij}=\mathbb{P}(X_{t+1}=j\mid X_t=i) P ij = P ( X t + 1 = j ∣ X t = i ) t t t
计数过程 N ( t ) N(t) N ( t ) N ( 0 ) = 0 N(0)=0 N ( 0 ) = 0 ρ ≥ 0 \rho\ge0 ρ ≥ 0
N ( t ) − N ( s ) ∼ Poisson ( ρ ( t − s ) ) , 0 ≤ s < t .
N(t)-N(s)\sim\operatorname{Poisson}(\rho(t-s)),\quad 0\le s<t.
N ( t ) − N ( s ) ∼ Poisson ( ρ ( t − s )) , 0 ≤ s < t . 因此 E [ N ( t ) ] = Var ( N ( t ) ) = ρ t \mathbb{E}[N(t)]=\operatorname{Var}(N(t))=\rho t E [ N ( t )] = Var ( N ( t )) = ρt
当 ρ > 0 \rho>0 ρ > 0 Exponential ( ρ ) \operatorname{Exponential}(\rho) Exponential ( ρ ) ρ = 0 \rho=0 ρ = 0
7. 金融解释
7.1 条件化是信息时点问题
在交易或风险研究中,“已知信息”必须对应可用时点。设 F t \mathcal{F}_t F t t t t E [ R t + 1 ∣ F t ] \mathbb{E}[R_{t+1}\mid\mathcal{F}_t] E [ R t + 1 ∣ F t ]
7.2 协方差连接单项风险与组合风险
两个资产各自风险不变时,相关性变化仍会改变组合方差。若权重为 w 1 , w 2 w_1,w_2 w 1 , w 2 2 w 1 w 2 Cov ( R 1 , R 2 ) 2w_1w_2\operatorname{Cov}(R_1,R_2) 2 w 1 w 2 Cov ( R 1 , R 2 )
7.3 分布是近似工具,不是资产标签
Bernoulli/二项可用于固定期间内的违约指示或成功次数建模,但需要定义“违约”、观察窗口和共同冲击。
正态便于求和与推导,但金融收益可能有偏态、厚尾、波动聚集或极端跳跃。
对数正态适合严格为正的乘法量,比如某些价格模型中的终值;它不意味着简单收益也服从对数正态。
Poisson 可作为事件计数基准模型。过度离散、簇集或强度变化是需要检验的反例。
Student t 可用有限自由度增加尾部质量,但若估计出的自由度过低,部分矩不存在,依赖这些矩的指标也随之不成立。
7.4 过程模型要说明它保留了什么
随机游走把增量累加,适合课堂展示路径随机性与均值/方差增长。Markov 过程压缩历史信息;要说明状态定义、转移概率是否随时间变、参数如何估计。Poisson 过程模拟到达次数;要验证独立增量和稳定强度。Brownian 运动以连续路径与高斯增量为核心,是连续时间模型入口。四者都不能仅因为画出的路径“像价格”就作为价格生成过程的证据。
8. Numerical Example
以下数字全部是教学构造,用于手算和代码核验,不是市场频率、策略绩效或风险参数。
8.1 低基率告警:Bayes 更新
完整例题:低基率告警的Bayes更新
令事件先验概率为 0.005 0.005 0.005 0.95 0.95 0.95 0.05 0.05 0.05
P ( E ∩ + ) = 0.005 × 0.95 = 0.00475 ,
\mathbb{P}(E\cap +)=0.005\times0.95=0.00475,
P ( E ∩ + ) = 0.005 × 0.95 = 0.00475 , P ( + ) = 0.00475 + ( 1 − 0.005 ) × 0.05 = 0.00475 + 0.04975 = 0.05450 ,
\mathbb{P}(+)=0.00475+(1-0.005)\times0.05
=0.00475+0.04975=0.05450,
P ( + ) = 0.00475 + ( 1 − 0.005 ) × 0.05 = 0.00475 + 0.04975 = 0.05450 , P ( E ∣ + ) = 0.00475 0.05450 = 0.0871559633 ≈ 8.7156 % .
\mathbb{P}(E\mid +)=\frac{0.00475}{0.05450}
=0.0871559633\approx 8.7156\%.
P ( E ∣ + ) = 0.05450 0.00475 = 0.0871559633 ≈ 8.7156%. E E E + + +
把同一模型换成 200,000 个对象的基数表。下表是由给定概率换算的模型期望频数,不是一次实际抽样的保证计数:
真实状态
阳性告警
阴性告警
合计
事件发生
950
50
1,000
事件未发生
9,950
189,050
199,000
合计
10,900
189,100
200,000
阳性这一列的分母是 950 + 9 , 950 = 10 , 900 950+9,950=10,900 950 + 9 , 950 = 10 , 900 950 / 10 , 900 = 19 / 218 ≈ 0.08715596 950/10,900=19/218\approx0.08715596 950/10 , 900 = 19/218 ≈ 0.08715596
8.2 Bernoulli 总数与组合协方差
若每次独立试验 p = 0.30 p=0.30 p = 0.30 n = 20 n=20 n = 20 K ∼ Binomial ( 20 , 0.30 ) K\sim\operatorname{Binomial}(20,0.30) K ∼ Binomial ( 20 , 0.30 )
E [ K ] = 20 ( 0.30 ) = 6 , Var ( K ) = 20 ( 0.30 ) ( 0.70 ) = 4.2.
\mathbb{E}[K]=20(0.30)=6,\qquad
\operatorname{Var}(K)=20(0.30)(0.70)=4.2.
E [ K ] = 20 ( 0.30 ) = 6 , Var ( K ) = 20 ( 0.30 ) ( 0.70 ) = 4.2. 方差单位是“成功次数平方”。
完整例题:四状态组合与条件方差
再用四个等概率状态构造两资产日收益(小数):( R A , R B ) (R_A,R_B) ( R A , R B ) ( 0.1 , 0.1 ) (0.1,0.1) ( 0.1 , 0.1 ) ( − 0.1 , − 0.1 ) (-0.1,-0.1) ( − 0.1 , − 0.1 ) ( 0.1 , − 0.1 ) (0.1,-0.1) ( 0.1 , − 0.1 ) ( − 0.1 , 0.1 ) (-0.1,0.1) ( − 0.1 , 0.1 ) 0.01 0.01 0.01 0.1 , − 0.1 , 0 , 0 0.1,-0.1,0,0 0.1 , − 0.1 , 0 , 0 ( 0.01 + 0.01 + 0 + 0 ) / 4 = 0.005 (0.01+0.01+0+0)/4=0.005 ( 0.01 + 0.01 + 0 + 0 ) /4 = 0.005 0.01 0.01 0.01 0.01 0.01 0.01 0.01 0.01 0.01
还可用同一构造演示全期望与全方差。令 C C C P ( C ) = P ( C c ) = 1 / 2 \mathbb P(C)=\mathbb P(C^c)=1/2 P ( C ) = P ( C c ) = 1/2 G = σ ( 1 C ) \mathcal G=\sigma(\mathbf 1_C) G = σ ( 1 C ) C C C C C C 0.1 , − 0.1 0.1,-0.1 0.1 , − 0.1 0.01 0.01 0.01 C c C^c C c 0 , 0 0,0 0 , 0 E [ R p ] = 1 2 ( 0 ) + 1 2 ( 0 ) = 0 \mathbb E[R_p]=\tfrac12(0)+\tfrac12(0)=0 E [ R p ] = 2 1 ( 0 ) + 2 1 ( 0 ) = 0
Var ( R p ) = E [ Var ( R p ∣ G ) ] + Var ( E [ R p ∣ G ] ) = 1 2 ( 0.01 ) + 1 2 ( 0 ) + 0 = 0.005 ,
\operatorname{Var}(R_p)=\mathbb E[\operatorname{Var}(R_p\mid\mathcal G)]+\operatorname{Var}(\mathbb E[R_p\mid\mathcal G])
=\tfrac12(0.01)+\tfrac12(0)+0=0.005,
Var ( R p ) = E [ Var ( R p ∣ G )] + Var ( E [ R p ∣ G ]) = 2 1 ( 0.01 ) + 2 1 ( 0 ) + 0 = 0.005 , 与四状态直接计算一致。
8.3 对数正态的均值和中位数
令单期对数增长 Z ∼ N ( 0.08 , 0.20 2 ) Z\sim N(0.08,0.20^2) Z ∼ N ( 0.08 , 0.2 0 2 ) G = e Z G=e^Z G = e Z e 0.08 ≈ 1.0833 e^{0.08}\approx1.0833 e 0.08 ≈ 1.0833 E [ G ] = e 0.08 + 0.20 2 / 2 = e 0.10 ≈ 1.1052 \mathbb{E}[G]=e^{0.08+0.20^2/2}=e^{0.10}\approx1.1052 E [ G ] = e 0.08 + 0.2 0 2 /2 = e 0.10 ≈ 1.1052 G G G
8.4 Poisson 计数
若构造过程的速率为每小时 0.7 0.7 0.7 λ = 0.7 × 5 = 3.5 \lambda=0.7\times5=3.5 λ = 0.7 × 5 = 3.5
8.5 学生 t 分布、随机游走与布朗尺度
标准学生 t 分布取自由度 ν = 4 \nu=4 ν = 4 4 / ( 4 − 2 ) = 2 4/(4-2)=2 4/ ( 4 − 2 ) = 2 2 \sqrt{2} 2
对称随机游走 S n S_n S n + 1 +1 + 1 − 1 -1 − 1 n = 4 n=4 n = 4 E [ S 4 ] = 0 \mathbb{E}[S_4]=0 E [ S 4 ] = 0 Var ( S 4 ) = 4 \operatorname{Var}(S_4)=4 Var ( S 4 ) = 4 t = 4 t=4 t = 4 Var ( W 4 ) = 4 \operatorname{Var}(W_4)=4 Var ( W 4 ) = 4 2 小时 2\sqrt{\text{小时}} 2 小时
8.6 两状态马尔可夫链(Markov chain)
用构造转移矩阵
P = ( 0.9 0.1 0.3 0.7 )
P=\begin{pmatrix}0.9&0.1\\0.3&0.7\end{pmatrix}
P = ( 0.9 0.3 0.1 0.7 ) 表示两状态 A , B A,B A , B π 0 = ( 0.5 , 0.5 ) \pi_0=(0.5,0.5) π 0 = ( 0.5 , 0.5 ) π 1 = π 0 P = ( 0.6 , 0.4 ) \pi_1=\pi_0P=(0.6,0.4) π 1 = π 0 P = ( 0.6 , 0.4 ) π 2 = π 1 P = ( 0.66 , 0.34 ) \pi_2=\pi_1P=(0.66,0.34) π 2 = π 1 P = ( 0.66 , 0.34 )
9. Python Implementation
本读者版的默认运行入口
从接受I3读者包的根目录,按其README 建立独立环境后运行:
.venv/bin/python run_notebook.py notebooks/ch06_probability.ipynb
该Notebook调用随包共享实现,不读取未随包提供的French数据、不下载数据;每次写入唯一UUID的runs子目录,并打印实际输出位置。旧制作测试与下面的历史课程根命令属于原工作项目;读者默认运行使用上述包根Notebook及其断言。可选历史French路径需遵守读者包的数据契约 ,本批未重跑。
历史课程根路线
脚本 ch06_probability.py 集中实现 Bayes 计算、Bernoulli/二项矩和四种固定种子构造模拟。它调用 NumPy 的局部随机生成器(Generator),不会改写全局随机状态;参数越界、非有限概率和未定义的条件事件会报错。模拟不使用金融数据,也不做全局 shuffle。
从项目根目录运行:
.venv/bin/python code/ch06_probability.py --seed 641 --output-dir figures/a2
.venv/bin/python -m pytest tests/test_ch06_probability.py -q
测试覆盖:Bayes 分母、矩的闭式值、相同种子可复现、LLN/CLT 构造样本的矩、随机游走步长、Poisson 计数单调性与均值方差,以及四张图均实际写盘。本地验证环境为 Python 3.14.7、NumPy 2.5.3、SciPy 1.18.1;依赖版本以课程项目当前 .venv 为准。
以下片段独立演示第 8.1 节;输入、导入和断言都在片段内,容差用于避免浮点尾差:
import math
prior = 0.005
sensitivity = 0.95
false_positive_rate = 0.05
joint_event_and_positive = prior * sensitivity
positive_rate = joint_event_and_positive + (1 - prior) * false_positive_rate
posterior = joint_event_and_positive / positive_rate
assert math.isclose(positive_rate, 0.0545 , rel_tol=0.0 , abs_tol=1e-12 )
assert math.isclose(posterior, 0.0871559633027523 , rel_tol=0.0 , abs_tol=1e-12 )
print (f"P(event | positive) = {posterior:.4 %} " )
import numpy as np
from scipy import stats
rate_per_hour = 0.7
waiting = stats.expon(scale=1.0 / rate_per_hour)
no_arrival_in_five_hours = waiting.sf(5.0 )
zero_count_probability = stats.poisson.pmf(0 , mu=rate_per_hour * 5.0 )
assert np.isclose(no_arrival_in_five_hours, zero_count_probability)
assert np.isclose(waiting.mean(), 1.0 / rate_per_hour)
assert np.isclose(waiting.sf(3.0 + 2.0 ) / waiting.sf(3.0 ), waiting.sf(2.0 ))
uniform_probability = stats.uniform.cdf(0.5 ) - stats.uniform.cdf(0.2 )
assert np.isclose(uniform_probability, 0.3 )
print ("constructed waiting time mean, hours" , waiting.mean())
print ("constructed P(no arrival in 5 hours)" , no_arrival_in_five_hours)
上述等待时间示例明确以小时为单位,其余过程图使用指定的构造时间单位。程序示例没有行情采样频率、信号时间或交易时间,因为它没有使用证券记录;脚本中的过程时间是无量纲教学时间。若以后将事件概率用于真实信号,需另行定义事件窗、信息截止时点、成交时点和收益测量区间。
10. Visualization
以下图由本章脚本实际生成,均为构造模拟。纵轴和横轴都在图中标出;种子明确写在标题中。
10.1 LLN 样本均值轨迹
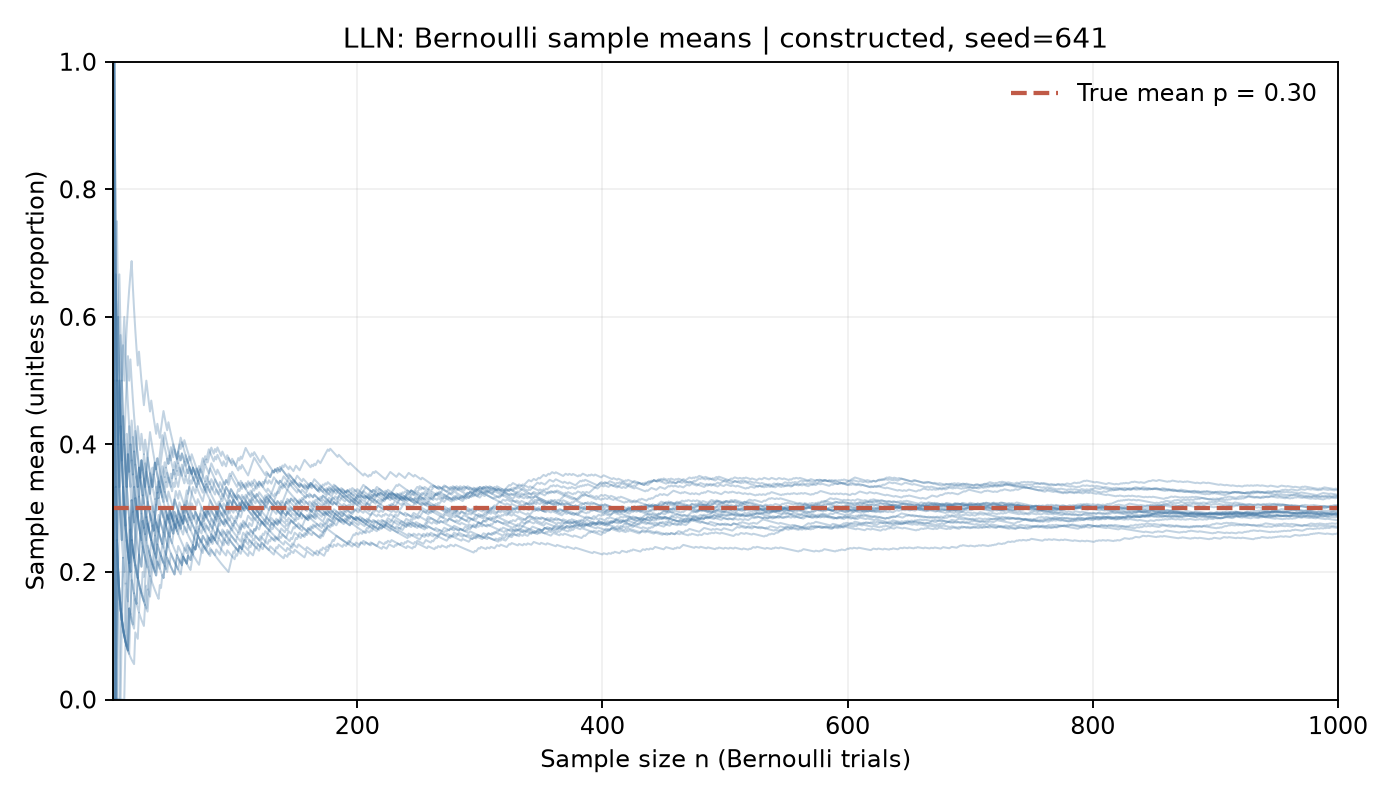
横轴是 Bernoulli 试验数 n = 1 , … , 1000 n=1,\ldots,1000 n = 1 , … , 1000 p = 0.30 p=0.30 p = 0.30 p p p
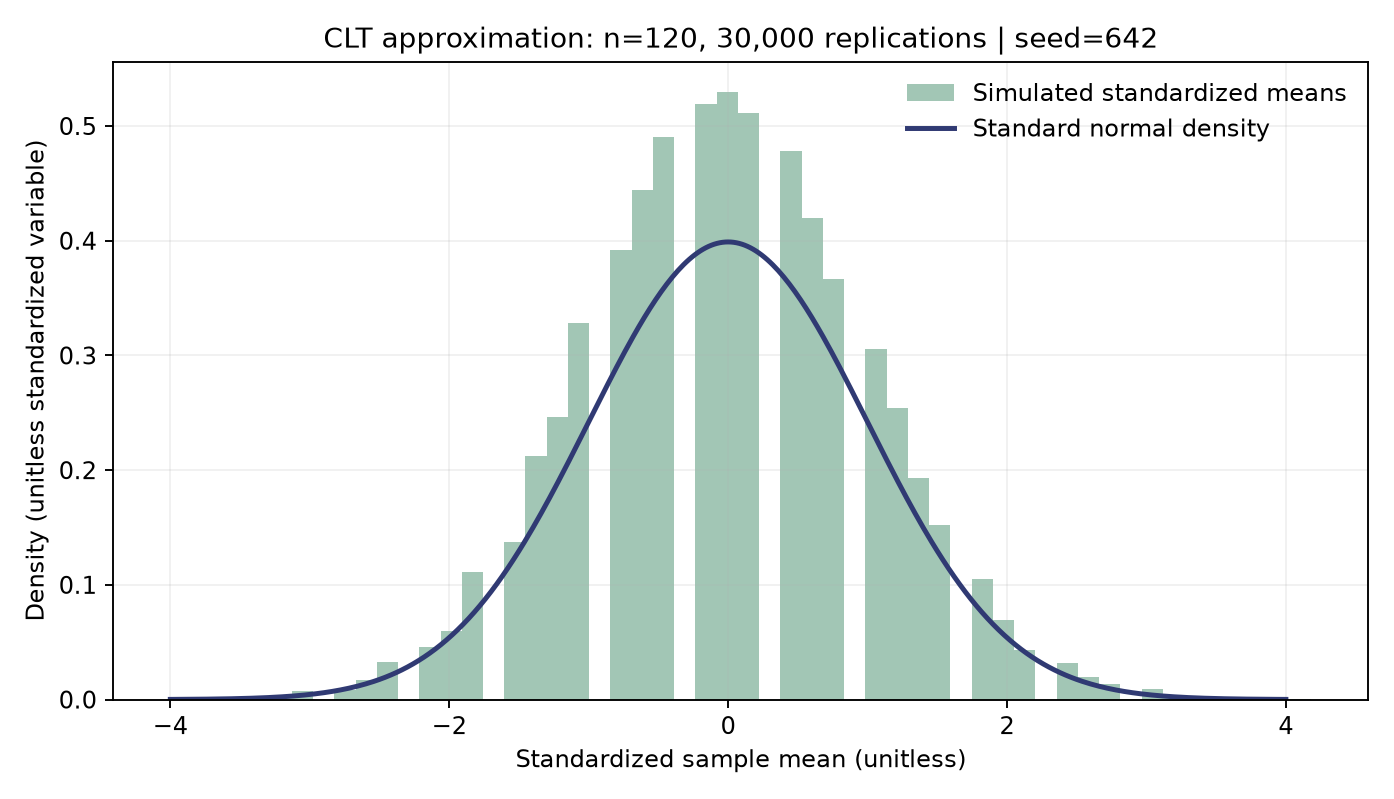
10.2 CLT 标准化样本均值
横轴是 n = 120 n=120 n = 120 n n n
每次重复先抽 n = 120 n=120 n = 120 ( p = 0.30 ) (p=0.30) ( p = 0.30 ) Z n , m = ( X ˉ n , m − p ) / p ( 1 − p ) / n Z_{n,m}=(\bar X_{n,m}-p)/\sqrt{p(1-p)/n} Z n , m = ( X ˉ n , m − p ) / p ( 1 − p ) / n m = 1 , … , 30,000 m=1,\ldots,30{,}000 m = 1 , … , 30 , 000
10.3 对称随机游走
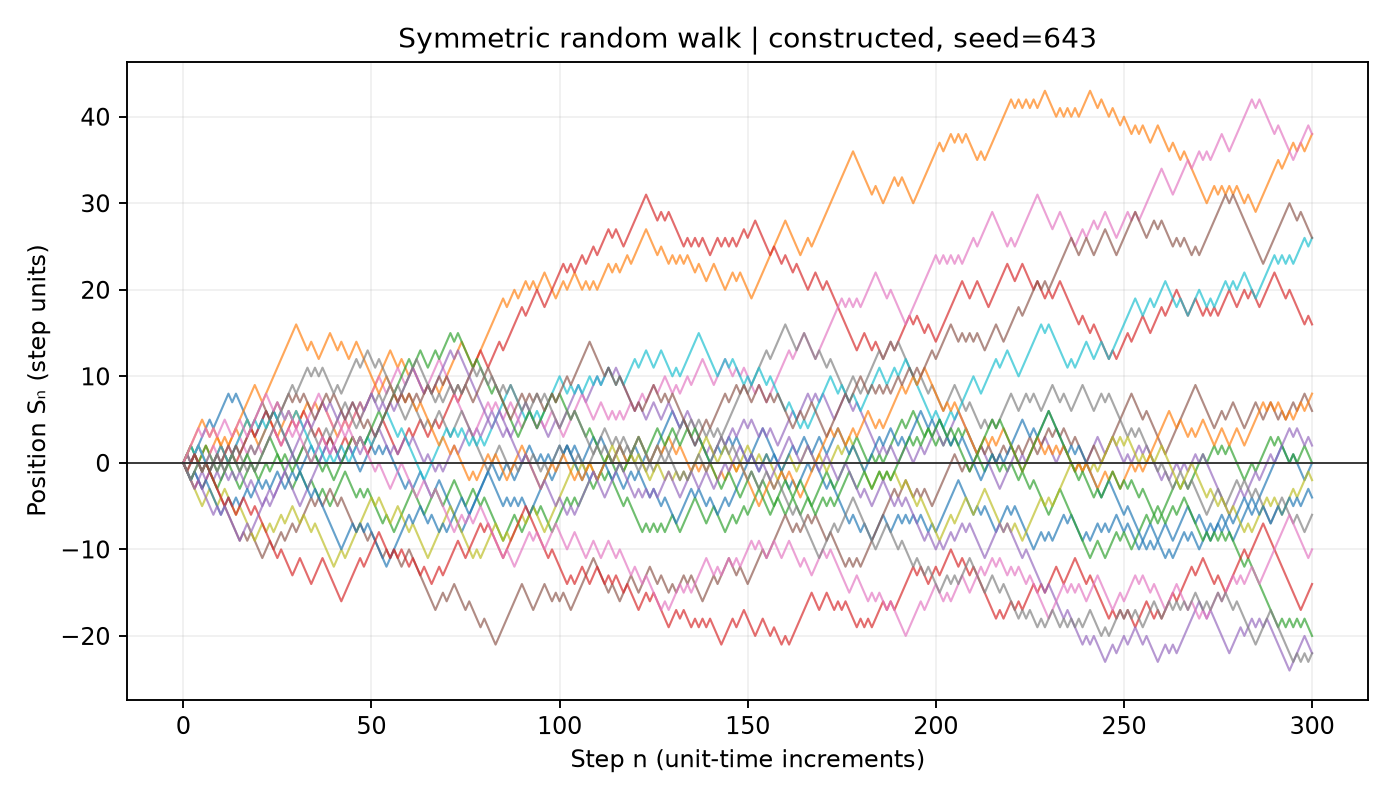
横轴是 0 至 300 的步数,纵轴是累计位置;18 条路径各由独立的 + 1 / − 1 +1/-1 + 1/ − 1
10.4 Poisson 计数过程
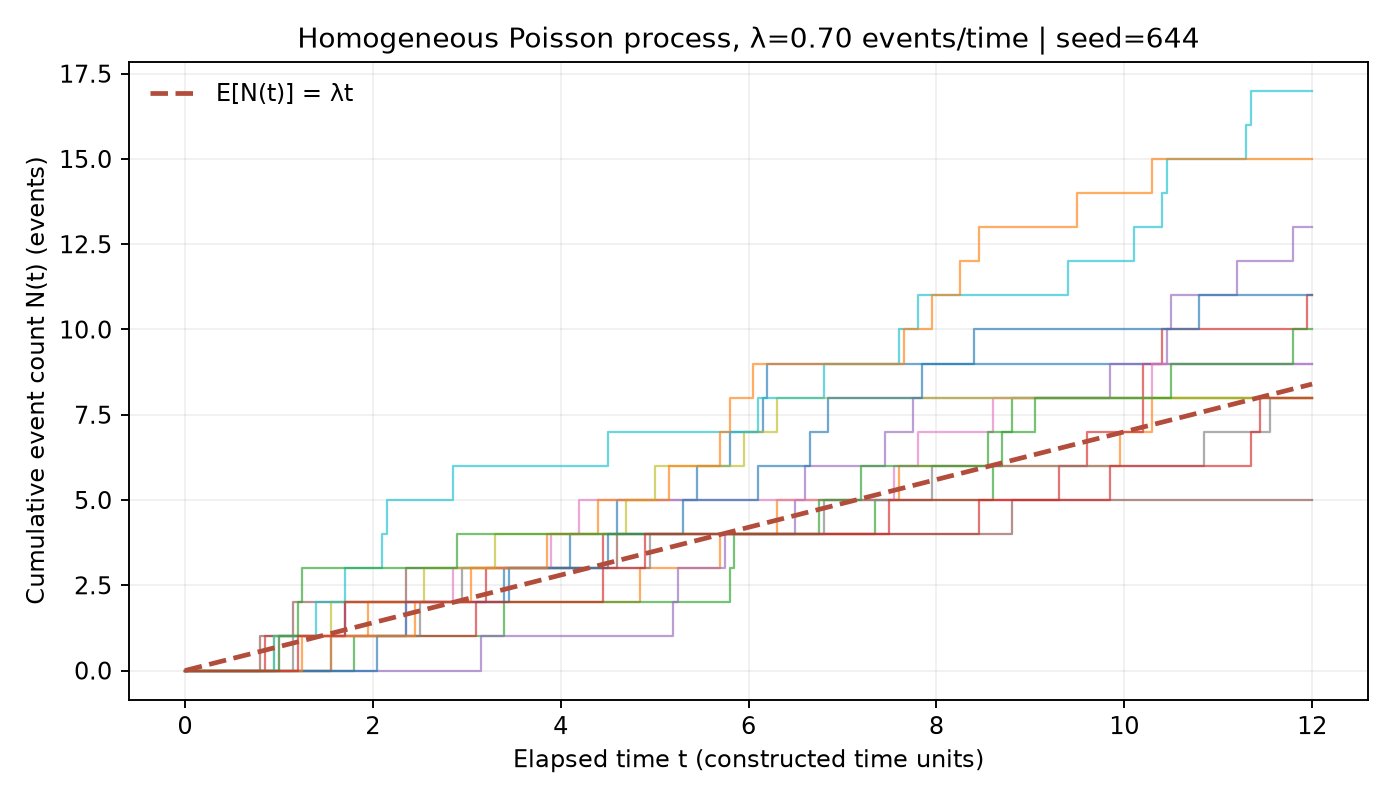
横轴是 0 至 12 的构造时间单位,纵轴是累计计数;14 条阶梯路径在 240 个等长时间格上由独立 Poisson 增量生成(格宽为 0.05),虚线为理论均值 ρ t \rho t ρt ρ = 0.70 \rho=0.70 ρ = 0.70
复现命令和种子见第 9 节。四幅图用于说明定义、收敛趋势与计数结构,不用于证明真实数据满足相同过程假设。
11. Real Market Example
本章没有下载或检验真实证券、订单、违约或收益数据,因此不报告真实市场频率、拟合参数、样本内/外结果,也不把构造告警称为“实证案例”。这一步是有意保留的证据边界:课程官方讲义和分布 API 能支持定义与计算方法,不能支持某一市场服从某个分布的判断。
将来若做真实案例,可先选定带来源与许可的数据集,再记录发行人/交易所、事件定义、样本期、观测频率、下载时间、版本和校验摘要。检验告警价值时,需要避免把测试期基率、真实标签时点或修订后数据泄漏给信号时点;检验计数模型时,需要查看间隔分布、日内季节性、聚集和强度变化。没有完成这些检查前,只能称为待检验模型。
12. Common Mistakes
12.1 把灵敏度当成阳性后的事件概率
P ( + ∣ E ) \mathbb{P}(+\mid E) P ( + ∣ E ) P ( E ∣ + ) \mathbb{P}(E\mid +) P ( E ∣ + )
prior = 0.005
sensitivity = 0.95
false_positive_rate = 0.05
sensitivity_value = sensitivity
posterior_value = prior * sensitivity / (
prior * sensitivity + (1 - prior) * false_positive_rate
)
print (f"P(positive | event) = {sensitivity_value:.2 %} " )
print (f"P(event | positive) = {posterior_value:.4 %} " )
输出分别为 95.00% 和约 8.7156%。如果只报告第一个数,就没有回答阳性告警的可信度。
12.2 把 PDF 高度当作概率
密度有单位,单点概率要通过区间积分取得。下面例子使用标准正态:
from scipy.stats import norm
density_at_zero = norm.pdf(0.0 )
probability_near_zero = norm.cdf(0.01 ) - norm.cdf(-0.01 )
print (f"density at zero = {density_at_zero:.6 f} " )
print (f"P(-0.01 < Z < 0.01) = {probability_near_zero:.6 f} " )
density_at_zero 约为 0.398942,而区间概率约为 0.007979。前者不是 P ( Z = 0 ) P(Z=0) P ( Z = 0 )
12.3 见到厚尾就直接套有限方差 CLT
Student t 自由度为 1 时没有有限均值或方差。SciPy 的矩接口对不存在的矩会返回非有限结果;具体结果可随函数约定呈现为无穷或 NaN:
import numpy as np
from scipy.stats import t
mean, variance = t.stats(df=1 , moments="mv" )
assert not np.isfinite(mean)
assert not np.isfinite(variance)
print ("df=1: population mean and variance do not exist" )
有限样本的样本均值当然可以算,但不能用“不存在的总体标准差”标准化,再宣称经典 CLT 正态近似已获保证。
12.4 在每个时点独立重抽累计计数
若把 N ( t 1 ) , N ( t 2 ) , … N(t_1),N(t_2),\ldots N ( t 1 ) , N ( t 2 ) , …
import numpy as np
rng = np.random.default_rng(644 )
rate = 0.7
horizon = 12.0
n_intervals = 240
dt = horizon / n_intervals
increments = rng.poisson(lam=rate * dt, size=n_intervals)
counts = np.concatenate(([0 ], np.cumsum(increments)))
assert np.all (np.diff(counts) >= 0 )
assert counts[0 ] == 0
print (f"terminal count = {counts[-1 ]} " )
累加保证路径非递减,且不相交区间计数来自独立增量。脚本中的过程模拟同样先抽增量再取累计和。
12.5 零相关不等于独立
常见误区:零相关不等于独立
取 X ∼ Uniform ( − 1 , 1 ) X\sim\operatorname{Uniform}(-1,1) X ∼ Uniform ( − 1 , 1 ) Y = X 2 Y=X^2 Y = X 2 E [ X ] = E [ X 3 ] = 0 \mathbb E[X]=\mathbb E[X^3]=0 E [ X ] = E [ X 3 ] = 0 Cov ( X , Y ) = 0 \operatorname{Cov}(X,Y)=0 Cov ( X , Y ) = 0 Y Y Y X X X
13. Quant Research Application
设研究目标为“某个已定义的未来窗口内是否发生极端亏损”。严谨的概率流程可以按以下顺序建立:
定义事件 :例如未来一个交易日组合简单收益低于指定阈值。说明收益区间、净/毛口径、时区和标签何时可知。定义信息集 :信号时点只能使用当时已知的数据;令该信息为 F t \mathcal{F}_t F t F t \mathcal{F}_t F t t t t R t + 1 R_{t+1} R t + 1 选择估计对象 :预测条件事件概率 P ( E t + 1 = 1 ∣ F t ) \mathbb{P}(E_{t+1}=1\mid\mathcal{F}_t) P ( E t + 1 = 1 ∣ F t ) 选择基线与条件模型 :先报告无条件基率,再评估条件特征是否改善预测。对概率输出检查校准、分组基率和样本外(out-of-sample)损失;类别不平衡时报告查准率(precision)、查全率(recall)与假阳性负担,不能只报准确率(accuracy)。检查依赖与尾部 :时间序列(time series)标签可能重叠且收益可能相关;用相应时间切分和依赖稳健的不确定性评估。重采样方案要保留时间结构,禁止全局 shuffle 后把观测当 iid。转成行动并计入成本 :阈值应由误报/漏报损失、资本、流动性、成交延迟和交易成本决定。预测概率本身不等于交易规则,也不代表净收益。反证与稳健性 :改变基率、窗口、市场状态与阈值;与历史基线比较;检查参数漂移、重述、缺失和分布外情况。若表现依赖单一窗口或少数事件,应降低结论强度。
若某条件模型对阳性给出后验概率 q t q_t q t C F P C_{FP} C F P C F N C_{FN} C F N C F P ( 1 − q t ) C_{FP}(1-q_t) C F P ( 1 − q t ) C F N q t C_{FN}q_t C F N q t
q t > C F P C F P + C F N .
q_t>\frac{C_{FP}}{C_{FP}+C_{FN}}.
q t > C F P + C F N C F P . q t q_t q t
14. Chapter Summary
概率公理定义事件概率;条件概率和 Bayes 公式说明如何在新信息后重估状态概率。随机变量把结果映射成数值,分布、期望、方差和协方差分别描述取值规律、中心、离散程度和共同变化。组合风险需要协方差而非仅有单资产方差。
常见分布带有明确的支持集、参数和矩条件。LLN 的结论是样本均值在假设下靠近总体均值;CLT 是标准化均值的渐近分布。相关、重叠、非平稳和无限方差都会改变可用结论。随机游走、Markov、Poisson 与 Brownian 运动各自保留不同的路径结构。模型假设必须由目标数据验证;本章模拟只演示构造参数下的数学性质。
15. Exercises
题号 6-E01 至 6-E07;所有数字均为题目构造,不指向真实市场。
6-E01(概念) 样本空间、事件、互斥和独立分别是什么意思?互斥事件是否一定独立?请用一个有正概率的简单例子说明。
6-E02(概念) 若 P ( A ) = 0.2 \mathbb{P}(A)=0.2 P ( A ) = 0.2 P ( B ) = 0.5 \mathbb{P}(B)=0.5 P ( B ) = 0.5 P ( A ∣ B ) \mathbb{P}(A\mid B) P ( A ∣ B )
6-E03(概念) 连续型变量的 PDF 在某点等于 0.4,能否说该点概率为 40%?说明正确计算区间概率的方法及 PDF 单位。
6-E04(概念) 区分 LLN 和 CLT 各自描述的对象,并列出经典 i.i.d. 有限方差 CLT 的条件。厚尾 t 分布自由度为 1 时,哪些总体矩不存在?
6-E05(手算) 某二元信号的先验事件概率为 0.02 0.02 0.02 0.80 0.80 0.80 0.10 0.10 0.10
6-E06(手算) X ∼ Bernoulli ( 0.25 ) X\sim\operatorname{Bernoulli}(0.25) X ∼ Bernoulli ( 0.25 )
6-E07(手算与解释) N ( t ) N(t) N ( t ) 1.2 1.2 1.2
新增题号 6-N01 至 6-N05;数字仍为教学构造。
6-N01(识别) 两次独立 Bernoulli( 0.30 ) (0.30) ( 0.30 ) A = { 两次都成功 } A=\{\text{两次都成功}\} A = { 两次都成功 } B = { 至少一次成功 } B=\{\text{至少一次成功}\} B = { 至少一次成功 } X X X X X X
6-N02(单步计算) 使用 6-N01 的试验,只计算 P ( A ∣ B ) \mathbb P(A\mid B) P ( A ∣ B )
6-N03(完整计算) 使用 6-N01 的结果概率表,先列出 X = 0 , 1 , 2 X=0,1,2 X = 0 , 1 , 2 E [ X ] \mathbb E[X] E [ X ] E [ X 2 ] \mathbb E[X^2] E [ X 2 ] Var ( X ) \operatorname{Var}(X) Var ( X )
6-N04(代码诊断) 程序对每份大小为 n n n ( p ) (p) ( p ) z = ( X ˉ − p ) / p ( 1 − p ) z=(\bar X-p)/\sqrt{p(1-p)} z = ( X ˉ − p ) / p ( 1 − p ) z z z
6-N05(研究判断) 研究者看到一次固定种子的 i.i.d. 模拟均值直方图近似钟形,又看到真实月收益样本的自相关检验未拒绝零相关,于是写道:“真实收益已证实 i.i.d. 正态;信号导致了后续亏损;经典 CLT 区间有效。”逐项评估这三个判断。列出建立预测结论、因果结论和均值区间分别还需明确的对象或条件。
6-B01(依赖反例) 使用第6.5a节的共享尺度构造,说明 A A A Z n = n X ˉ n / 2.5 Z_n=\sqrt n\bar X_n/\sqrt{2.5} Z n = n X ˉ n / 2.5 Var ( X ˉ n ) = 2.5 / n \operatorname{Var}(\bar X_n)=2.5/n Var ( X ˉ n ) = 2.5/ n Z n Z_n Z n
16. Programming Exercises
题号 6-P01 至 6-P03。所有编程题都须能在 Python 3 的 NumPy/SciPy 环境独立运行;随机数必须使用函数局部 default_rng 和指定种子,不能调用全局 shuffle。
6-P01(条件概率) 使用第 8.1 节低基率参数,计算总阳性率、阳性后的事件率。打印两者;用 math.isclose 断言总阳性率为 0.0545、后验约为 0.0871559633。
6-P02(LLN 与 CLT) 用种子 6202 生成 p = 0.3 p=0.3 p = 0.3 n = 100 n=100 n = 100
6-P03(过程路径) 用种子 6204 生成 300 步对称随机游走和速率 ρ = 0.7 \rho=0.7 ρ = 0.7 T = 10 T=10 T = 10 { − 1 , 1 } \{-1,1\} { − 1 , 1 }
17. Challenge Problems
6-C01(相关性与有效样本量) 设 X t X_t X t ρ k = 0.5 k \rho_k=0.5^k ρ k = 0. 5 k n = 4 n=4 n = 4 Var ( X ˉ 4 ) \operatorname{Var}(\bar X_4) Var ( X ˉ 4 )
6-C02(状态切换、Poisson 与扩散边界) 提出一个包含有限状态 Markov 状态、状态依赖事件强度和条件连续收益的概念模型。说明:
(a) 状态转移假设;(b) Poisson 计数的条件强度;(c) 连续收益若近似 Brownian 增量需满足什么结构;(d) 哪些现实特征可能使模型失效;(e) 如何设计样本外检验。给出一个能反驳模型的诊断。评分:状态和信息时点 2 分,强度与增量条件 2 分,Brownian 限制 2 分,失效因素及反证检验 2 分。答案可以多样,但必须明确这是待验证模型而非事实。
18. Solutions / Solution Hints
6-E01
互斥指 A ∩ B = ∅ A\cap B=\varnothing A ∩ B = ∅ P ( A ) > 0 , P ( B ) > 0 \mathbb{P}(A)>0,\mathbb{P}(B)>0 P ( A ) > 0 , P ( B ) > 0 P ( A ∩ B ) = 0 \mathbb{P}(A\cap B)=0 P ( A ∩ B ) = 0 P ( A ) P ( B ) > 0 \mathbb{P}(A)\mathbb{P}(B)>0 P ( A ) P ( B ) > 0 A = { 1 } A=\{1\} A = { 1 } B = { 2 } B=\{2\} B = { 2 }
6-E02
不能。还需要 P ( A ∩ B ) \mathbb{P}(A\cap B) P ( A ∩ B ) P ( A ∩ B ) / 0.5 \mathbb{P}(A\cap B)/0.5 P ( A ∩ B ) /0.5 max ( 0 , 0.2 + 0.5 − 1 ) = 0 \max(0,0.2+0.5-1)=0 max ( 0 , 0.2 + 0.5 − 1 ) = 0 min ( 0.2 , 0.5 ) = 0.2 \min(0.2,0.5)=0.2 min ( 0.2 , 0.5 ) = 0.2
6-E03
不能。对连续型变量,指定单点概率为 0。PDF 单位为变量单位的倒数,单点密度高度不是无量纲概率。对小区间 [ a , b ] [a,b] [ a , b ] ∫ a b f X ( x ) d x = F X ( b ) − F X ( a ) \int_a^b f_X(x)\,dx=F_X(b)-F_X(a) ∫ a b f X ( x ) d x = F X ( b ) − F X ( a ) f X ( x ) ( b − a ) f_X(x)(b-a) f X ( x ) ( b − a )
6-E04
LLN 说明样本均值在条件下趋于总体均值;CLT 说明中心化、按标准误缩放后的样本均值渐近趋于正态。经典 i.i.d. CLT 要求同分布独立、有限且正的方差。t 分布 ν = 1 \nu=1 ν = 1
6-E05
P ( + ) = 0.02 ( 0.80 ) + 0.98 ( 0.10 ) = 0.016 + 0.098 = 0.114.
\mathbb{P}(+)=0.02(0.80)+0.98(0.10)=0.016+0.098=0.114.
P ( + ) = 0.02 ( 0.80 ) + 0.98 ( 0.10 ) = 0.016 + 0.098 = 0.114. P ( E ∣ + ) = 0.016 / 0.114 = 0.1403508772 ≈ 14.0351 % .
\mathbb{P}(E\mid+)=0.016/0.114=0.1403508772\approx14.0351\%.
P ( E ∣ + ) = 0.016/0.114 = 0.1403508772 ≈ 14.0351%. 分子是事件且阳性的联合概率,分母包含真阳性和假阳性。
6-E06
单次均值为 p = 0.25 p=0.25 p = 0.25 p ( 1 − p ) = 0.1875 p(1-p)=0.1875 p ( 1 − p ) = 0.1875 16 p = 4 16p=4 16 p = 4 16 p ( 1 − p ) = 3 16p(1-p)=3 16 p ( 1 − p ) = 3
6-E07
两小时参数为 λ = 1.2 × 2 = 2.4 \lambda=1.2\times2=2.4 λ = 1.2 × 2 = 2.4 N ( 2 ) ∼ Poisson ( 2.4 ) N(2)\sim\operatorname{Poisson}(2.4) N ( 2 ) ∼ Poisson ( 2.4 ) e − 2.4 ≈ 0.090718 e^{-2.4}\approx0.090718 e − 2.4 ≈ 0.090718
6-P01 参考实现
import math
prior = 0.005
sensitivity = 0.95
false_positive_rate = 0.05
joint_positive_event = prior * sensitivity
positive_rate = joint_positive_event + (1 - prior) * false_positive_rate
posterior = joint_positive_event / positive_rate
assert math.isclose(positive_rate, 0.0545 , rel_tol=0.0 , abs_tol=1e-12 )
assert math.isclose(posterior, 0.0871559633027523 , rel_tol=0.0 , abs_tol=1e-12 )
print (f"positive_rate={positive_rate:.4 f} ; posterior={posterior:.8 %} " )
预期输出:positive_rate=0.0545; posterior=8.71559633%。断言同时检验全概率分母和条件方向。
6-P02 参考实现
import numpy as np
p = 0.30
rng_lln = np.random.default_rng(6202 )
draws = rng_lln.binomial(1 , p, size=100_000 )
prefix_means = [float (draws[:n].mean()) for n in (100 , 1_000 , 100_000 )]
rng_clt = np.random.default_rng(6203 )
sample_size = 100
replications = 20_000
successes = rng_clt.binomial(1 , p, size=(replications, sample_size)).sum (axis=1 )
z = (successes - sample_size * p) / np.sqrt(sample_size * p * (1 - p))
z_mean = float (z.mean())
z_variance = float (z.var(ddof=1 ))
assert len (prefix_means) == 3
assert abs (prefix_means[-1 ] - p) < 0.01
assert abs (z_mean) < 0.04
assert abs (z_variance - 1.0 ) < 0.06
print ("prefix means:" , [round (value, 4 ) for value in prefix_means])
print (f"standardized mean={z_mean:.4 f} ; variance={z_variance:.4 f} " )
该代码只从已指定的 Bernoulli 模型生成构造样本。它验证实现与理论参数相符,不检查任何真实收益是否 i.i.d.
6-P03 参考实现
import numpy as np
rng = np.random.default_rng(6204 )
walk_steps = 300
walk_increments = 2 * rng.integers(0 , 2 , size=walk_steps) - 1
walk = np.concatenate(([0 ], np.cumsum(walk_increments)))
rng_count = rng
rate = 0.7
horizon = 10.0
n_intervals = 200
dt = horizon / n_intervals
increments = rng_count.poisson(lam=rate * dt, size=n_intervals)
counts = np.concatenate(([0 ], np.cumsum(increments)))
assert walk.shape == (301 ,)
assert set (np.unique(np.diff(walk))) <= {-1 , 1 }
assert counts.shape == (201 ,)
assert counts[0 ] == 0
assert np.all (np.diff(counts) >= 0 )
print (f"walk points={walk.size} ; terminal position={walk[-1 ]} " )
print (f"count points={counts.size} ; terminal count={counts[-1 ]} " )
两条路径由一个局部 Generator 连续抽样生成,种子固定为 6204。Poisson 近似在 T / n intervals T/n_{\text{intervals}} T / n intervals
6-C01 参考推导
平稳序列的样本均值方差为
Var ( X ˉ n ) = 1 n [ 1 + 2 ∑ k = 1 n − 1 ( 1 − k n ) ρ k ]
\operatorname{Var}(\bar X_n)=\frac{1}{n}
\left[1+2\sum_{k=1}^{n-1}\left(1-\frac{k}{n}\right)\rho_k\right]
Var ( X ˉ n ) = n 1 [ 1 + 2 k = 1 ∑ n − 1 ( 1 − n k ) ρ k ] (边际方差为 1)。取 n = 4 , ρ k = 0.5 k n=4,\rho_k=0.5^k n = 4 , ρ k = 0. 5 k
Var ( X ˉ 4 ) = 1 4 [ 1 + 2 ( 3 4 ⋅ 1 2 + 1 2 ⋅ 1 4 + 1 4 ⋅ 1 8 ) ] = 33 64 = 0.515625.
\operatorname{Var}(\bar X_4)
=\frac14\left[1+2\left(\frac34\cdot\frac12+
\frac12\cdot\frac14+\frac14\cdot\frac18\right)\right]
=\frac{33}{64}=0.515625.
Var ( X ˉ 4 ) = 4 1 [ 1 + 2 ( 4 3 ⋅ 2 1 + 2 1 ⋅ 4 1 + 4 1 ⋅ 8 1 ) ] = 64 33 = 0.515625. iid 时方差为 1 / 4 = 0.25 1/4=0.25 1/4 = 0.25 n n n
6-C02 一种可接受的参考论证
设 S t ∈ { 0 , 1 } S_t\in\{0,1\} S t ∈ { 0 , 1 } P P P [ t , t + Δ ) [t,t+\Delta) [ t , t + Δ ) S t = s S_t=s S t = s
N t + Δ − N t ∣ S t = s ∼ Poisson ( ρ s Δ ) .
N_{t+\Delta}-N_t\mid S_t=s\sim\operatorname{Poisson}(\rho_s\Delta).
N t + Δ − N t ∣ S t = s ∼ Poisson ( ρ s Δ ) . ρ s \rho_s ρ s Δ \Delta Δ
X t + Δ − X t ∣ S t = s ∼ N ( μ s Δ , σ s 2 Δ ) .
X_{t+\Delta}-X_t\mid S_t=s\sim N(\mu_s\Delta,\sigma_s^2\Delta).
X t + Δ − X t ∣ S t = s ∼ N ( μ s Δ , σ s 2 Δ ) . 其中 μ s \mu_s μ s σ s \sigma_s σ s
若允许状态在窗口内部连续切换,上面仅以起始状态条件化的两式通常不再成立。给定外生的完整状态路径,Poisson 参数改为 ∫ t t + Δ ρ S u d u \int_t^{t+\Delta}\rho_{S_u}\,du ∫ t t + Δ ρ S u d u
可能失效的因素包括状态转移随宏观环境变化、状态标签不可实时观测、事件强度成簇、收益跳跃、波动率聚集、厚尾和状态切换造成的参数漂移。样本外检验应按时间切分,先锁定状态与强度估计,再比较 Poisson 计数分布的校准/离差、计数残差相关性、连续收益的标准化残差和尾部分位;与恒定基线、独立 Bernoulli/Poisson 基准比较。若留出期计数显著过度离散或残差仍成簇,便反驳简单的条件 Poisson 设定;若标准化增量呈明显厚尾或非连续跳跃特征,则削弱 Brownian 条件收益设定。任何数据检验都须保存实时可用信息和数据版本,不能用未来状态或修订值回填信号。
6-C02 评分核对
满分 8 分。状态变量、可观测时点和转移机制清楚得 2 分;状态条件强度、计数增量假设及单位清楚得 2 分;说明 Brownian 连续路径、独立正态增量和方差随时间增长的限制得 2 分;列出至少两个可能失效因素,并给出有反证力的留出期诊断得 2 分。若把“真实市场必然 Markov/Poisson/Brownian”当结论,不给对应假设分。
6-N01
样本空间为 Ω = { 00 , 01 , 10 , 11 } \Omega=\{00,01,10,11\} Ω = { 00 , 01 , 10 , 11 } 0.49 , 0.21 , 0.21 , 0.09 0.49,0.21,0.21,0.09 0.49 , 0.21 , 0.21 , 0.09 A = { 11 } A=\{11\} A = { 11 } B = { 01 , 10 , 11 } B=\{01,10,11\} B = { 01 , 10 , 11 } X X X X ( 00 ) = 0 X(00)=0 X ( 00 ) = 0 X ( 01 ) = X ( 10 ) = 1 X(01)=X(10)=1 X ( 01 ) = X ( 10 ) = 1 X ( 11 ) = 2 X(11)=2 X ( 11 ) = 2 { 0 , 1 , 2 } \{0,1,2\} { 0 , 1 , 2 } 0.49 , 0.42 , 0.09 0.49,0.42,0.09 0.49 , 0.42 , 0.09
6-N02
条件 B B B 0.21 + 0.21 + 0.09 = 0.51 0.21+0.21+0.09=0.51 0.21 + 0.21 + 0.09 = 0.51 A A A P ( A ∣ B ) = 0.09 / 0.51 = 3 / 17 ≈ 0.17647059 \mathbb P(A\mid B)=0.09/0.51=3/17\approx0.17647059 P ( A ∣ B ) = 0.09/0.51 = 3/17 ≈ 0.17647059
6-N03
先把结果行按 X X X P ( X = 0 ) = 0.49 \mathbb P(X=0)=0.49 P ( X = 0 ) = 0.49 P ( X = 1 ) = 0.21 + 0.21 = 0.42 \mathbb P(X=1)=0.21+0.21=0.42 P ( X = 1 ) = 0.21 + 0.21 = 0.42 P ( X = 2 ) = 0.09 \mathbb P(X=2)=0.09 P ( X = 2 ) = 0.09
E [ X ] = 0 ( 0.49 ) + 1 ( 0.42 ) + 2 ( 0.09 ) = 0.60 ,
\mathbb E[X]=0(0.49)+1(0.42)+2(0.09)=0.60,
E [ X ] = 0 ( 0.49 ) + 1 ( 0.42 ) + 2 ( 0.09 ) = 0.60 , E [ X 2 ] = 0 2 ( 0.49 ) + 1 2 ( 0.42 ) + 2 2 ( 0.09 ) = 0.78 , Var ( X ) = 0.78 − ( 0.60 ) 2 = 0.42.
\mathbb E[X^2]=0^2(0.49)+1^2(0.42)+2^2(0.09)=0.78,
\qquad \operatorname{Var}(X)=0.78-(0.60)^2=0.42.
E [ X 2 ] = 0 2 ( 0.49 ) + 1 2 ( 0.42 ) + 2 2 ( 0.09 ) = 0.78 , Var ( X ) = 0.78 − ( 0.60 ) 2 = 0.42. 每次 Bernoulli 的方差是 0.3 ( 0.7 ) = 0.21 0.3(0.7)=0.21 0.3 ( 0.7 ) = 0.21 0.21 + 0.21 = 0.42 0.21+0.21=0.42 0.21 + 0.21 = 0.42
6-N04
保持原分子 X ˉ − p \bar X-p X ˉ − p p ( 1 − p ) / n \sqrt{p(1-p)/n} p ( 1 − p ) / n n ( X ˉ − p ) \sqrt n(\bar X-p) n ( X ˉ − p ) p ( 1 − p ) \sqrt{p(1-p)} p ( 1 − p ) 1 / n 1/\sqrt n 1/ n
Var ( z ) = Var ( X ˉ ) p ( 1 − p ) = p ( 1 − p ) / n p ( 1 − p ) = 1 n ,
\operatorname{Var}(z)=\frac{\operatorname{Var}(\bar X)}{p(1-p)}
=\frac{p(1-p)/n}{p(1-p)}=\frac1n,
Var ( z ) = p ( 1 − p ) Var ( X ˉ ) = p ( 1 − p ) p ( 1 − p ) / n = n 1 , 而不是 1。增加独立重复份数可更清楚地描绘指定 Bernoulli 模型下统计量的分布,并检查模拟实现;它不能证明 CLT 的渐近结论,也不能证明真实收益独立同分布。
6-N05
三个判断都超出了证据。一次模拟只展示指定生成机制的一次构造;即使模拟重复很多次,也只检查该模型下的抽样分布,不验证真实收益。自相关检验未拒绝零相关表示样本证据不足以拒绝该检验的原假设,不证明总体协方差为零,更不证明独立或正态。预测条件概率需要先定义亏损事件、收益窗口、信号信息时点和样本外评估;因果结论还需要明确干预对象,并用随机化或可辩护的混杂控制识别反事实;经典 i.i.d. 均值 CLT 区间要求独立同分布、有限且正的总体方差,并且统计量是按每份样本量 n n n
6-B01
共同 A A A E [ A 2 ] = 2.5 \mathbb E[A^2]=2.5 E [ A 2 ] = 2.5 Var ( X ˉ n ) = 2.5 / n \operatorname{Var}(\bar X_n)=2.5/n Var ( X ˉ n ) = 2.5/ n E [ A 4 ] = 8.5 \mathbb E[A^4]=8.5 E [ A 4 ] = 8.5 8.5 − 2.5 2 = 2.25 8.5-2.5^2=2.25 8.5 − 2. 5 2 = 2.25 Z n Z_n Z n 3 ( 0.4 2 + 1.6 2 ) / 2 = 4.08 3(0.4^2+1.6^2)/2=4.08 3 ( 0. 4 2 + 1. 6 2 ) /2 = 4.08 n n n n n n
19. Further Reading
Must Know :MIT 6.041SC Lecture 1–2,读样本空间、公理、条件概率、全概率和 Bayes;Lecture 5–6 读随机变量、期望、方差与条件期望;Lecture 8 读连续变量、PDF/CDF;Lecture 12 读迭代期望和全方差。对应官方链接见第 20 节。Should Know :MIT 6.262 Lecture 3–4 与 Chapter 2 §2.1,用于补充收敛、Poisson 到达过程和计数增量;MIT 6.041SC Lecture 17 作为有限状态 Markov 链入口。Advanced :MIT 15.070J Lecture 6 Brownian 讲义,重点读随机游走启发式构造和过程定义。讲义明确该启发式构造不是证明;严格极限与随机积分需继续学习,本课程把 Itô 展开安排在第 44 章。API 使用 :NumPy Generator 与 binomial、normal、poisson 文档用于核查生成器和函数参数;SciPy 的 binom、norm、lognorm、poisson、t 文档用于核对 API 参数化。文档是软件接口说明,不是市场数据证据。
20. References
来源均为官方课程或官方软件文档;具体阅读范围、检索方式和不能支持的结论见本章 source_notes.md 。本章没有真实市场实证来源。
MIT_6041SC — MIT OpenCourseWare, 6.041SC Probabilistic Systems Analysis and Applied Probability, Fall 2013 。Lecture 1–2、5–6、8、10、12、17 的链接和阅读范围见 source notes。MIT_6262 — MIT OpenCourseWare, 6.262 Discrete Stochastic Processes, Spring 2011 。本章所读 Lecture 3、Lecture 4 与 Poisson Processes Chapter 2 §2.1 直链见 source notes。MIT_BROWNIAN — MIT OpenCourseWare, 15.070J Advanced Stochastic Processes, Fall 2013, Lecture 6 。Brownian 定义及随机游走启发式构造;不是本章市场拟合来源。NUMPY_RANDOM — NumPy, Random Generator reference , Generator.binomial , Generator.normal , Generator.poisson 。SCIPY_STATS — SciPy, binom , norm , lognorm , poisson , t distribution references。
补充官方API:SciPy expon 、SciPy uniform 。根代理实际读取参数化及分布定义,计数到等待时间和零相关反例为原创推导。