第 23 章/ 45
截面研究(Cross-Sectional Research)
主线:同一个时点上把许多资产按信号排序,用排序与下一期收益的关系衡量“预测”,再用分位组合回答“持有”;两者回答的是不同的问题。
先修:第8章(回归)、第15章(因子模型与 HAC)、第22章(研究方法论)。完成后你能:在存在并列与缺失的截面上计算名次、百分位与分位桶;区分皮尔逊 IC 与 Rank IC;推出为什么跨日混合相关不等于逐日 IC;构造分位多空组合并计算换手;推出重叠标签下 IC 序列的有效样本数;用 Fama–MacBeth 两步法得到每单位信号的平均收益。
1. 本章目标
读者应能做到:
对一个有并列(ties)和缺失(NaN)的单日截面,手算名次(rank)、百分位(percentile)和 q q q
计算每个日期的信息系数(Information Coefficient, IC)与秩信息系数(Rank IC),按时间聚合,用 Newey–West 修正推断;知道总样本相关为什么不能代替逐日 IC。
区分三个时间对象:signal_time(信号形成时点)、trade_time(成交时点)、标签区间(label interval,信号之后才发生的收益测量区间);用 lead_return 与 forward_label 构造标签,使标签区间不与信号窗口重叠。
构造分位组合、十分位组合与多空组合,写出三种加权方案(等权、市值加权、信号比例加权),并推出信号比例加权的组合收益等于 I C × σ r \mathrm{IC}\times\sigma_r IC × σ r
计算 IC 衰减(IC decay)与换手,说明给定构造模型中信号持续性如何联系预测持续期,并与权重/成本一起影响交易频率。
说出重叠标签在什么条件下使朴素 t t t
完成标准:给定一张日期×资产的信号表和收益表,能写出研究表的每一列,指出每一列在哪个时点可得,并复算本章第8节的所有数字。
2. 为什么 Quant 需要它
第22章规定了怎样诚实地记录试验。本章给出每一次试验里最常用的度量方式。多因子策略的数据结构几乎总是“很多资产、很多日期”的面板:同一个月末,有数百个资产各自带一个信号值,下个月各自有一个收益。你要回答两个问题:信号高的资产下个月收益是否更高(预测),以及按信号排序持有能赚多少、换手多快(持有)。
两个问题需要不同的工具。预测问题只关心每个日期内资产之间的相对次序,因此应先在日期内部排序,再跨日期汇总;若把所有日期的所有资产直接放进一个相关系数里,市场整体涨跌、信号水平随时间的漂移都会混入,产生与排序能力无关的数字。持有问题需要把排序变成权重、考虑权重在相邻日期的变动(换手)与成本。
本章的逻辑链是:先规定日内排序与并列规则;再用逐日 IC 度量预测,用时间序列汇总推断,并处理重叠标签造成的相关;再把排序变成分位组合,推出 IC 与组合收益的联系;再看给定模型下信号持续性如何联系 IC 衰减,以及权重如何影响换手;最后用 Fama–MacBeth 回归把“每单位信号的平均收益”写成一个带标准误的数。第24–28章的每个因子都会走这条链。
3. 直觉
想象一所学校每个月举行一次考试,每次的科目和难度不同。你想知道“一年级的预习得分”是否预测期末成绩。如果把所有月份的所有学生混在一起算一个相关系数,那些考得简单的月份(所有人分数都高)会和预习分数同样高的月份(比如预习题恰好也简单)重合,造成与学生个体能力无关的相关。正确做法是先在每次考试内部排名,用“这次考试里预习排名靠前的人,期末是否也靠前”做衡量,再把许多次的结论平均起来。这就是逐日 IC。
分位组合对应另一件事:你不需要预测每个学生的具体分数,只需要选出预习排名前 20% 的学生,看他们与后 20% 相比,平均期末成绩高多少。这个高出的部分就是多空收益。它依赖你怎样分组、怎样对组内学生加权,也依赖你每月换多少人。
简化的边界:考试之间的科目不同;金融中共同市场冲击会使同一月份的资产收益横截面相关。跨月份的时间依赖则是另一件事,须另查收益动态、信号持续性与标签重叠等,不能由同月共同冲击直接推出;学生一年后还是同一批人,而资产之间的信号排序会逐月变化,在后文的稳定线性构造中,变化快慢与 IC 持续期相联系。这些在后面各节分别量化。
3.1 先走完一张资产×日期小表
下面是教学构造,收益标签在信号日不可得。信号缺失的资产不进入当日排序;标签缺失的资产仍可有信号百分位,但不能进入该日 IC。A–E 是固定资产标识。
日期
对象
A
B
C
D
E
1月
截止时点可得信号
1
2
3
4
缺失
1月
事后下月收益标签
0.01
缺失
0.03
0.02
0.04
2月
截止时点可得信号
1
1
1
1
缺失
2月
事后下月收益标签
0.01
0.02
0.03
0.04
缺失
3月
截止时点可得信号
4
3
2
1
缺失
3月
事后下月收益标签
0.01
0.02
0.03
0.04
缺失
1月有效信号数 N s i g n a l , t = 4 N_{\mathrm{signal},t}=4 N signal , t = 4 ( 1 , 2 , 3 , 4 ) (1,2,3,4) ( 1 , 2 , 3 , 4 ) ( 0 , 1 / 3 , 2 / 3 , 1 ) (0,1/3,2/3,1) ( 0 , 1/3 , 2/3 , 1 ) q = 2 q=2 q = 2 ⌊ 2 ( r − 0.5 ) / 4 ⌋ + 1 \lfloor2(r-0.5)/4\rfloor+1 ⌊ 2 ( r − 0.5 ) /4 ⌋ + 1 ( 1 , 1 , 2 , 2 ) (1,1,2,2) ( 1 , 1 , 2 , 2 ) ( 1 , 2.5 , 2.5 , 4 ) (1,2.5,2.5,4) ( 1 , 2.5 , 2.5 , 4 ) ( 0 , 0.5 , 0.5 , 1 ) (0,0.5,0.5,1) ( 0 , 0.5 , 0.5 , 1 ) ( 1 , 2 , 2 , 2 ) (1,2,2,2) ( 1 , 2 , 2 , 2 ) n p a i r , t = 3 n_{\mathrm{pair},t}=3 n pair , t = 3 ( 1 , 2 , 3 ) (1,2,3) ( 1 , 2 , 3 ) ( 1 , 3 , 2 ) (1,3,2) ( 1 , 3 , 2 ) = 1 / 2 × 2 = 0.5 =1/\sqrt{2\times2}=0.5 = 1/ 2 × 2 = 0.5
若先对四名排名,再删 B,信号名次会误用 ( 1 , 3 , 4 ) (1,3,4) ( 1 , 3 , 4 )
2月有四个配对,但信号常数,IC 为缺失;3月四个配对,Rank IC = − 1 =-1 = − 1 ( 3 , 4 , 4 ) (3,4,4) ( 3 , 4 , 4 ) T v a l i d = 2 T_{\mathrm{valid}}=2 T valid = 2 ( 0.5 − 1 ) / 2 = − 0.25 (0.5-1)/2=-0.25 ( 0.5 − 1 ) /2 = − 0.25 − 1 / 6 -1/6 − 1/6
4. 数学基础
记号。 日期 t = 1 , … , T t=1,\dots,T t = 1 , … , T i = 1 , … , N t i=1,\dots,N_t i = 1 , … , N t N t = N s i g n a l , t N_t=N_{\mathrm{signal},t} N t = N signal , t t t t n p a i r , t n_{\mathrm{pair},t} n pair , t T v a l i d T_{\mathrm{valid}} T valid n n n N N N T T T s i , t s_{i,t} s i , t signal_time t t t y i , t y_{i,t} y i , t y i , t = R i , t + 1 y_{i,t}=R_{i,t+1} y i , t = R i , t + 1 h h h y i , t = ∏ k = 1 h ( 1 + R i , t + k ) − 1 y_{i,t}=\prod_{k=1}^{h}(1+R_{i,t+k})-1 y i , t = ∏ k = 1 h ( 1 + R i , t + k ) − 1 t t t i i i
日内统计量。 以下 IC 统计量先在配对集合上计算,式中的 N t N_t N t n p a i r , t n_{\mathrm{pair},t} n pair , t s ˉ t = 1 N t ∑ i s i , t \bar s_t=\frac1{N_t}\sum_is_{i,t} s ˉ t = N t 1 ∑ i s i , t σ s , t 2 = 1 N t ∑ i ( s i , t − s ˉ t ) 2 \sigma_{s,t}^2=\frac1{N_t}\sum_i(s_{i,t}-\bar s_t)^2 σ s , t 2 = N t 1 ∑ i ( s i , t − s ˉ t ) 2 N t N_t N t C o v t ( s , y ) = 1 N t ∑ i ( s i , t − s ˉ t ) ( y i , t − y ˉ t ) \mathrm{Cov}_t(s,y)=\frac1{N_t}\sum_i(s_{i,t}-\bar s_t)(y_{i,t}-\bar y_t) Cov t ( s , y ) = N t 1 ∑ i ( s i , t − s ˉ t ) ( y i , t − y ˉ t ) I C t = C o v t ( s , y ) / ( σ s , t σ y , t ) \mathrm{IC}_t=\mathrm{Cov}_t(s,y)/(\sigma_{s,t}\sigma_{y,t}) IC t = Cov t ( s , y ) / ( σ s , t σ y , t )
总协方差定律。 把 T T T ( i , t ) (i,t) ( i , t ) N N N N T NT N T
Newey–West。 第22章第4节已给公式;本章用来汇总 T T T L = 0 L=0 L = 0 T T T
一阶自回归信号(autoregression of order 1, AR(1))。 若 z i , t = ρ z i , t − 1 + 1 − ρ 2 ϵ i , t z_{i,t}=\rho z_{i,t-1}+\sqrt{1-\rho^2}\,\epsilon_{i,t} z i , t = ρ z i , t − 1 + 1 − ρ 2 ϵ i , t ∣ ρ ∣ < 1 |\rho|<1 ∣ ρ ∣ < 1 ϵ \epsilon ϵ V a r ( z ) = 1 \mathrm{Var}(z)=1 Var ( z ) = 1 C o r r ( z i , t , z i , t + j ) = ρ j \mathrm{Corr}(z_{i,t},z_{i,t+j})=\rho^{j} Corr ( z i , t , z i , t + j ) = ρ j
条件期望(二元正态)。 若 ( Z , r ) (Z,\,r) ( Z , r ) Z ∼ N ( 0 , 1 ) Z\sim N(0,1) Z ∼ N ( 0 , 1 ) r r r μ r \mu_r μ r σ r \sigma_r σ r Z Z Z ρ I C \rho_{\mathrm{IC}} ρ IC E [ r ∣ Z ] = μ r + ρ I C σ r Z \mathbb E[r\mid Z]=\mu_r+\rho_{\mathrm{IC}}\sigma_rZ E [ r ∣ Z ] = μ r + ρ IC σ r Z Z Z Z E [ Z ∣ Z > c ] = φ ( c ) / ( 1 − Φ ( c ) ) \mathbb E[Z\mid Z>c]=\varphi(c)/(1-\Phi(c)) E [ Z ∣ Z > c ] = φ ( c ) / ( 1 − Φ ( c )) φ \varphi φ
频率约定:本章用月频;signal_time 是月末;标签从下一个月开始。
5. 正式定义
截面(cross-section)与面板(panel)。 截面是固定日期 t t t signal_time。缺失只用 NaN 标记;无穷、复数、布尔、文本和 None 一律报错,因为它们要么没有数值意义,要么会被静默当作 0 或 1。
名次(rank)与并列(ties)。 对日期 t t t k k k k k k m m m k , … , k + m − 1 k,\dots,k+m-1 k , … , k + m − 1 k + ( m − 1 ) / 2 k+(m-1)/2 k + ( m − 1 ) /2 r a n k i = # { j : s j < s i } + ( # { j : s j = s i } + 1 ) / 2 \mathrm{rank}_i=\#\{j:s_j<s_i\}+\bigl(\#\{j:s_j=s_i\}+1\bigr)/2 rank i = # { j : s j < s i } + ( # { j : s j = s i } + 1 ) /2
百分位(percentile)。 有效项个数 n ≥ 2 n\ge2 n ≥ 2 u i = ( r a n k i − 1 ) / ( n − 1 ) ∈ [ 0 , 1 ] u_i=(\mathrm{rank}_i-1)/(n-1)\in[0,1] u i = ( rank i − 1 ) / ( n − 1 ) ∈ [ 0 , 1 ] n = 1 n=1 n = 1 N t N_t N t
q q q u ~ i = ( r a n k i − 1 2 ) / n ∈ ( 0 , 1 ) \tilde u_i=(\mathrm{rank}_i-\tfrac12)/n\in(0,1) u ~ i = ( rank i − 2 1 ) / n ∈ ( 0 , 1 ) g i = ⌊ q u ~ i ⌋ + 1 ∈ { 1 , … , q } g_i=\lfloor q\,\tilde u_i\rfloor+1\in\{1,\dots,q\} g i = ⌊ q u ~ i ⌋ + 1 ∈ { 1 , … , q } q q q q q q q = 5 q=5 q = 5 q = 10 q=10 q = 10
信息系数与秩信息系数。 I C t \mathrm{IC}_t IC t { s i , t } i \{s_{i,t}\}_i { s i , t } i { y i , t } i \{y_{i,t}\}_i { y i , t } i t t t ± 1 \pm1 ± 1
IC 序列、ICIR、命中率。 { I C t } t = 1 T \{\mathrm{IC}_t\}_{t=1}^T { IC t } t = 1 T I C ‾ \overline{\mathrm{IC}} IC s I C s_{\mathrm{IC}} s IC = I C ‾ / s I C =\overline{\mathrm{IC}}/s_{\mathrm{IC}} = IC / s IC I C t > 0 \mathrm{IC}_t>0 IC t > 0 t t t t = I C I R ⋅ T t=\mathrm{ICIR}\cdot\sqrt T t = ICIR ⋅ T
IC 衰减(IC decay)与信号衰减(signal decay)。 固定信号 s i , t s_{i,t} s i , t k = 1 , 2 , … k=1,2,\dots k = 1 , 2 , … k k k R i , t + k R_{i,t+k} R i , t + k k k k
分位组合、十分位组合与多空组合。 日期 t t t q q q signal_time 已知的市值),信号比例加权(权重正比于去均值后的信号)。多空组合(long-short portfolio)买第 q q q
换手(turnover)。 本章用两个口径。目标权重换手 ∑ i ∣ w i , t − w i , t − 1 ∣ \sum_i|w_{i,t}-w_{i,t-1}| ∑ i ∣ w i , t − w i , t − 1 ∣
重叠标签与有效样本数。 当标签跨 h > 1 h>1 h > 1 n e f f = T / V I F n_{\mathrm{eff}}=T/\mathrm{VIF} n eff = T / VIF T T T T T T
Fama–MacBeth 两步法。 第一步,每个日期 t t t y i , t = a t + b t x i , t + e i , t y_{i,t}=a_t+b_t\,x_{i,t}+e_{i,t} y i , t = a t + b t x i , t + e i , t b t b_t b t x x x b t b_t b t
面板相依(panel dependence)。 同一日期内资产的收益因共同冲击而相关(时间效应);同一资产在不同日期的残差因持续特征而相关(资产/公司效应)。Fama–MacBeth 对前者有效,对后者给出偏小的标准误(Petersen 2005);Newey–West 对时间序列相关做修正,但不处理截面相关的结构。
5.1 三个计数与两个除数约定
排序百分位与分桶先用 N s i g n a l , t N_{\mathrm{signal},t} N signal , t n p a i r , t n_{\mathrm{pair},t} n pair , t T v a l i d T_{\mathrm{valid}} T valid
在某一日期固定 n = n p a i r , t ≥ 3 n=n_{\mathrm{pair},t}\ge3 n = n pair , t ≥ 3 C C C S s , S y > 0 S_s,S_y>0 S s , S y > 0 n − d n-d n − d d = 0 d=0 d = 0
I C t = C / ( n − d ) S s / ( n − d ) S y / ( n − d ) = C S s S y .
\mathrm{IC}_t=\frac{C/(n-d)}{\sqrt{S_s/(n-d)}\sqrt{S_y/(n-d)}}
=\frac{C}{\sqrt{S_sS_y}}.
IC t = S s / ( n − d ) S y / ( n − d ) C / ( n − d ) = S s S y C . 等号因为分子和分母有相同正因子,相关无量纲;这是协方差与标准差一致取除数时的相消,不表示任意混用除数都没影响。1月名次给 C = 1 , S s = S y = 2 C=1,S_s=S_y=2 C = 1 , S s = S y = 2 C o v = 1 / 3 , σ = 2 / 3 \mathrm{Cov}=1/3,\sigma=\sqrt{2/3} Cov = 1/3 , σ = 2/3 C o v = 1 / 2 , σ = 1 \mathrm{Cov}=1/2,\sigma=1 Cov = 1/2 , σ = 1
时间标准差 s I C s_{\mathrm{IC}} s IC ( T v a l i d − 1 ) (T_{\mathrm{valid}}-1) ( T valid − 1 ) s I C / T v a l i d s_{\mathrm{IC}}/\sqrt{T_{\mathrm{valid}}} s IC / T valid + 0.75 , − 0.75 +0.75,-0.75 + 0.75 , − 0.75 s = 1.125 = 1.06066 s=\sqrt{1.125}=1.06066 s = 1.125 = 1.06066 t = − 1 / 3 t=-1/3 t = − 1/3
HAC(异方差与自相关稳健,heteroskedasticity and autocorrelation consistent)中的样本自协方差按现有实现统一除以 T v a l i d T_{\mathrm{valid}} T valid L = 0 L=0 L = 0 V a r ^ N W ( I C ˉ ) = ( T v a l i d − 1 ) s 2 / T v a l i d 2 \widehat{\mathrm{Var}}_{\mathrm{NW}}(\bar{\mathrm{IC}})=(T_{\mathrm{valid}}-1)s^2/T_{\mathrm{valid}}^2 Var NW ( IC ˉ ) = ( T valid − 1 ) s 2 / T valid 2 s 2 / T v a l i d s^2/T_{\mathrm{valid}} s 2 / T valid
缺月接口。 ic_series 先取两输入的日期/资产交集,交集之外的缺日不在其返回的缺失计数里,须另查原始日历。ic_summary 先计数并剔除 NaN,再把压缩后的有效 IC 数组传给 newey_west_variance_of_mean;后者直接调用时要求完整的有限数值数组,遇到 NaN 明确抛出 ValueError,不负责剔除缺失。NW 滞后按传入数组的位置计算;3.1节1月与3月因此成为相邻有效项,L = 1 L=1 L = 1
5.2 财报、信号与成交的五个时钟
以下日期沿用 Project4 构造 P102/FY2013 的事件记录,不是新搜集的真实 PIT 数据。
时钟
当前字段与记录
可做什么
报告期间
period_end:2013-12-31标明财年,不证明已公开
公开与入库
available_at:2014-04-17 16:05 UTC;ingested_at:2014-04-18两者均在截止前才可用同一版本
信号截止
2014-04 月末;程序比较截止为2014-05-01 00:00 UTC
取两字段严格小于截止的最新期间/版本
首个实际可交易时点
2014-05 中有实际可交易价格的首个时点
比信号晚;仅有月表不能补造具体成交价
标签区间
当前代理:4月末收盘至5月末收盘;执行标签:实际成交价至退出价
代理含真实成交前的一段收益,两者不等同
原10-K版本4月可用;5月20日公开、21日入库的重述只在5月信号起可用。截止比较使用下一月首时刻的严格不等号,不是把未知精度硬改成“月末23:59:59以前”。月收盘标签回答虚拟月末成交的研究问题;真实组合收益要从实际成交价格起算,并连接现金/持仓与公司行动账本。lag 的整月位移不能代替交易日历。
6. 推导
6.1 分位桶的尺寸与并列
没有并列时,名次取遍 1 , … , n 1,\dots,n 1 , … , n u ~ = ( r − 1 2 ) / n \tilde u=(r-\tfrac12)/n u ~ = ( r − 2 1 ) / n ( 0 , 1 ) (0,1) ( 0 , 1 ) 1 / n 1/n 1/ n 1 2 n , 3 2 n , … \tfrac1{2n},\tfrac3{2n},\dots 2 n 1 , 2 n 3 , … g g g ( g − 1 ) / q ≤ u ~ < g / q (g-1)/q\le\tilde u<g/q ( g − 1 ) / q ≤ u ~ < g / q r − 1 2 ∈ [ ( g − 1 ) n / q , g n / q ) r-\tfrac12\in[(g-1)n/q,\;gn/q) r − 2 1 ∈ [( g − 1 ) n / q , g n / q ) L = n / q L=n/q L = n / q 1 2 , 3 2 , … \tfrac12,\tfrac32,\dots 2 1 , 2 3 , … ⌊ L ⌋ \lfloor L\rfloor ⌊ L ⌋ ⌈ L ⌉ \lceil L\rceil ⌈ L ⌉ n = 10 , q = 5 n=10,q=5 n = 10 , q = 5 n = 11 , q = 5 n=11,q=5 n = 11 , q = 5
6.2 Spearman 相关是名次的皮尔逊相关;无并列时的闭式
n n n r i r_i r i q i q_i q i 1 , … , n 1,\dots,n 1 , … , n r ˉ = q ˉ = n + 1 2 \bar r=\bar q=\tfrac{n+1}{2} r ˉ = q ˉ = 2 n + 1 ∑ i ( r i − r ˉ ) 2 = ∑ i ( q i − q ˉ ) 2 = n ( n 2 − 1 ) 12 \sum_i(r_i-\bar r)^2=\sum_i(q_i-\bar q)^2=\tfrac{n(n^2-1)}{12} ∑ i ( r i − r ˉ ) 2 = ∑ i ( q i − q ˉ ) 2 = 12 n ( n 2 − 1 ) d i = r i − q i d_i=r_i-q_i d i = r i − q i
∑ i d i 2 = ∑ i ( r i − r ˉ ) 2 + ∑ i ( q i − q ˉ ) 2 − 2 ∑ i ( r i − r ˉ ) ( q i − q ˉ ) , ∑ i ( r i − r ˉ ) ( q i − q ˉ ) = n ( n 2 − 1 ) 12 − 1 2 ∑ i d i 2 .
\begin{aligned}
\sum_id_i^2&=\sum_i(r_i-\bar r)^2+\sum_i(q_i-\bar q)^2\\
&\quad-2\sum_i(r_i-\bar r)(q_i-\bar q),\\
\sum_i(r_i-\bar r)(q_i-\bar q)&=\frac{n(n^2-1)}{12}-\frac12\sum_id_i^2 .
\end{aligned}
i ∑ d i 2 i ∑ ( r i − r ˉ ) ( q i − q ˉ ) = i ∑ ( r i − r ˉ ) 2 + i ∑ ( q i − q ˉ ) 2 − 2 i ∑ ( r i − r ˉ ) ( q i − q ˉ ) , = 12 n ( n 2 − 1 ) − 2 1 i ∑ d i 2 . 皮尔逊相关为协方差除以两边平方和的几何平均 n ( n 2 − 1 ) 12 \tfrac{n(n^2-1)}{12} 12 n ( n 2 − 1 )
ρ S = 1 − 6 ∑ i d i 2 n ( n 2 − 1 ) .
\rho_S=1-\frac{6\sum_id_i^2}{n(n^2-1)} .
ρ S = 1 − n ( n 2 − 1 ) 6 ∑ i d i 2 . 这个公式只在无并列时成立;有并列时用平均名次的皮尔逊相关。示例见第 8.3 节。
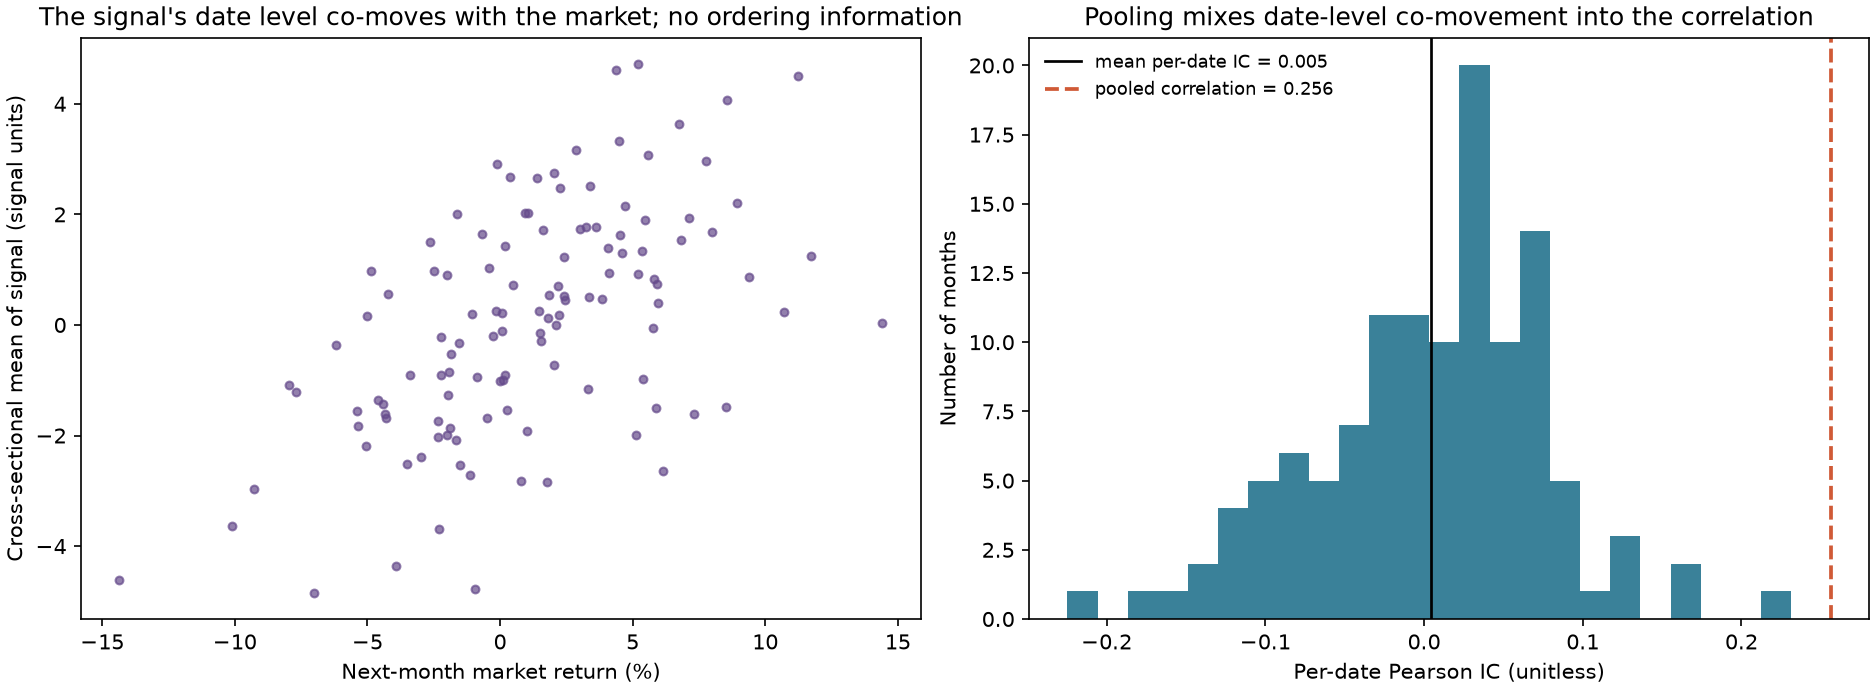
6.3 为什么混合相关不等于逐日 IC
设每个日期有同样的 N N N N T NT N T t t t s ˉ t , y ˉ t \bar s_t,\bar y_t s ˉ t , y ˉ t s ˉ ˉ , y ˉ ˉ \bar{\bar s},\bar{\bar y} s ˉ ˉ , y ˉ ˉ
C o v p o o l ( s , y ) = 1 T ∑ t C o v t ( s , y ) ⏟ 日内协方差的平均 + 1 T ∑ t ( s ˉ t − s ˉ ˉ ) ( y ˉ t − y ˉ ˉ ) ⏟ 日期均值之间的协方差 .
\mathrm{Cov}_{\mathrm{pool}}(s,y)=\underbrace{\frac1T\sum_t\mathrm{Cov}_t(s,y)}_{\text{日内协方差的平均}}
+\underbrace{\frac1T\sum_t(\bar s_t-\bar{\bar s})(\bar y_t-\bar{\bar y})}_{\text{日期均值之间的协方差}} .
Cov pool ( s , y ) = 日内协方差的平均 T 1 t ∑ Cov t ( s , y ) + 日期均值之间的协方差 T 1 t ∑ ( s ˉ t − s ˉ ˉ ) ( y ˉ t − y ˉ ˉ ) . 推导:对每个观测写 s i , t − s ˉ ˉ = ( s i , t − s ˉ t ) + ( s ˉ t − s ˉ ˉ ) s_{i,t}-\bar{\bar s}=(s_{i,t}-\bar s_t)+(\bar s_t-\bar{\bar s}) s i , t − s ˉ ˉ = ( s i , t − s ˉ t ) + ( s ˉ t − s ˉ ˉ ) y y y ∑ i ( s i , t − s ˉ t ) = 0 \sum_i(s_{i,t}-\bar s_t)=0 ∑ i ( s i , t − s ˉ t ) = 0 + 1 +1 + 1 − 1 -1 − 1
6.4 信号比例加权的组合收益等于 I C × σ r \mathrm{IC}\times\sigma_r IC × σ r
设日期 t t t z i = ( s i − s ˉ ) / σ s z_i=(s_i-\bar s)/\sigma_s z i = ( s i − s ˉ ) / σ s z ˉ = 0 \bar z=0 z ˉ = 0 1 N ∑ z i 2 = 1 \frac1N\sum z_i^2=1 N 1 ∑ z i 2 = 1 w i = z i / N w_i=z_i/N w i = z i / N
R p = ∑ i w i y i = 1 N ∑ i z i y i = 1 N ∑ i z i ( y i − y ˉ ) = C o v t ( z , y ) = I C t ⋅ σ y , t .
R_p=\sum_iw_iy_i=\frac1N\sum_iz_iy_i=\frac1N\sum_iz_i(y_i-\bar y)=\mathrm{Cov}_t(z,y)=\mathrm{IC}_t\cdot\sigma_{y,t} .
R p = i ∑ w i y i = N 1 i ∑ z i y i = N 1 i ∑ z i ( y i − y ˉ ) = Cov t ( z , y ) = IC t ⋅ σ y , t . 第二个等号用 ∑ i z i = 0 \sum_iz_i=0 ∑ i z i = 0 σ z = 1 \sigma_z=1 σ z = 1 σ y , t \sigma_{y,t} σ y , t 1 N ∑ i ∣ z i ∣ \frac1N\sum_i|z_i| N 1 ∑ i ∣ z i ∣ 2 / ( 1 N ∑ i ∣ z i ∣ ) 2\big/\bigl(\frac1N\sum_i|z_i|\bigr) 2 / ( N 1 ∑ i ∣ z i ∣ )
6.5 二元正态下分位多空的期望收益
在 4 节的二元正态假设下,E [ y ∣ z ] = μ y + I C σ y z \mathbb E[y\mid z]=\mu_y+\mathrm{IC}\,\sigma_yz E [ y ∣ z ] = μ y + IC σ y z 1 / q 1/q 1/ q z > c q z>c_q z > c q c q = Φ − 1 ( 1 − 1 / q ) c_q=\Phi^{-1}(1-1/q) c q = Φ − 1 ( 1 − 1/ q ) μ y + I C σ y E [ z ∣ z > c q ] = μ y + I C σ y ⋅ q φ ( c q ) \mu_y+\mathrm{IC}\,\sigma_y\,\mathbb E[z\mid z>c_q]=\mu_y+\mathrm{IC}\,\sigma_y\cdot q\,\varphi(c_q) μ y + IC σ y E [ z ∣ z > c q ] = μ y + IC σ y ⋅ q φ ( c q )
E [ 多空 ] = 2 I C σ y q φ ( c q ) .
\mathbb E[\text{多空}]=2\,\mathrm{IC}\,\sigma_y\,q\,\varphi(c_q) .
E [ 多空 ] = 2 IC σ y q φ ( c q ) . 数值:q = 5 q=5 q = 5 c = 0.8416 c=0.8416 c = 0.8416 φ = 0.2800 \varphi=0.2800 φ = 0.2800 q φ = 1.400 q\varphi=1.400 q φ = 1.400 q = 10 q=10 q = 10 c = 1.2816 c=1.2816 c = 1.2816 φ = 0.1755 \varphi=0.1755 φ = 0.1755 q φ = 1.755 q\varphi=1.755 q φ = 1.755 q = 3 q=3 q = 3 q φ = 1.091 q\varphi=1.091 q φ = 1.091 I C = 0.05 \mathrm{IC}=0.05 IC = 0.05 σ y = 8 % \sigma_y=8\% σ y = 8% 2 × 0.05 × 0.08 × 1.400 = 1.12 % 2\times0.05\times0.08\times1.400=1.12\% 2 × 0.05 × 0.08 × 1.400 = 1.12% 1.40 % 1.40\% 1.40%
6.6 Fama–MacBeth:每期回归、再跨期平均
日期 t t t y i , t = a t + b t z i , t + e i , t y_{i,t}=a_t+b_tz_{i,t}+e_{i,t} y i , t = a t + b t z i , t + e i , t
b ^ t = ∑ i z i , t ( y i , t − y ˉ t ) ∑ i z i , t 2 = N C o v t ( z , y ) N = I C t ⋅ σ y , t ( 当 z 在日内标准化 ) ,
\hat b_t=\frac{\sum_iz_{i,t}(y_{i,t}-\bar y_t)}{\sum_iz_{i,t}^2}=\frac{N\,\mathrm{Cov}_t(z,y)}{N}=\mathrm{IC}_t\cdot\sigma_{y,t}\quad(\text{当 }z\text{ 在日内标准化}),
b ^ t = ∑ i z i , t 2 ∑ i z i , t ( y i , t − y ˉ t ) = N N Cov t ( z , y ) = IC t ⋅ σ y , t ( 当 z 在日内标准化 ) , 与 6.4 节的组合收益相同,所以每期的 Fama–MacBeth 斜率就是信号比例加权的组合收益。第二步:b ˉ = 1 T ∑ b ^ t \bar b=\frac1T\sum\hat b_t b ˉ = T 1 ∑ b ^ t s e ( b ˉ ) = s b / T \mathrm{se}(\bar b)=s_b/\sqrt T se ( b ˉ ) = s b / T b ^ t \hat b_t b ^ t
与 IC 的差别:I C ‾ \overline{\mathrm{IC}} IC b ˉ \bar b b ˉ σ y , t \sigma_{y,t} σ y , t t t t t t t
6.7 给定构造模型下的 IC 衰减与信号持续性
构造设定:下期收益 y i , t + 1 = β z i , t + ϵ y_{i,t+1}=\beta z_{i,t}+\epsilon y i , t + 1 = β z i , t + ϵ z z z ρ \rho ρ ϵ \epsilon ϵ z i , t z_{i,t} z i , t k k k y i , t + k = β z i , t + k − 1 + ϵ y_{i,t+k}=\beta z_{i,t+k-1}+\epsilon y i , t + k = β z i , t + k − 1 + ϵ β ρ k − 1 \beta\rho^{k-1} β ρ k − 1
I C k = I C 1 ⋅ ρ k − 1 .
\mathrm{IC}_k=\mathrm{IC}_1\cdot\rho^{k-1} .
IC k = IC 1 ⋅ ρ k − 1 . 当 0 < ρ < 1 0<\rho<1 0 < ρ < 1 ln ( 0.5 ) / ln ρ \ln(0.5)/\ln\rho ln ( 0.5 ) / ln ρ k = 1 + ln ( 0.5 ) / ln ρ k=1+\ln(0.5)/\ln\rho k = 1 + ln ( 0.5 ) / ln ρ ρ = 0.85 \rho=0.85 ρ = 0.85 k ≈ 5.27 k\approx5.27 k ≈ 5.27 ρ = 0.9 \rho=0.9 ρ = 0.9 k ≈ 7.58 k\approx7.58 k ≈ 7.58
6.8 重叠标签与 IC 序列的自相关
设信号是 AR(1)(系数 ρ \rho ρ t t t h h h S i , t = ∑ k = 1 h R i , t + k S_{i,t}=\sum_{k=1}^{h}R_{i,t+k} S i , t = ∑ k = 1 h R i , t + k σ 2 \sigma^2 σ 2 I C t ≈ 1 N h σ ∑ i z i , t S i , t \mathrm{IC}_t\approx\frac1{N\sqrt h\sigma}\sum_iz_{i,t}S_{i,t} IC t ≈ N h σ 1 ∑ i z i , t S i , t z z z σ z = 1 \sigma_z=1 σ z = 1 σ S = h σ \sigma_S=\sqrt h\sigma σ S = h σ 0 < j < h 0<j<h 0 < j < h
C o v ( I C t , I C t + j ) = 1 N 2 h σ 2 ∑ i E [ z i , t z i , t + j ] E [ S i , t S i , t + j ] = 1 N 2 h σ 2 ⋅ N ρ j ⋅ ( h − j ) σ 2 = ρ j ( h − j ) N h ,
\mathrm{Cov}(\mathrm{IC}_t,\mathrm{IC}_{t+j})=\frac1{N^2h\sigma^2}\sum_i\mathbb E[z_{i,t}z_{i,t+j}]\;\mathbb E[S_{i,t}S_{i,t+j}]=\frac{1}{N^2h\sigma^2}\cdot N\rho^j\cdot(h-j)\sigma^2=\frac{\rho^j(h-j)}{Nh},
Cov ( IC t , IC t + j ) = N 2 h σ 2 1 i ∑ E [ z i , t z i , t + j ] E [ S i , t S i , t + j ] = N 2 h σ 2 1 ⋅ N ρ j ⋅ ( h − j ) σ 2 = N h ρ j ( h − j ) , 只有同一资产项不为零(不同资产的信号与收益在零假设下独立),重叠的月份数是 h − j h-j h − j V a r ( I C t ) = 1 / N \mathrm{Var}(\mathrm{IC}_t)=1/N Var ( IC t ) = 1/ N
C o r r ( I C t , I C t + j ) = ρ j ( 1 − j h ) , 0 < j < h , 0 ( j ≥ h ) .
\mathrm{Corr}(\mathrm{IC}_t,\mathrm{IC}_{t+j})=\rho^{\,j}\Bigl(1-\frac jh\Bigr),\quad 0<j<h,\qquad 0\ (j\ge h).
Corr ( IC t , IC t + j ) = ρ j ( 1 − h j ) , 0 < j < h , 0 ( j ≥ h ) . 有限 T T T
V a r ( I C ‾ ) = σ I C 2 T V I F T , V I F T = 1 + 2 ∑ j = 1 T − 1 ( 1 − j T ) C o r r ( I C t , I C t + j ) .
\begin{aligned}
\mathrm{Var}(\overline{\mathrm{IC}})&=\frac{\sigma_{\mathrm{IC}}^2}{T}\mathrm{VIF}_T,\\
\mathrm{VIF}_T&=1+2\sum_{j=1}^{T-1}\left(1-\frac jT\right)
\mathrm{Corr}(\mathrm{IC}_t,\mathrm{IC}_{t+j}).
\end{aligned}
Var ( IC ) VIF T = T σ IC 2 VIF T , = 1 + 2 j = 1 ∑ T − 1 ( 1 − T j ) Corr ( IC t , IC t + j ) . 滞后 j j j T − j T-j T − j 1 − j / T 1-j/T 1 − j / T T T T h h h
V I F = 1 + 2 ∑ j = 1 h − 1 ρ j ( 1 − j h ) , n e f f = T / V I F .
\mathrm{VIF}=1+2\sum_{j=1}^{h-1}\rho^{j}\Bigl(1-\frac jh\Bigr),\qquad n_{\mathrm{eff}}=T/\mathrm{VIF} .
VIF = 1 + 2 j = 1 ∑ h − 1 ρ j ( 1 − h j ) , n eff = T / VIF . 极限:ρ = 0 \rho=0 ρ = 0 V I F = 1 \mathrm{VIF}=1 VIF = 1 t t t ρ = 1 \rho=1 ρ = 1 V I F = h \mathrm{VIF}=h VIF = h n e f f = T / h n_{\mathrm{eff}}=T/h n eff = T / h 在上述零世界、大截面、独立资产和独立月收益构造下,重叠标签与信号持续性共同产生该项相关 。其他生成机制中,序列相关收益、共同冲击与时变截面/缺失选择也可能产生 IC 相依;此式不能证明信号持续性是所有模型里唯一的来源。例:ρ = 0.85 \rho=0.85 ρ = 0.85 h = 3 h=3 h = 3 V I F = 1 + 2 ( 0.85 × 2 3 + 0.7225 × 1 3 ) = 2.615 \mathrm{VIF}=1+2(0.85\times\tfrac23+0.7225\times\tfrac13)=2.615 VIF = 1 + 2 ( 0.85 × 3 2 + 0.7225 × 3 1 ) = 2.615 T = 120 T=120 T = 120 n e f f = 45.9 n_{\mathrm{eff}}=45.9 n eff = 45.9 t t t 2.615 = 1.62 \sqrt{2.615}=1.62 2.615 = 1.62
V I F 120 = 1 + 2 [ 119 120 0.85 2 3 + 118 120 0.85 2 1 3 ] = 2.59753.
\begin{aligned}
\mathrm{VIF}_{120}&=1+2\left[\frac{119}{120}0.85\frac23
+\frac{118}{120}0.85^2\frac13\right]\\
&=2.59753.
\end{aligned}
VIF 120 = 1 + 2 [ 120 119 0.85 3 2 + 120 118 0.8 5 2 3 1 ] = 2.59753. 等效日期约46.20。这里“精确”只针对已给定自相关近似模型的有限期计数,不是有限截面真实IC的精确分布。
若同一模型改为 ρ = − 0.5 , h = 3 \rho=-0.5,h=3 ρ = − 0.5 , h = 3 V I F = 1 + 2 [ − 0.5 ( 2 / 3 ) + 0.25 ( 1 / 3 ) ] = 0.5 \mathrm{VIF}=1+2[-0.5(2/3)+0.25(1/3)]=0.5 VIF = 1 + 2 [ − 0.5 ( 2/3 ) + 0.25 ( 1/3 )] = 0.5 ρ = 1 \rho=1 ρ = 1 h h h 1 − j / T 1-j/T 1 − j / T T / h T/h T / h
Newey–West 的 Bartlett 权重取 ( 1 − j / ( L + 1 ) ) (1-j/(L+1)) ( 1 − j / ( L + 1 )) L = h − 1 L=h-1 L = h − 1 ( 1 − j / h ) (1-j/h) ( 1 − j / h ) 估计出来的 自协方差上,而这些自协方差已经含 ρ j ( 1 − j / h ) \rho^j(1-j/h) ρ j ( 1 − j / h )
V I F N W = 1 + 2 ∑ j = 1 h − 1 ρ j ( 1 − j h ) 2 .
\mathrm{VIF}_{\mathrm{NW}}=1+2\sum_{j=1}^{h-1}\rho^{j}\Bigl(1-\frac jh\Bigr)^{2} .
VIF NW = 1 + 2 j = 1 ∑ h − 1 ρ j ( 1 − h j ) 2 . ρ = 0.85 , h = 3 \rho=0.85,h=3 ρ = 0.85 , h = 3 V I F N W = 1.916 \mathrm{VIF}_{\mathrm{NW}}=1.916 VIF NW = 1.916 t t t 2.615 / 1.916 = 1.17 \sqrt{2.615/1.916}=1.17 2.615/1.916 = 1.17 ρ = 1 \rho=1 ρ = 1 V I F = h \mathrm{VIF}=h VIF = h ( 2 h 2 + 1 ) / ( 3 h ) (2h^2+1)/(3h) ( 2 h 2 + 1 ) / ( 3 h ) h = 3 h=3 h = 3 h = 12 h=12 h = 12
7. 金融解释
IC 是关联信息,不是收益。 报告“平均IC=0.05”指逐日期IC的时间均值为0.05,并不要求每月等于0.05;单个 I C t \mathrm{IC}_t IC t R p = I C ⋅ σ y R_p=\mathrm{IC}\cdot\sigma_y R p = IC ⋅ σ y σ y = 8 % \sigma_y=8\% σ y = 8% z / N z/N z / N
预测与持有之间隔着权重规则。 同一条 IC 序列可以对应截然不同的组合:十分位等权多空(只用排序,对离群值不敏感)、市值加权五分位(集中于大资产,容量大但噪声大)、信号比例加权(用到信号强度,对重尾信号很敏感)。第 11 节与第 13 节的构造例显示三者的毛收益与 t t t
信号持续性参与交易方式选择。 在预测方向与结构稳定的条件下,高持续性支持考察低频再平衡;短期信号应比较更快调仓的收益增量与成本。IC衰减曲线描述样本中不同领先期的关联;可交易持有期还须按实际权重、持有与成本检验,换手用于量化相应费用。
逐日处理的经济含义。 同一天内先排序再汇总,保证了你比较的是同一时点、同一宏观背景下的资产。市场整体涨跌(第一个月估值升、下个月市场涨)不会被当作信号能力。这对应第28章要强调的“同日截面变换”。
7.1 在同一个面板上看四个不同问题
沿用8.4节两日期、各四资产的手算面板:A的信号 ( 1 , 2 , 3 , 4 ) (1,2,3,4) ( 1 , 2 , 3 , 4 ) ( 0.10 , 0.12 , 0.14 , 0.16 ) (0.10,0.12,0.14,0.16) ( 0.10 , 0.12 , 0.14 , 0.16 ) ( 11 , 12 , 13 , 14 ) (11,12,13,14) ( 11 , 12 , 13 , 14 ) ( 0.26 , 0.24 , 0.22 , 0.20 ) (0.26,0.24,0.22,0.20) ( 0.26 , 0.24 , 0.22 , 0.20 ) ( 2.5 , 0.13 ) (2.5,0.13) ( 2.5 , 0.13 ) ( 12.5 , 0.23 ) (12.5,0.23) ( 12.5 , 0.23 )
对象
手算结果
回答的问题
混合相关(pooled correlation)
2 / 210 × 0.024 = 0.891 2/\sqrt{210\times0.024}=0.891 2/ 210 × 0.024 = 0.891 日期水平与日期内差异合在一起怎样共动
逐截面 Pearson/Rank IC
A为 + 1 +1 + 1 − 1 -1 − 1
同日哪个资产更强
原始信号 FM 斜率
+ 0.02 , − 0.02 +0.02,-0.02 + 0.02 , − 0.02 每单位信号对应多少收益
标准化 FM 与 z / N z/N z / N
两日 σ s = 5 / 4 = 1.118 \sigma_s=\sqrt{5/4}=1.118 σ s = 5/4 = 1.118 ± 0.02236 \pm0.02236 ± 0.02236
每一截面标准差信号对应多少收益
标准化用同一配对集、总体型标准差,带截距单信号 OLS 才有6.6节恒等式。多信号回归的偏斜率、Rank IC 或另一个筛选宇宙不继承它。各日 z = ( − 1.342 , − 0.447 , 0.447 , 1.342 ) z=(-1.342,-0.447,0.447,1.342) z = ( − 1.342 , − 0.447 , 0.447 , 1.342 ) w = z / 4 w=z/4 w = z /4 G = ∑ ∣ w ∣ = 0.89443 G=\sum|w|=0.89443 G = ∑ ∣ w ∣ = 0.89443 2 / G = 5 = 2.236 2/G=\sqrt5=2.236 2/ G = 5 = 2.236 ± 0.05 \pm0.05 ± 0.05
再减去成本才能谈净收益(net return):R n e t = R g r o s s − c ∑ i ∣ Δ w i ∣ R_{\mathrm{net}}=R_{\mathrm{gross}}-c\sum_i|\Delta w_i| R net = R gross − c ∑ i ∣Δ w i ∣ c c c − 0.001 -0.001 − 0.001
8. 数值例题:手算每一步
所有数字由本章 CLI 的 hand_examples() 产生,并在 qa/a5/claude/recompute/ch23_recompute.py 里用不同的实现独立复核。
8.1 并列与缺失下的名次、百分位
完整例题:名次与百分位
某日截面信号 x = ( 3 , 1 , NaN , 3 , 2 , 7 , 5 , 5 ) x=(3,\;1,\;\text{NaN},\;3,\;2,\;7,\;5,\;5) x = ( 3 , 1 , NaN , 3 , 2 , 7 , 5 , 5 ) n = 7 n=7 n = 7 1 , 2 , 3 , 3 , 5 , 5 , 7 1,2,3,3,5,5,7 1 , 2 , 3 , 3 , 5 , 5 , 7 ( 3.5 , 1 , NaN , 3.5 , 2 , 7 , 5.5 , 5.5 ) (3.5,\;1,\;\text{NaN},\;3.5,\;2,\;7,\;5.5,\;5.5) ( 3.5 , 1 , NaN , 3.5 , 2 , 7 , 5.5 , 5.5 ) ( r − 1 ) / 6 = ( 0.4167 , 0 , NaN , 0.4167 , 0.1667 , 1 , 0.75 , 0.75 ) (r-1)/6=(0.4167,\;0,\;\text{NaN},\;0.4167,\;0.1667,\;1,\;0.75,\;0.75) ( r − 1 ) /6 = ( 0.4167 , 0 , NaN , 0.4167 , 0.1667 , 1 , 0.75 , 0.75 )
8.2 分位桶
n = 10 n=10 n = 10 1 , … , 10 1,\allowbreak \dots,\allowbreak 10 1 , … , 10 q = 5 q=5 q = 5 u ~ = ( r − 0.5 ) / 10 \tilde u=(r-0.5)/10 u ~ = ( r − 0.5 ) /10 5 u ~ = 0.25 , 0.75 , 1.25 , … 5\tilde u=0.25,\allowbreak 0.75,\allowbreak 1.25,\allowbreak \dots 5 u ~ = 0.25 , 0.75 , 1.25 , … ⌊ ⋅ ⌋ + 1 = ( 1 , 1 , 2 , 2 , 3 , 3 , 4 , 4 , 5 , 5 ) \lfloor\cdot\rfloor+1=(1,\allowbreak 1,\allowbreak 2,\allowbreak 2,\allowbreak 3,\allowbreak 3,\allowbreak 4,\allowbreak 4,\allowbreak 5,\allowbreak 5) ⌊ ⋅ ⌋ + 1 = ( 1 , 1 , 2 , 2 , 3 , 3 , 4 , 4 , 5 , 5 ) x = ( 1 , 2 , 2 , 2 , 5 , 6 , 7 , 8 ) x=(1,\allowbreak 2,\allowbreak 2,\allowbreak 2,\allowbreak 5,\allowbreak 6,\allowbreak 7,\allowbreak 8) x = ( 1 , 2 , 2 , 2 , 5 , 6 , 7 , 8 ) n = 8 , q = 4 n=8,\allowbreak q=4 n = 8 , q = 4 ( 1 , 3 , 3 , 3 , 5 , 6 , 7 , 8 ) (1,\allowbreak 3,\allowbreak 3,\allowbreak 3,\allowbreak 5,\allowbreak 6,\allowbreak 7,\allowbreak 8) ( 1 , 3 , 3 , 3 , 5 , 6 , 7 , 8 ) u ~ = ( r − 0.5 ) / 8 = ( 0.0625 , 0.3125 , 0.3125 , 0.3125 , 0.5625 , 0.6875 , 0.8125 , 0.9375 ) \tilde u=(r-0.5)/8=(0.0625,\allowbreak 0.3125,\allowbreak 0.3125,\allowbreak 0.3125,\allowbreak 0.5625,\allowbreak 0.6875,\allowbreak 0.8125,\allowbreak 0.9375) u ~ = ( r − 0.5 ) /8 = ( 0.0625 , 0.3125 , 0.3125 , 0.3125 , 0.5625 , 0.6875 , 0.8125 , 0.9375 ) 4 u ~ = ( 0.25 , 1.25 , 1.25 , 1.25 , 2.25 , 2.75 , 3.25 , 3.75 ) 4\tilde u=(0.25,\allowbreak 1.25,\allowbreak 1.25,\allowbreak 1.25,\allowbreak 2.25,\allowbreak 2.75,\allowbreak 3.25,\allowbreak 3.75) 4 u ~ = ( 0.25 , 1.25 , 1.25 , 1.25 , 2.25 , 2.75 , 3.25 , 3.75 ) ( 1 , 2 , 2 , 2 , 3 , 3 , 4 , 4 ) (1,\allowbreak 2,\allowbreak 2,\allowbreak 2,\allowbreak 3,\allowbreak 3,\allowbreak 4,\allowbreak 4) ( 1 , 2 , 2 , 2 , 3 , 3 , 4 , 4 )
8.3 皮尔逊 IC 与 Rank IC:一个离群值
某日 6 个资产:信号 s = ( 1 , 2 , 3 , 4 , 5 , 20 ) s=(1,2,3,4,5,20) s = ( 1 , 2 , 3 , 4 , 5 , 20 ) y = ( 0.02 , 0.01 , 0.04 , 0.03 , 0.06 , − 0.05 ) y=(0.02,\,0.01,\,0.04,\,0.03,\,0.06,\,-0.05) y = ( 0.02 , 0.01 , 0.04 , 0.03 , 0.06 , − 0.05 ) s ˉ = 5.833 \bar s=5.833 s ˉ = 5.833 y ˉ = 0.01833 \bar y=0.01833 y ˉ = 0.01833 ∑ ( s − s ˉ ) ( y − y ˉ ) = − 1.0617 \sum(s-\bar s)(y-\bar y)=-1.0617 ∑ ( s − s ˉ ) ( y − y ˉ ) = − 1.0617 ∑ ( s − s ˉ ) 2 = 250.83 \sum(s-\bar s)^2=250.83 ∑ ( s − s ˉ ) 2 = 250.83 ∑ ( y − y ˉ ) 2 = 0.007083 \sum(y-\bar y)^2=0.007083 ∑ ( y − y ˉ ) 2 = 0.007083 = − 1.0617 / 250.83 × 0.007083 = − 0.796 =-1.0617/\sqrt{250.83\times0.007083}=-0.796 = − 1.0617/ 250.83 × 0.007083 = − 0.796 1 , … , 6 1,\dots,6 1 , … , 6 ( 3 , 2 , 5 , 4 , 6 , 1 ) (3,2,5,4,6,1) ( 3 , 2 , 5 , 4 , 6 , 1 ) y y y − 0.05 -0.05 − 0.05 d = ( − 2 , 0 , − 2 , 0 , − 1 , 5 ) d=(-2,0,-2,0,-1,5) d = ( − 2 , 0 , − 2 , 0 , − 1 , 5 ) ∑ d 2 = 34 \sum d^2=34 ∑ d 2 = 34 = 1 − 6 × 34 / ( 6 × 35 ) = 0.0286 =1-6\times34/(6\times35)=0.0286 = 1 − 6 × 34/ ( 6 × 35 ) = 0.0286 − 0.80 -0.80 − 0.80
8.4 混合相关与逐日 IC
两个日期,各 4 个资产。日期 A:s = ( 1 , 2 , 3 , 4 ) s=(1,2,3,4) s = ( 1 , 2 , 3 , 4 ) y = ( 0.10 , 0.12 , 0.14 , 0.16 ) y=(0.10,0.12,0.14,0.16) y = ( 0.10 , 0.12 , 0.14 , 0.16 ) I C = + 1 \mathrm{IC}=+1 IC = + 1 s = ( 11 , 12 , 13 , 14 ) s=(11,12,13,14) s = ( 11 , 12 , 13 , 14 ) y = ( 0.26 , 0.24 , 0.22 , 0.20 ) y=(0.26,0.24,0.22,0.20) y = ( 0.26 , 0.24 , 0.22 , 0.20 ) I C = − 1 \mathrm{IC}=-1 IC = − 1 s ˉ = 7.5 \bar s=7.5 s ˉ = 7.5 y ˉ = 0.18 \bar y=0.18 y ˉ = 0.18 ∑ ( s − s ˉ ) ( y − y ˉ ) = 1.10 + 0.90 = 2.00 \sum(s-\bar s)(y-\bar y)=1.10+0.90=2.00 ∑ ( s − s ˉ ) ( y − y ˉ ) = 1.10 + 0.90 = 2.00 ∑ ( s − s ˉ ) 2 = 210 \sum(s-\bar s)^2=210 ∑ ( s − s ˉ ) 2 = 210 ∑ ( y − y ˉ ) 2 = 0.024 \sum(y-\bar y)^2=0.024 ∑ ( y − y ˉ ) 2 = 0.024 = 2.00 / 210 × 0.024 = 0.891 =2.00/\sqrt{210\times0.024}=0.891 = 2.00/ 210 × 0.024 = 0.891 N = 4 N=4 N = 4 N T = 8 NT=8 N T = 8 0.10 / 4 = 0.025 0.10/4=0.025 0.10/4 = 0.025 − 0.025 -0.025 − 0.025 1 2 [ ( 2.5 − 7.5 ) ( 0.13 − 0.18 ) + ( 12.5 − 7.5 ) ( 0.23 − 0.18 ) ] = 1 2 ( 0.25 + 0.25 ) = 0.25 \tfrac12[(2.5-7.5)(0.13-0.18)+(12.5-7.5)(0.23-0.18)]=\tfrac12(0.25+0.25)=0.25 2 1 [( 2.5 − 7.5 ) ( 0.13 − 0.18 ) + ( 12.5 − 7.5 ) ( 0.23 − 0.18 )] = 2 1 ( 0.25 + 0.25 ) = 0.25 2.00 / 8 = 0.25 2.00/8=0.25 2.00/8 = 0.25
8.5 五分位多空与换手
完整例题:多空收益、换手与费用
N = 10 N=10 N = 10 ( 5 , 3 , 9 , 1 , 7 , 2 , 10 , 4 , 8 , 6 ) (5,\allowbreak 3,\allowbreak 9,\allowbreak 1,\allowbreak 7,\allowbreak 2,\allowbreak 10,\allowbreak 4,\allowbreak 8,\allowbreak 6) ( 5 , 3 , 9 , 1 , 7 , 2 , 10 , 4 , 8 , 6 ) ( 0.02 , 0.01 , 0.05 , − 0.01 , 0.03 , 0.00 , 0.06 , 0.01 , 0.04 , 0.02 ) (0.02,\allowbreak 0.01,\allowbreak 0.05,\allowbreak -0.01,\allowbreak 0.03,\allowbreak 0.00,\allowbreak 0.06,\allowbreak 0.01,\allowbreak 0.04,\allowbreak 0.02) ( 0.02 , 0.01 , 0.05 , − 0.01 , 0.03 , 0.00 , 0.06 , 0.01 , 0.04 , 0.02 ) q = 5 q=5 q = 5 ( 3 , 2 , 5 , 1 , 4 , 1 , 5 , 2 , 4 , 3 ) (3,\allowbreak 2,\allowbreak 5,\allowbreak 1,\allowbreak 4,\allowbreak 1,\allowbreak 5,\allowbreak 2,\allowbreak 4,\allowbreak 3) ( 3 , 2 , 5 , 1 , 4 , 1 , 5 , 2 , 4 , 3 ) 0.05 , 0.06 0.05,\allowbreak 0.06 0.05 , 0.06 − 0.01 , 0.00 -0.01,\allowbreak 0.00 − 0.01 , 0.00 − 0.005 -0.005 − 0.005 = 0.060 =0.060 = 0.060 ( 5 , 4 , 9 , 1 , 6 , 3 , 10 , 2 , 7 , 8 ) (5,\allowbreak 4,\allowbreak 9,\allowbreak 1,\allowbreak 6,\allowbreak 3,\allowbreak 10,\allowbreak 2,\allowbreak 7,\allowbreak 8) ( 5 , 4 , 9 , 1 , 6 , 3 , 10 , 2 , 7 , 8 ) ( 0.01 , 0.02 , 0.03 , − 0.02 , 0.02 , 0.01 , 0.03 , 0.00 , 0.04 , 0.05 ) (0.01,\allowbreak 0.02,\allowbreak 0.03,\allowbreak -0.02,\allowbreak 0.02,\allowbreak 0.01,\allowbreak 0.03,\allowbreak 0.00,\allowbreak 0.04,\allowbreak 0.05) ( 0.01 , 0.02 , 0.03 , − 0.02 , 0.02 , 0.01 , 0.03 , 0.00 , 0.04 , 0.05 ) 0.03 , 0.03 0.03,\allowbreak 0.03 0.03 , 0.03 − 0.02 , 0.00 -0.02,\allowbreak 0.00 − 0.02 , 0.00 − 0.01 -0.01 − 0.01 = 0.040 =0.040 = 0.040 ± 0.5 \pm0.5 ± 0.5 = ∣ 0 − ( − 0.5 ) ∣ + ∣ − 0.5 − 0 ∣ = 1.0 =|0-(-0.5)|+|{-0.5}-0|=1.0 = ∣0 − ( − 0.5 ) ∣ + ∣ − 0.5 − 0∣ = 1.0 = 0.040 − 0.0010 = 0.039 =0.040-0.0010=0.039 = 0.040 − 0.0010 = 0.039
8.6 z / N z/N z / N I C × σ r \mathrm{IC}\times\sigma_r IC × σ r
5 个资产:s = ( 2 , 4 , 6 , 8 , 10 ) s=(2,4,6,8,10) s = ( 2 , 4 , 6 , 8 , 10 ) y = ( 0.01 , 0.00 , 0.03 , 0.02 , 0.04 ) y=(0.01,0.00,0.03,0.02,0.04) y = ( 0.01 , 0.00 , 0.03 , 0.02 , 0.04 ) s ˉ = 6 \bar s=6 s ˉ = 6 σ s = 40 / 5 = 2.828 \sigma_s=\sqrt{40/5}=2.828 σ s = 40/5 = 2.828 z = ( − 1.414 , − 0.707 , 0 , 0.707 , 1.414 ) z=(-1.414,-0.707,0,0.707,1.414) z = ( − 1.414 , − 0.707 , 0 , 0.707 , 1.414 ) R p = 1 5 ∑ z i y i = 1 5 ( − 0.01414 + 0 + 0 + 0.01414 + 0.05657 ) = 0.011314 R_p=\frac15\sum z_iy_i=\frac15(-0.01414+0+0+0.01414+0.05657)=0.011314 R p = 5 1 ∑ z i y i = 5 1 ( − 0.01414 + 0 + 0 + 0.01414 + 0.05657 ) = 0.011314 I C = ∑ ( s − s ˉ ) ( y − y ˉ ) / ∑ ( s − s ˉ ) 2 ∑ ( y − y ˉ ) 2 = 0.16 / 40 × 0.001 = 0.8 \mathrm{IC}=\sum(s-\bar s)(y-\bar y)/\sqrt{\sum(s-\bar s)^2\sum(y-\bar y)^2}=0.16/\sqrt{40\times0.001}=0.8 IC = ∑ ( s − s ˉ ) ( y − y ˉ ) / ∑ ( s − s ˉ ) 2 ∑ ( y − y ˉ ) 2 = 0.16/ 40 × 0.001 = 0.8 σ y = 0.001 / 5 = 0.014142 \sigma_y=\sqrt{0.001/5}=0.014142 σ y = 0.001/5 = 0.014142 I C × σ y = 0.011314 \mathrm{IC}\times\sigma_y=0.011314 IC × σ y = 0.011314
8.7 Fama–MacBeth 的三期手算
3 个日期,4 个资产。日期 1:s = ( 1 , 2 , 3 , 4 ) s=(1,2,3,4) s = ( 1 , 2 , 3 , 4 ) y = ( 0.01 , 0.02 , 0.04 , 0.05 ) y=(0.01,0.02,0.04,0.05) y = ( 0.01 , 0.02 , 0.04 , 0.05 ) ∑ ( s − s ˉ ) ( y − y ˉ ) = 0.07 \sum(s-\bar s)(y-\bar y)=0.07 ∑ ( s − s ˉ ) ( y − y ˉ ) = 0.07 ∑ ( s − s ˉ ) 2 = 5 \sum(s-\bar s)^2=5 ∑ ( s − s ˉ ) 2 = 5 b ^ 1 = 0.014 \hat b_1=0.014 b ^ 1 = 0.014 s = ( 4 , 3 , 2 , 1 ) s=(4,3,2,1) s = ( 4 , 3 , 2 , 1 ) y = ( 0.02 , 0.02 , 0.01 , 0.00 ) y=(0.02,0.02,0.01,0.00) y = ( 0.02 , 0.02 , 0.01 , 0.00 ) 0.035 / 5 = 0.007 0.035/5=0.007 0.035/5 = 0.007 s = ( 1 , 3 , 2 , 4 ) s=(1,3,2,4) s = ( 1 , 3 , 2 , 4 ) y = ( 0.00 , 0.03 , 0.02 , 0.04 ) y=(0.00,0.03,0.02,0.04) y = ( 0.00 , 0.03 , 0.02 , 0.04 ) 0.065 / 5 = 0.013 0.065/5=0.013 0.065/5 = 0.013 b ˉ = 0.011333 \bar b=0.011333 b ˉ = 0.011333 ( 0.002667 , − 0.004333 , 0.001667 ) (0.002667,-0.004333,0.001667) ( 0.002667 , − 0.004333 , 0.001667 ) 2.867 × 10 − 5 2.867\times10^{-5} 2.867 × 1 0 − 5 s b = 2.867 × 10 − 5 / 2 = 0.003786 s_b=\sqrt{2.867\times10^{-5}/2}=0.003786 s b = 2.867 × 1 0 − 5 /2 = 0.003786 s e = 0.003786 / 3 = 0.002186 \mathrm{se}=0.003786/\sqrt3=0.002186 se = 0.003786/ 3 = 0.002186 t = 5.18 t=5.18 t = 5.18 t t t
8.8 重叠标签的有效样本数
ρ = 0.85 \rho=0.85 ρ = 0.85 h = 3 h=3 h = 3 V I F = 2.615 \mathrm{VIF}=2.615 VIF = 2.615 T = 120 T=120 T = 120 n e f f = 45.9 n_{\mathrm{eff}}=45.9 n eff = 45.9 t = 3.0 t=3.0 t = 3.0 3.0 / 2.615 = 1.86 3.0/\sqrt{2.615}=1.86 3.0/ 2.615 = 1.86 ρ = 1 \rho=1 ρ = 1 n e f f = T / h = 40 n_{\mathrm{eff}}=T/h=40 n eff = T / h = 40
9. Python 实现
核心在 factor_research.pyfactor_signals.pyt t t formation_return等形成期特征使用截止前允许的历史窗口,改变未来输入不应改写过去信号;lead_return与forward_label作为事后评价标签有意使用未来收益。标签不能作为信号日特征输入;标签含未来是测量对象的定义,不等于预测特征可以前视。
函数
输入
输出与边界
rank_cross_section、percentile_cross_section一维实数向量(NaN 为缺失)
平均名次/百分位;空截面全 NaN;无穷、布尔、文本、None、复数报错
quantile_bucket向量、桶数 q ≥ 2 q\ge2 q ≥ 2
桶号 1..q q q q q q
factor_rank日期×资产面板
逐行百分位;min_names 不足的行全 NaN
lead_return、forward_label月频连续 PeriodIndex 的收益面板
领先 k k k lag、horizon 控制的复利标签;输入索引缺日历月时报错,未来标签超出样本或所需收益缺失则为 NaN
information_coefficient、ic_series信号与标签
逐日 Pearson/Spearman;配对内排名;少于 min_obs 或常数返回 NaN
ic_summary、newey_west_variance_of_meanIC 序列、滞后数
ic_summary 返回均值、标准差、ICIR、朴素与 NW 的 t t t n e f f n_{\mathrm{eff}} n eff
ic_decay信号、收益、领先期集合
各领先期的平均 IC 与 t t t
bucket_returns信号、标签、桶数、可选权重面板
各桶均值与 LS;缺失或非正权重被排除
quantile_long_short_weights、signal_proportional_weights信号
买最高桶卖最低桶(各腿 1);去均值信号比例权重(毛暴露可设)
target_turnover、bucket_membership_turnover权重面板;信号与桶号
$\sum
fama_macbeth标签、若干信号面板
每期斜率、均值、朴素与 NW 标准误;样本不足或设计矩阵秩亏的日期被跳过并列出
月度标签的成交假设。 在单月例(lead_return 的 k = 1 k=1 k = 1 forward_label 的 horizon=1, lag=0)中,把第 t + 1 t+1 t + 1 t t t lag 是整月的执行延迟,不是日内成交模型。第22–28章的月度结果都按这个口径理解(French 行业例另外是修订后的聚合收益,不是成交序列)。
并列、缺失与排序规则一次集中说明。(1) 并列取平均名次,不按列顺序打破;(2) NaN 先丢弃再排名;(3) Rank IC 在“信号与标签都有效”的配对内部排名;(4) 常数或不足三个配对的日期 IC 为 NaN,不是 0;(5) 缺月的收益面板不允许用 shift 跨缺口;(6) 分位桶按日期单独计算,不用整个面板的分位点。
代码段一:名次、百分位、桶与手算值核对(对应 8.1–8.2 节)。
import numpy as np
from quant_course.factor_research import percentile_cross_section, quantile_bucket, rank_cross_section
x = np.array([3 , 1 , np.nan, 3 , 2 , 7 , 5 , 5 ])
np.testing.assert_allclose(rank_cross_section(x), [3.5 , 1 , np.nan, 3.5 , 2 , 7 , 5.5 , 5.5 ])
np.testing.assert_allclose(percentile_cross_section(x), [5 / 12 , 0 , np.nan, 5 / 12 , 1 / 6 , 1 , 0.75 , 0.75 ])
np.testing.assert_array_equal(quantile_bucket(np.arange(1.0 , 11.0 ), 5 ), [1 , 1 , 2 , 2 , 3 , 3 , 4 , 4 , 5 , 5 ])
np.testing.assert_array_equal(quantile_bucket([1 , 2 , 2 , 2 , 5 , 6 , 7 , 8 ], 4 ), [1 , 2 , 2 , 2 , 3 , 3 , 4 , 4 ])
shuffled = quantile_bucket([7 , 2 , 5 , 2 , 8 , 1 , 2 , 6 ], 4 )
np.testing.assert_array_equal(shuffled, [4 , 2 , 3 , 2 , 4 , 1 , 2 , 3 ])
print (rank_cross_section(x))
代码段二:皮尔逊 IC 与 Rank IC(8.3 节),混合相关与逐日 IC(8.4 节)。
import numpy as np
import pandas as pd
from quant_course.factor_research import ic_series, information_coefficient
s = np.array([1 , 2 , 3 , 4 , 5 , 20.0 ]); y = np.array([0.02 , 0.01 , 0.04 , 0.03 , 0.06 , -0.05 ])
assert abs (information_coefficient(s, y, method="pearson" ) - (-0.79648 )) < 1e-5
assert abs (information_coefficient(s, y, method="spearman" ) - 1 / 35 ) < 1e-12
idx = pd.period_range("2020-01" , periods=2 , freq="M" )
signal = pd.DataFrame([[1 , 2 , 3 , 4.0 ], [11 , 12 , 13 , 14.0 ]], index=idx, columns=list ("abcd" ))
label = pd.DataFrame([[0.10 , 0.12 , 0.14 , 0.16 ], [0.26 , 0.24 , 0.22 , 0.20 ]], index=idx, columns=list ("abcd" ))
per_date = ic_series(signal, label, method="pearson" )["ic" ]
pooled = np.corrcoef(signal.to_numpy().ravel(), label.to_numpy().ravel())[0 , 1 ]
np.testing.assert_allclose(per_date, [1.0 , -1.0 ])
assert abs (per_date.mean()) < 1e-12 and abs (pooled - 0.89087 ) < 1e-5
print (per_date.round (3 ).tolist(), round (pooled, 4 ))
代码段三:五分位多空、权重、换手与成本(8.5 节)。
import numpy as np
import pandas as pd
from quant_course.factor_research import (
bucket_membership_turnover, bucket_returns, quantile_long_short_weights, target_turnover,
)
idx = pd.period_range("2020-01" , periods=2 , freq="M" )
cols = list ("abcdefghij" )
signal = pd.DataFrame([[5 , 3 , 9 , 1 , 7 , 2 , 10 , 4 , 8 , 6.0 ], [5 , 4 , 9 , 1 , 6 , 3 , 10 , 2 , 7 , 8.0 ]], index=idx, columns=cols)
label = pd.DataFrame([[.02 , .01 , .05 , -.01 , .03 , .00 , .06 , .01 , .04 , .02 ],
[.01 , .02 , .03 , -.02 , .02 , .01 , .03 , .00 , .04 , .05 ]], index=idx, columns=cols)
buckets = bucket_returns(signal, label, 5 )
np.testing.assert_allclose(buckets["LS" ], [0.060 , 0.040 ])
w = quantile_long_short_weights(signal, 5 )
assert w.sum (axis=1 ).abs ().max () < 1e-12 and np.allclose(w.abs ().sum (axis=1 ), 2.0 )
turnover = target_turnover(w)
assert abs (turnover.iloc[1 ] - 1.0 ) < 1e-12
np.testing.assert_allclose(bucket_membership_turnover(signal, 5 ).iloc[1 ], 0.0 )
np.testing.assert_allclose(bucket_membership_turnover(signal, 5 , bucket=1 ).iloc[1 ], 0.5 )
net_second = buckets["LS" ].iloc[1 ] - 0.0010 * turnover.iloc[1 ]
assert abs (net_second - 0.039 ) < 1e-12
print (buckets.round (4 ))
代码段四:z / N z/N z / N
import numpy as np
import pandas as pd
from quant_course.factor_research import fama_macbeth
s = np.array([2 , 4 , 6 , 8 , 10.0 ]); y = np.array([0.01 , 0.00 , 0.03 , 0.02 , 0.04 ])
z = (s - s.mean()) / s.std(ddof=0 )
assert abs ((z * y).sum () / 5 - np.corrcoef(s, y)[0 , 1 ] * y.std(ddof=0 )) < 1e-15
assert abs (np.corrcoef(s, y)[0 , 1 ] - 0.8 ) < 1e-12
idx = pd.period_range("2020-01" , periods=3 , freq="M" )
cols = list ("abcd" )
signal = pd.DataFrame([[1 , 2 , 3 , 4.0 ], [4 , 3 , 2 , 1.0 ], [1 , 3 , 2 , 4.0 ]], index=idx, columns=cols)
label = pd.DataFrame([[.01 , .02 , .04 , .05 ], [.02 , .02 , .01 , .00 ], [.00 , .03 , .02 , .04 ]], index=idx, columns=cols)
fm = fama_macbeth(label, {"signal" : signal}, min_extra_obs=0 )
np.testing.assert_allclose(fm.slopes["signal" ], [0.014 , 0.007 , 0.013 ])
row = fm.summary.loc["signal" ]
assert abs (row["mean" ] - 0.011333333 ) < 1e-8 and abs (row["se_naive" ] - 0.0021858 ) < 1e-6 and abs (row["t_naive" ] - 5.185 ) < 1e-3
print (fm.slopes.round (4 ).T)
代码段五:标签构造与“改未来不改过去”(signal_time 与标签区间分开)。
import numpy as np
import pandas as pd
from quant_course.factor_research import factor_rank, forward_label, lead_return
from quant_course.factor_signals import formation_return
rng = np.random.default_rng(3 )
idx = pd.period_range("2015-01" , periods=40 , freq="M" )
returns = pd.DataFrame(rng.normal(0.01 , 0.05 , (40 , 12 )), index=idx, columns=[f"S{i:02d} " for i in range (12 )])
signal = factor_rank(formation_return(returns, window=11 , skip=1 ))
label = forward_label(returns, horizon=1 )
np.testing.assert_allclose(label.iloc[0 ], returns.iloc[1 ])
np.testing.assert_allclose(lead_return(returns, 2 ).iloc[0 ], returns.iloc[2 ])
assert label.iloc[-1 ].isna().all ()
shocked = returns.copy(); shocked.iloc[30 :] = 0.5
signal2 = factor_rank(formation_return(shocked, window=11 , skip=1 ))
pd.testing.assert_frame_equal(signal.iloc[:31 ], signal2.iloc[:31 ])
print (signal.iloc[11 :13 ].round (2 ))
关于代码段五:改动 30 月起的收益,信号行 0 至 30 不变。第 30 行用月份 19 , … , 29 19,\dots,29 19 , … , 29
默认离线入口。 在随书 I3 读者包根目录运行:
.venv/bin/python run_notebook.py notebooks/ch23_cross_sectional_research.ipynb
默认 RUN_FRENCH=False。Notebook 展示名次/并列、IC、混合相关、多空/换手、z / N z/N z / N h = 1 , 3 , 6 , 12 h=1,3,6,12 h = 1 , 3 , 6 , 12 RUN_DIR,不写CSV/PNG或生成历史图库。运行器另建 runs/execution_ch23_cross_sectional_research_<uuid>/,保存执行副本与状态。历史完整CLI code/ch23_cross_sectional_research.py 含French和重叠模拟,不能作为默认离线命令;下列历史种子和数值沿用既有实验,不要求重新执行。
CLI 种子:构造面板 20261023,混合相关演示 20261024,重叠标签模拟 20261025(ρ = 0.85 \rho=0.85 ρ = 0.85 ρ = 0 \rho=0 ρ = 0 signal_time 月末;标签是此后月份的收益;French 快照是已修订历史,不是时点版本。
10. 图形解读
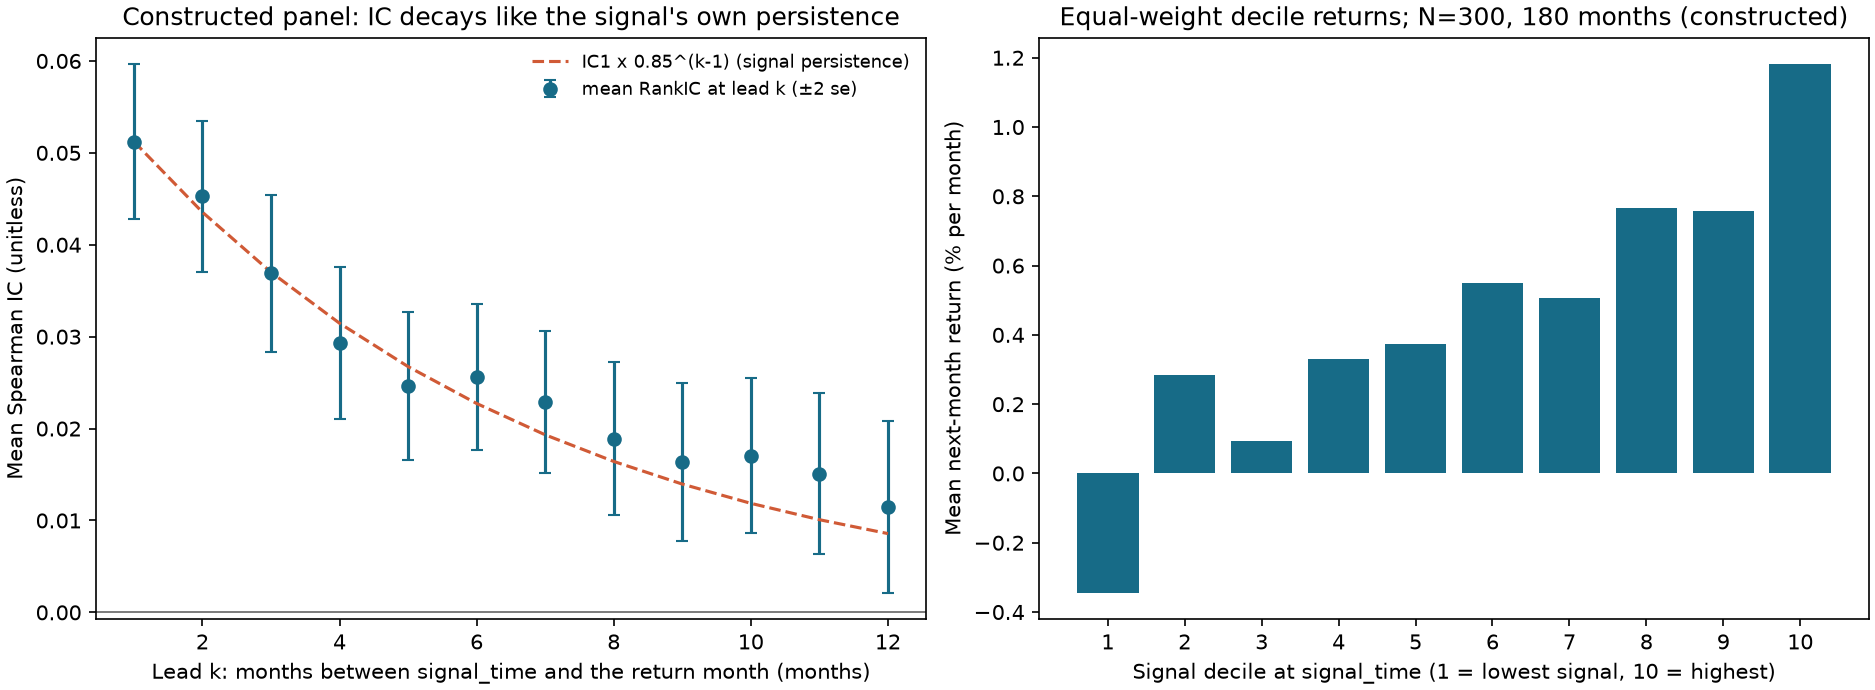
图 23-1:构造面板的 IC 衰减与十分位收益。 构造面板 N = 300 N=300 N = 300 = β ⋅ =\beta\cdot = β ⋅ β = 0.004 \beta=0.004 β = 0.004 k k k k k k 0.85 k − 1 0.85^{k-1} 0.8 5 k − 1
图 23-2:混合相关与逐日 IC。 构造设定:信号等于“日内纯噪声”加“日期水平项”,日期水平项与下个月市场收益相关(相关系数 0.5),收益只含市场项和与信号无关的噪声。左图每个点是一个月,横轴是下个月市场收益(%),纵轴是该月信号的截面均值:二者共动。右图是 120 个月逐日 IC 的直方图,黑线是它的均值 0.005,橙色虚线是混合相关 0.256。读法:混合相关远在 IC 分布之外,它度量的是日期水平的共动,不是资产之间的排序能力。
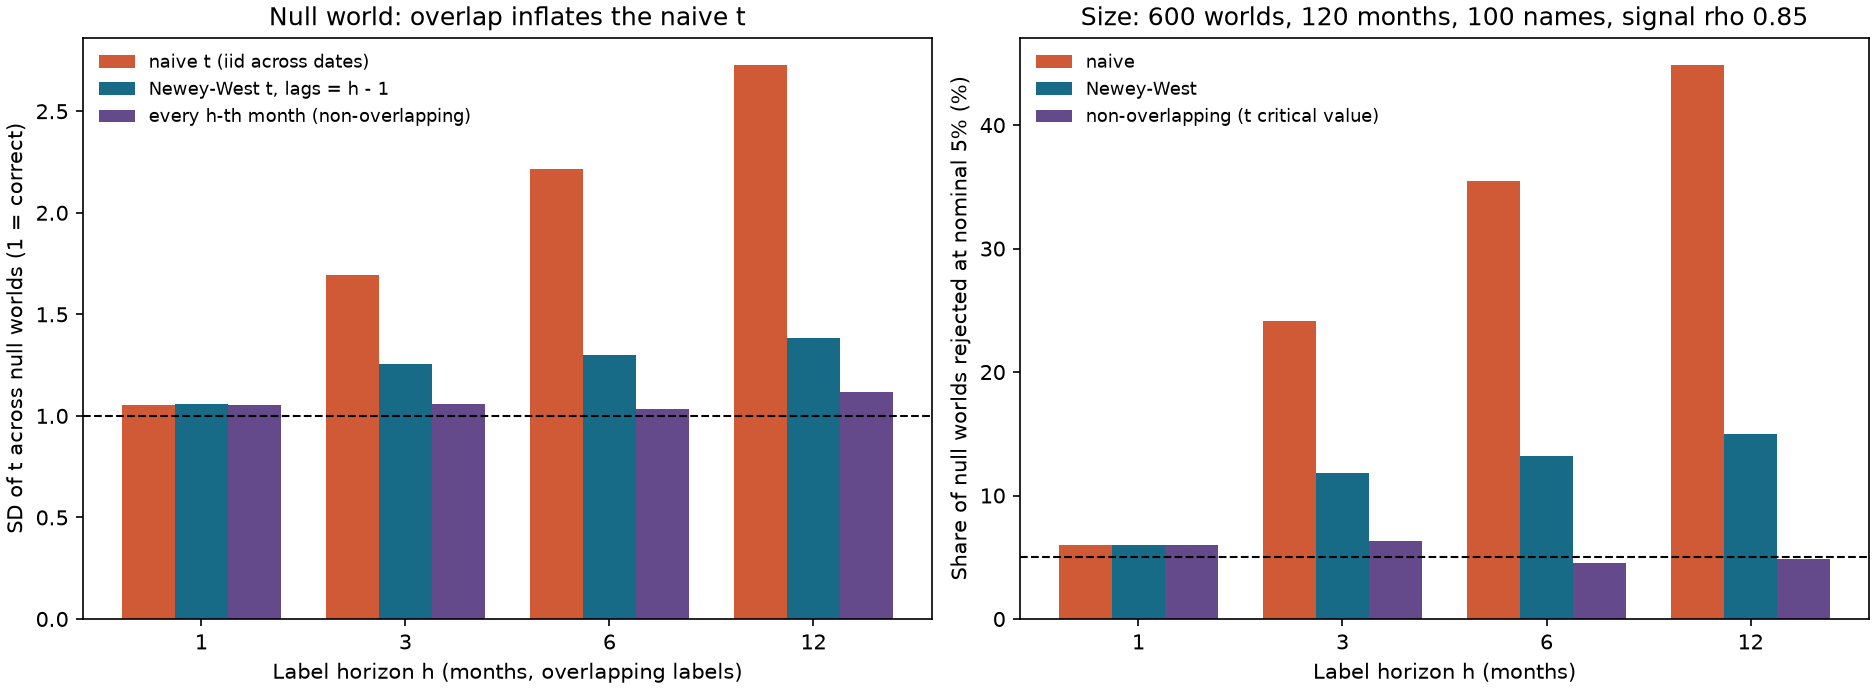
图 23-3:重叠标签下三种 t t t 零世界(收益与信号独立),120 个月、100 个资产、信号自相关 0.85,600 次模拟。左图纵轴是 t t t h − 1 h-1 h − 1 h h h t t t t t t h = 12 h=12 h = 12 T / h T/h T / h
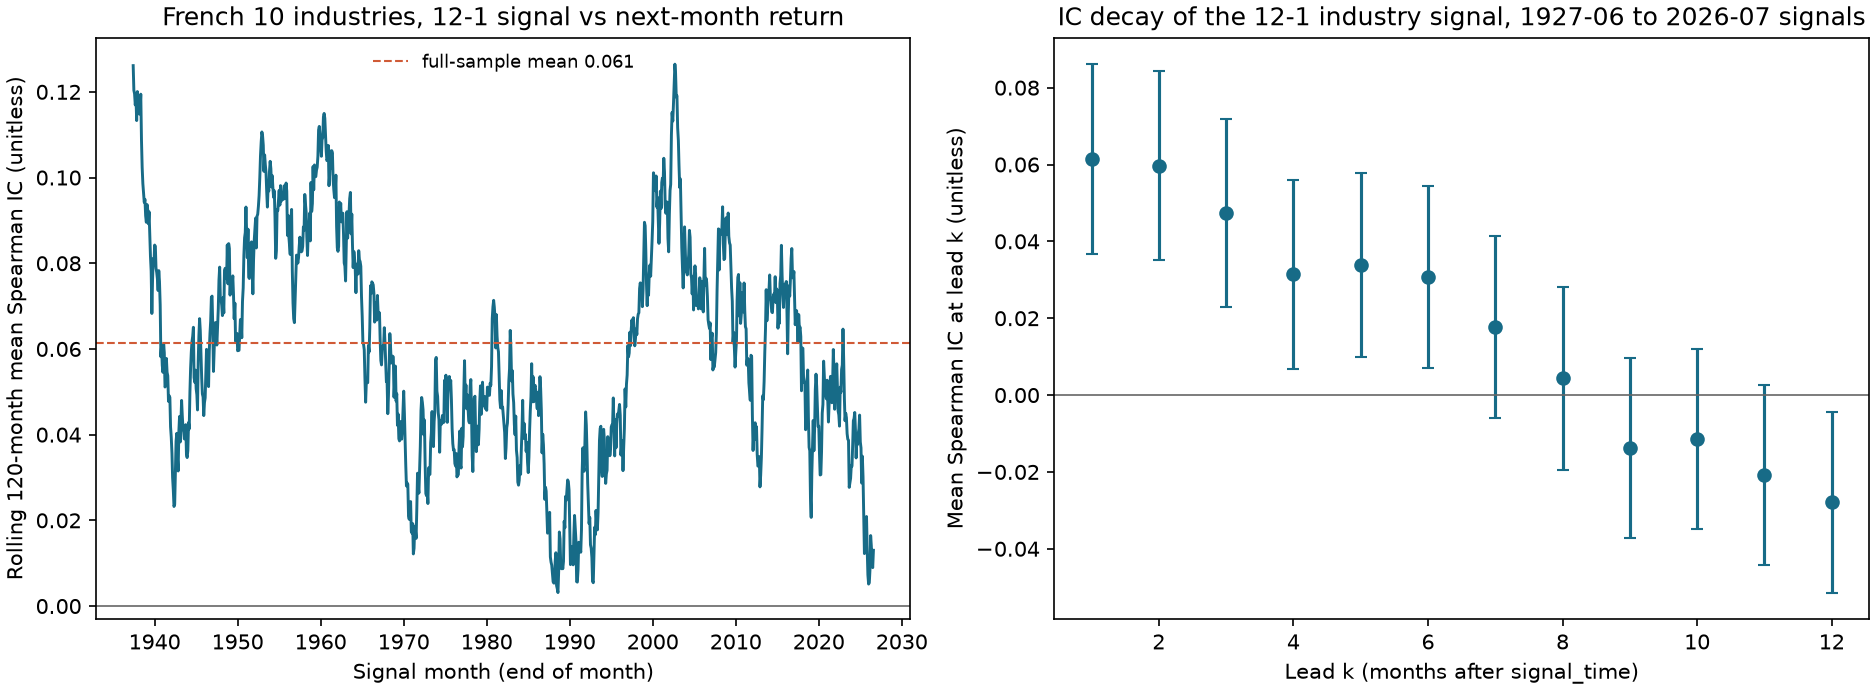
图 23-4:French 10 行业,12-1 信号的 Rank IC 与衰减。 左图是 120 个月滚动平均的 Rank IC(横轴为信号月份月末),橙线是全样本平均 0.061;右图是不同领先期的平均 Rank IC(竖线是 ±2 倍 Newey–West 标准误,滞后 0)。读法:左图平均 IC 在不同年代起伏很大(接近零到 0.12 以上);右图前 6 个月为正,第 9 个月起转负,第 12 个月为 − 0.028 -0.028 − 0.028 t = − 2.37 t=-2.37 t = − 2.37 M = 12 M=12 M = 12 Φ − 1 ( 1 − 0.05 / ( 2 × 12 ) ) ≈ 2.865 \Phi^{-1}(1-0.05/(2\times12))\approx2.865 Φ − 1 ( 1 − 0.05/ ( 2 × 12 )) ≈ 2.865
11. 真实市场历史例
数据与定义。 使用与第22章相同的冻结 French 10 行业价值加权月收益(ZIP SHA-256 ebd937a4b995d821867aeb956a96f09a666386f38fa82516b7d1767ee4a49ae5,处理后 CSV SHA-256 3b097d810c295d64eedfa1ece7067ff2a0707f5ca90e33935df9949251f70950,1926-07 至 2026-08 共 1,202 个月,单位小数月简单收益;来源与许可见第22章与 data/manifests/french_industries_2026-10-05.json)。信号 s i , t s_{i,t} s i , t t t t t − 11 t-11 t − 11 t − 1 t-1 t − 1 t + 1 t+1 t + 1 N = 10 N=10 N = 10
逐日 Rank IC。 全样本平均 Rank IC 0.0615(标准差 0.425,命中率 55.5%,t = 4.99 t=4.99 t = 4.99 T = 1190 T=1190 T = 1190 t = 4.41 t=4.41 t = 4.41 t = 2.45 t=2.45 t = 2.45 t = 1.70 t=1.70 t = 1.70 t = 1.70 t=1.70 t = 1.70 1 / 9 = 0.33 1/\sqrt{9}=0.33 1/ 9 = 0.33
IC 衰减。 领先 1 到 12 个月的平均 Rank IC 分别是 0.0615、0.0597、0.0474、0.0315、0.0338、0.0307、0.0178、0.0044、− 0.0137 -0.0137 − 0.0137 − 0.0114 -0.0114 − 0.0114 − 0.0208 -0.0208 − 0.0208 − 0.0279 -0.0279 − 0.0279 t t t − 1.17 -1.17 − 1.17 − 0.98 -0.98 − 0.98 − 1.77 -1.77 − 1.77 − 2.37 -2.37 − 2.37 t t t
五分位组合(每桶 2 个行业)。 5 个桶的下月平均收益依次是 0.759%、0.890%、0.981%、1.101%、1.278% 每月,单调上升;多空(第 5 桶减第 1 桶,各腿 2 个行业等权)均值 0.519% 每月,t = 3.64 t=3.64 t = 3.64
Fama–MacBeth。 把信号在日内标准化(总体型),每月回归标签 = a t + b t z + e =a_t+b_tz+e = a t + b t z + e b ˉ = 0.1686 % \bar b=0.1686\% b ˉ = 0.1686% t = 3.35 t=3.35 t = 3.35 b ^ t = I C t σ y , t \hat b_t=\mathrm{IC}_t\sigma_{y,t} b ^ t = IC t σ y , t 10 − 15 10^{-15} 1 0 − 15 t t t σ y , t \sigma_{y,t} σ y , t
这个例子说明什么,没有说明什么。 它演示了:同一个信号可以用逐日 IC、分位组合、FM 三种尺度度量,三者一致地给出正方向的结论,但显著性不同;IC 的时间序列在不同年代波动很大;衰减曲线描述这份样本的领先期关联,不能直接确定可交易期限。它没有说明:这一发现可交易(10 个行业组合是已修订的发布收益,不是成交序列;成本只在第22章作过假设值演示);统计推断稳健(10 个资产的截面小,三段的 t t t t t t
12. 常见错误
错误 1:混合所有日期的相关系数当作 IC。 8.4 节两个日期,日内 IC 是 + 1 +1 + 1 − 1 -1 − 1
import numpy as np
import pandas as pd
from quant_course.factor_research import ic_series, ic_summary
rng = np.random.default_rng(5 )
months, names = 120 , 200
level = rng.standard_normal(months)
signal = pd.DataFrame(rng.standard_normal((months, names)) + 2 * level[:, None ],
index=pd.period_range("2010-01" , periods=months, freq="M" ))
label = pd.DataFrame(0.045 * level[:, None ] + 0.08 * rng.standard_normal((months, names)), index=signal.index)
pooled = np.corrcoef(signal.to_numpy().ravel(), label.to_numpy().ravel())[0 , 1 ]
per_date = ic_summary(ic_series(signal, label, method="pearson" )["ic" ])
assert pooled > 0.2 and abs (per_date.mean) < 0.02 and abs (per_date.t_naive) < 3
print (round (pooled, 3 ), round (per_date.mean, 4 ), round (per_date.t_naive, 2 ))
错误 2:并列用行顺序打破。 若用“序数排名”(argsort),4 个同值信号的分桶取决于列的排列顺序;同一份数据换一下列序,组合就变了。
import numpy as np
from quant_course.factor_research import quantile_bucket
x = np.array([0.0 , 0.0 , 0.0 , 0.0 , 1.0 , 2.0 , 3.0 , 4.0 ])
average = quantile_bucket(x, 4 )
reordered = quantile_bucket(x[::-1 ], 4 )[::-1 ]
np.testing.assert_array_equal(average, reordered)
ordinal = np.argsort(np.argsort(x, kind="stable" ), kind="stable" )
ordinal_rev = np.argsort(np.argsort(x[::-1 ], kind="stable" ), kind="stable" )[::-1 ]
bucket_ord = lambda ranks: (4 * (ranks + 0.5 ) // 8 ).astype(int ) + 1
assert not np.array_equal(bucket_ord(ordinal), bucket_ord(ordinal_rev))
print (average.tolist(), bucket_ord(ordinal).tolist(), bucket_ord(ordinal_rev).tolist())
错误 3:先对全表排名再丢 NaN,或把 NaN 填 0 后排名。 前者的名次含有已被丢弃的资产,后者让缺失资产被排在“零信号”的位置。库函数在有效配对内排名。
错误 4:标签对齐错一个月(前视)。 把同月收益当预测标签(概念上的 k = 0 k=0 k = 0 lead_return 会拒绝此参数)会混入已发生的信息;下例故意直接配合同月 returns 展示错误;下例中构造“同月收益”与信号相关 0.7,而下一月完全无关。
import numpy as np
import pandas as pd
from quant_course.factor_research import ic_series, ic_summary, lead_return
rng = np.random.default_rng(9 )
idx = pd.period_range("2010-01" , periods=120 , freq="M" )
returns = pd.DataFrame(0.08 * rng.standard_normal((120 , 100 )), index=idx)
signal = returns.mul(0.7 ).add(0.08 * rng.standard_normal((120 , 100 )) * 0.714 )
same_month = ic_summary(ic_series(signal, returns, method="pearson" )["ic" ])
next_month = ic_summary(ic_series(signal, lead_return(returns, 1 ), method="pearson" )["ic" ])
assert same_month.mean > 0.5 and abs (next_month.t_naive) < 3
print (round (same_month.mean, 3 ), round (next_month.mean, 4 ))
错误 5:重叠标签用朴素 t t t 零世界、信号自相关 0.85、T = 120 T=120 T = 120 h = 3 h=3 h = 3 t t t h = 12 h=12 h = 12
错误 6:用全样本分位点分桶。 分位点来自整个面板,则早期日期的桶号依赖晚期数据。quantile_bucket 逐日计算;若自己写了 pd.qcut 对整个长表分桶,会犯这个错误。
错误 7:用同一个未来日期的市值或名单。 值加权用的 cap 与股票池必须是 signal_time 时已知的版本;用月底之后才可得的市值或退市标记,等价于前视。第24章与 Project 4 的时间字段表会列出每个字段的 available_at。
错误 8:把“t 显著”读成“收益可赚”。 构造面板的十分位多空毛收益 1.525% 每月、t = 10.4 t=10.4 t = 10.4
13. 量化研究应用
信号层的研究表。 Project 4(多因子策略)的研究接口可表示为长表,主键是 (date, security_id):原始特征、日内百分位、桶号、下月收益、h h h
构造面板上的完整链条(本章实验)。 面板 N = 300 N=300 N = 300 T = 180 T=180 T = 180 ρ = 0.85 \rho=0.85 ρ = 0.85 I C 1 ≈ 0.050 \mathrm{IC}_1\approx0.050 IC 1 ≈ 0.050 t = 12.1 t=12.1 t = 12.1 t = 12.1 t=12.1 t = 12.1 0.85 k − 1 0.85^{k-1} 0.8 5 k − 1 t = 10.4 t=10.4 t = 10.4 t = 4.90 t=4.90 t = 4.90 t = 12.2 t=12.2 t = 12.2 t t t z / N z/N z / N t = − 1.0 t=-1.0 t = − 1.0
对 Project 4 的约束。 (1) 任何因子都先给出逐日 IC 与 Rank IC、IC 衰减、分位单调性、换手;(2) 重叠标签只用不重叠样本或同时报告 NW;(3) 缺失与并列规则写入配置;(4) 多空权重规则、毛暴露、成本口径写入配置;(5) 所有试验进第22章的账本。本章完成的信号层不包含交易成本后的策略结论。
13.1 Project4 的接受范围与可交易子空间
层
当前接受入口与范围
本章如何使用
A5 信号准备
qa/a5/codex_followup_fixes/acceptance.md:构造 PIT、同日处理、信号契约;真实 EV 桥字段未齐不能默认为零读取特征与日期契约,未接受完整策略
A6 账本接口
qa/a6/codex_resume/acceptance.md:构造价格、上市过滤、退市与账本对接读取执行约束;全空间中性化后过滤仍有残余暴露
A7-B 成本实验
projects/project04/cost_execution_lab/ACCEPTED_VERSION.md:受限教学成本/执行实验成本敏感度是构造实验,不能当真实 Alpha/容量
一个四名反例能说明过滤为什么不是重新优化。行业一 A、B 权重 ( 0.3 , − 0.3 ) (0.3,-0.3) ( 0.3 , − 0.3 ) ( 0.2 , − 0.2 ) (0.2,-0.2) ( 0.2 , − 0.2 ) ( 0.3 , 0 , 0.2 , − 0.2 ) (0.3,0,0.2,-0.2) ( 0.3 , 0 , 0.2 , − 0.2 ) 1 / 0.7 1/0.7 1/0.7 3 / 7 3/7 3/7
完整 Project4 须在当期可交易集合重新构造/投影,并检查最终非零权重的行业暴露、净暴露、gross、个股上限、预算/现金及其他事先约束;可行集为空也须明确回退,不能宣称过滤继承原中性。A6已记录这个开放接口,本章示例仅给读者反例与检查目标,未修共享优化或运行新实证。完整P4方法、实现、真实数据与交易验证仍在后续项目队列。
14. 本章小结
截面研究把“很多资产在同一天”变成可检验的量:在每个日期内排序(名次、百分位、分位桶),在每个日期内度量预测(IC、Rank IC),再把日期当作样本汇总。混合相关把日期水平的共动混了进来;给定构造模型中重叠标签与持续信号一起使 IC 序列自相关,长期近似的有效样本数为 T / V I F T/\mathrm{VIF} T / VIF I C × σ y \mathrm{IC}\times\sigma_y IC × σ y
15. 练习题
23-E01(概念) 为什么信号时点是月末、标签从下一个月开始?列出一个月频研究表里必须标注的五个时间字段,并指出哪两个之间必须有严格先后。
23-E02(手算) 日期截面 x = ( 4 , 2 , 2 , NaN , 9 , 7 , 2 , 5 , 7 ) x=(4,2,2,\text{NaN},9,7,2,5,7) x = ( 4 , 2 , 2 , NaN , 9 , 7 , 2 , 5 , 7 ) q = 3 q=3 q = 3
23-E03(手算) 5 个资产信号 s = ( 1 , 2 , 3 , 4 , 12 ) s=(1,2,3,4,12) s = ( 1 , 2 , 3 , 4 , 12 ) y = ( 0.03 , 0.01 , 0.05 , 0.04 , − 0.06 ) y=(0.03,0.01,0.05,0.04,-0.06) y = ( 0.03 , 0.01 , 0.05 , 0.04 , − 0.06 )
23-E04(推导) 证明无并列时 ∑ ( r i − r ˉ ) 2 = n ( n 2 − 1 ) / 12 \sum(r_i-\bar r)^2=n(n^2-1)/12 ∑ ( r i − r ˉ ) 2 = n ( n 2 − 1 ) /12 1 − 6 ∑ d 2 / ( n ( n 2 − 1 ) ) 1-6\sum d^2/(n(n^2-1)) 1 − 6 ∑ d 2 / ( n ( n 2 − 1 ))
23-E05(手算) 两个日期各 3 个资产:A:s = ( 1 , 2 , 3 ) s=(1,2,3) s = ( 1 , 2 , 3 ) y = ( 0.01 , 0.02 , 0.03 ) y=(0.01,0.02,0.03) y = ( 0.01 , 0.02 , 0.03 ) s = ( 5 , 6 , 7 ) s=(5,6,7) s = ( 5 , 6 , 7 ) y = ( 0.07 , 0.06 , 0.05 ) y=(0.07,0.06,0.05) y = ( 0.07 , 0.06 , 0.05 )
23-E06(手算) 4 个资产 s = ( 1 , 3 , 5 , 7 ) s=(1,3,5,7) s = ( 1 , 3 , 5 , 7 ) y = ( 0.02 , 0.01 , 0.05 , 0.04 ) y=(0.02,0.01,0.05,0.04) y = ( 0.02 , 0.01 , 0.05 , 0.04 ) z z z 1 N ∑ z i y i = I C × σ y \frac1N\sum z_iy_i=\mathrm{IC}\times\sigma_y N 1 ∑ z i y i = IC × σ y
23-E07(手算) 两个月 8 个资产,q = 4 q=4 q = 4 ( 3 , 1 , 8 , 5 , 6 , 2 , 7 , 4 ) (3,\allowbreak 1,\allowbreak 8,\allowbreak 5,\allowbreak 6,\allowbreak 2,\allowbreak 7,\allowbreak 4) ( 3 , 1 , 8 , 5 , 6 , 2 , 7 , 4 ) ( 3 , 2 , 8 , 1 , 6 , 5 , 7 , 4 ) (3,\allowbreak 2,\allowbreak 8,\allowbreak 1,\allowbreak 6,\allowbreak 5,\allowbreak 7,\allowbreak 4) ( 3 , 2 , 8 , 1 , 6 , 5 , 7 , 4 ) ( 0.03 , 0.00 , 0.06 , 0.02 , 0.04 , 0.01 , 0.05 , 0.02 ) (0.03,\allowbreak 0.00,\allowbreak 0.06,\allowbreak 0.02,\allowbreak 0.04,\allowbreak 0.01,\allowbreak 0.05,\allowbreak 0.02) ( 0.03 , 0.00 , 0.06 , 0.02 , 0.04 , 0.01 , 0.05 , 0.02 ) ( 0.02 , − 0.01 , 0.05 , 0.00 , 0.03 , 0.02 , 0.04 , 0.01 ) (0.02,\allowbreak -0.01,\allowbreak 0.05,\allowbreak 0.00,\allowbreak 0.03,\allowbreak 0.02,\allowbreak 0.04,\allowbreak 0.01) ( 0.02 , − 0.01 , 0.05 , 0.00 , 0.03 , 0.02 , 0.04 , 0.01 )
23-E08(计算) 按6.8节长期近似,信号自相关 ρ = 0.9 \rho=0.9 ρ = 0.9 h = 4 h=4 h = 4 T = 240 T=240 T = 240 n e f f n_{\mathrm{eff}} n eff t = 3.1 t=3.1 t = 3.1 h − 1 = 3 h-1=3 h − 1 = 3 t t t
23-E09(解释) 信号 AR(1) 系数 0.9:半衰期是多少?若某信号的 IC 半衰期只有 1 个月,你会怎样选择再平衡频率,为什么?
23-R01(配对与日期,延伸练习) 重做3.1节:写出三个日期的 N s i g n a l , t N_{\mathrm{signal},t} N signal , t n p a i r , t n_{\mathrm{pair},t} n pair , t T v a l i d T_{\mathrm{valid}} T valid
23-R03(模型条件,延伸练习) 在6.8节给定的大截面相关模型下,T = 120 , h = 3 T=120,h=3 T = 120 , h = 3 ρ = 0.85 , − 0.5 \rho=0.85,-0.5 ρ = 0.85 , − 0.5
23-R02(组合与接口,延伸练习) 对7.1节,写出原始/标准化 FM 斜率、z / N z/N z / N
16. 编程练习
23-P01 写出一个函数,对日期×资产面板返回 5 个桶的平均下月收益与多空,使用 quantile_bucket 与 lead_return;在构造数据上验证 5 桶单调且多空为正;输入含 NaN 与并列时不报错。验收:三类输入各一个断言。
23-P02 在一个构造面板上,同时计算逐日 Pearson IC 与混合相关,制造“信号的日期水平项与市场共动”的情形并验证混合相关远大于平均 IC。验收:混合相关 > 0.2 >0.2 > 0.2 < 0.02 <0.02 < 0.02
23-P03 零世界(信号 AR(1) ρ = 0.85 \rho=0.85 ρ = 0.85 h = 3 h=3 h = 3 t t t
17. 挑战题
23-C01(推导) 在二元正态假设下推导 q q q 2 I C σ y q φ ( c q ) 2\,\mathrm{IC}\,\sigma_y\,q\,\varphi(c_q) 2 IC σ y q φ ( c q ) q = 3 , 5 , 10 , 20 q=3,5,10,20 q = 3 , 5 , 10 , 20 q φ ( c q ) q\varphi(c_q) q φ ( c q )
23-C02(开放) 设计第24章 Value 的截面研究表:列出每一列的名称、来源、available_at 规则、缺失与并列规则、标签区间、行业与市值处理,并写出至少三个会让你判断“逐日 IC 为正是假象”的检验。评分:时间字段正确性 30,缺失与并列规则 20,检验设计 30,对重叠标签与面板相依的处理 20。
18. 完整答案与参考实现
23-E01 本章约定月末信号用截止前已可得且已入库的信息,实际成交在信号之后。五类时间对象:报告期 period_end/事件时间、公开与入库 available_at/ingested_at、signal_time(当前程序用下一月首时刻严格截止)、trade_time、标签起止。输入须在信号截止前,且 signal_time < trade_time;可执行收益从实际成交价起算。当前下月月收盘标签是虚拟月末成交研究代理,含实际成交前一段,不能仅凭月份靠后就满足执行时序。
23-E02 有效值 ( 4 , 2 , 2 , 9 , 7 , 2 , 5 , 7 ) (4,2,2,9,7,2,5,7) ( 4 , 2 , 2 , 9 , 7 , 2 , 5 , 7 ) n = 8 n=8 n = 8 2 , 2 , 2 , 4 , 5 , 7 , 7 , 9 2,2,2,4,5,7,7,9 2 , 2 , 2 , 4 , 5 , 7 , 7 , 9 = ( 4 , 2 , 2 , NaN , 8 , 6.5 , 2 , 5 , 6.5 ) =(4,2,2,\text{NaN},8,6.5,2,5,6.5) = ( 4 , 2 , 2 , NaN , 8 , 6.5 , 2 , 5 , 6.5 ) ( r − 1 ) / 7 (r-1)/7 ( r − 1 ) /7 ( 0.4286 , 0.1429 , 0.1429 , NaN , 1 , 0.7857 , 0.1429 , 0.5714 , 0.7857 ) (0.4286,0.1429,0.1429,\text{NaN},1,0.7857,0.1429,0.5714,0.7857) ( 0.4286 , 0.1429 , 0.1429 , NaN , 1 , 0.7857 , 0.1429 , 0.5714 , 0.7857 ) q = 3 q=3 q = 3 u ~ = ( r − 0.5 ) / 8 \tilde u=(r-0.5)/8 u ~ = ( r − 0.5 ) /8 3 u ~ 3\tilde u 3 u ~ ( 2 , 1 , 1 , NaN , 3 , 3 , 1 , 2 , 3 ) (2,1,1,\text{NaN},3,3,1,2,3) ( 2 , 1 , 1 , NaN , 3 , 3 , 1 , 2 , 3 )
23-E03 s ˉ = 4.4 \bar s=4.4 s ˉ = 4.4 y ˉ = 0.014 \bar y=0.014 y ˉ = 0.014 = − 0.865 =-0.865 = − 0.865 − 0.06 -0.06 − 0.06 ( 3 , 2 , 5 , 4 , 1 ) (3,2,5,4,1) ( 3 , 2 , 5 , 4 , 1 ) ( 1 , 2 , 3 , 4 , 5 ) (1,2,3,4,5) ( 1 , 2 , 3 , 4 , 5 ) d = ( − 2 , 0 , − 2 , 0 , 4 ) d=(-2,0,-2,0,4) d = ( − 2 , 0 , − 2 , 0 , 4 ) ∑ d 2 = 24 \sum d^2=24 ∑ d 2 = 24 ρ S = 1 − 6 × 24 / ( 5 × 24 ) = 1 − 1.2 = − 0.2 \rho_S=1-6\times24/(5\times24)=1-1.2=-0.2 ρ S = 1 − 6 × 24/ ( 5 × 24 ) = 1 − 1.2 = − 0.2 − 0.2 -0.2 − 0.2
23-E04 名次是 1 , … , n 1,\dots,n 1 , … , n r ˉ = ( n + 1 ) / 2 \bar r=(n+1)/2 r ˉ = ( n + 1 ) /2 ∑ r i 2 = n ( n + 1 ) ( 2 n + 1 ) / 6 \sum r_i^2=n(n+1)(2n+1)/6 ∑ r i 2 = n ( n + 1 ) ( 2 n + 1 ) /6 ∑ ( r i − r ˉ ) 2 = n ( n + 1 ) ( 2 n + 1 ) / 6 − n ( n + 1 ) 2 / 4 = n ( n + 1 ) [ 2 ( 2 n + 1 ) − 3 ( n + 1 ) ] / 12 = n ( n + 1 ) ( n − 1 ) / 12 = n ( n 2 − 1 ) / 12 \sum(r_i-\bar r)^2=n(n+1)(2n+1)/6-n(n+1)^2/4=n(n+1)[2(2n+1)-3(n+1)]/12=n(n+1)(n-1)/12=n(n^2-1)/12 ∑ ( r i − r ˉ ) 2 = n ( n + 1 ) ( 2 n + 1 ) /6 − n ( n + 1 ) 2 /4 = n ( n + 1 ) [ 2 ( 2 n + 1 ) − 3 ( n + 1 )] /12 = n ( n + 1 ) ( n − 1 ) /12 = n ( n 2 − 1 ) /12 d i = r i − q i d_i=r_i-q_i d i = r i − q i ∑ d i 2 \sum d_i^2 ∑ d i 2 ∑ ( r i − r ˉ ) ( q i − q ˉ ) = n ( n 2 − 1 ) / 12 − 1 2 ∑ d i 2 \sum(r_i-\bar r)(q_i-\bar q)=n(n^2-1)/12-\tfrac12\sum d_i^2 ∑ ( r i − r ˉ ) ( q i − q ˉ ) = n ( n 2 − 1 ) /12 − 2 1 ∑ d i 2 n ( n 2 − 1 ) / 12 n(n^2-1)/12 n ( n 2 − 1 ) /12
23-E05 日期 A:s , y s,y s , y I C = + 1 \mathrm{IC}=+1 IC = + 1 s s s y y y I C = − 1 \mathrm{IC}=-1 IC = − 1 s ˉ = 4 \bar s=4 s ˉ = 4 y ˉ = 0.04 \bar y=0.04 y ˉ = 0.04 s − 4 = ( − 3 , − 2 , − 1 ) s-4=(-3,-2,-1) s − 4 = ( − 3 , − 2 , − 1 ) y − 0.04 = ( − 0.03 , − 0.02 , − 0.01 ) y-0.04=(-0.03,-0.02,-0.01) y − 0.04 = ( − 0.03 , − 0.02 , − 0.01 ) 0.09 + 0.04 + 0.01 = 0.14 0.09+0.04+0.01=0.14 0.09 + 0.04 + 0.01 = 0.14 s − 4 = ( 1 , 2 , 3 ) s-4=(1,2,3) s − 4 = ( 1 , 2 , 3 ) y − 0.04 = ( 0.03 , 0.02 , 0.01 ) y-0.04=(0.03,0.02,0.01) y − 0.04 = ( 0.03 , 0.02 , 0.01 ) 0.03 + 0.04 + 0.03 = 0.10 0.03+0.04+0.03=0.10 0.03 + 0.04 + 0.03 = 0.10 0.24 0.24 0.24 N T = 6 NT=6 N T = 6 0.04 0.04 0.04 ∑ ( s − s ˉ ) 2 = 28 \sum(s-\bar s)^2=28 ∑ ( s − s ˉ ) 2 = 28 ∑ ( y − y ˉ ) 2 = 0.0028 \sum(y-\bar y)^2=0.0028 ∑ ( y − y ˉ ) 2 = 0.0028 = 0.24 / 28 × 0.0028 = 0.857 =0.24/\sqrt{28\times0.0028}=0.857 = 0.24/ 28 × 0.0028 = 0.857 ∑ ( s − 2 ) ( y − 0.02 ) / 3 = 0.02 / 3 = 0.00667 \sum(s-2)(y-0.02)/3=0.02/3=0.00667 ∑ ( s − 2 ) ( y − 0.02 ) /3 = 0.02/3 = 0.00667 − 0.00667 -0.00667 − 0.00667 1 2 [ ( 2 − 4 ) ( 0.02 − 0.04 ) + ( 6 − 4 ) ( 0.06 − 0.04 ) ] = 1 2 ( 0.04 + 0.04 ) = 0.04 \tfrac12[(2-4)(0.02-0.04)+(6-4)(0.06-0.04)]=\tfrac12(0.04+0.04)=0.04 2 1 [( 2 − 4 ) ( 0.02 − 0.04 ) + ( 6 − 4 ) ( 0.06 − 0.04 )] = 2 1 ( 0.04 + 0.04 ) = 0.04
23-E06 s ˉ = 4 \bar s=4 s ˉ = 4 σ s = ( 9 + 1 + 1 + 9 ) / 4 = 5 = 2.236 \sigma_s=\sqrt{(9+1+1+9)/4}=\sqrt5=2.236 σ s = ( 9 + 1 + 1 + 9 ) /4 = 5 = 2.236 z = ( − 1.342 , − 0.447 , 0.447 , 1.342 ) z=(-1.342,-0.447,0.447,1.342) z = ( − 1.342 , − 0.447 , 0.447 , 1.342 ) 1 4 ∑ z i y i = 1 4 ( − 0.02683 − 0.00447 + 0.02236 + 0.05367 ) = 0.01118 \frac14\sum z_iy_i=\frac14(-0.02683-0.00447+0.02236+0.05367)=0.01118 4 1 ∑ z i y i = 4 1 ( − 0.02683 − 0.00447 + 0.02236 + 0.05367 ) = 0.01118 = 0.7071 =0.7071 = 0.7071 σ y = 1 4 ∑ ( y − 0.03 ) 2 = ( 0.0001 + 0.0004 + 0.0004 + 0.0001 ) / 4 = 0.015811 \sigma_y=\sqrt{\tfrac14\sum(y-0.03)^2}=\sqrt{(0.0001+0.0004+0.0004+0.0001)/4}=0.015811 σ y = 4 1 ∑ ( y − 0.03 ) 2 = ( 0.0001 + 0.0004 + 0.0004 + 0.0001 ) /4 = 0.015811 I C × σ y = 0.011180 \mathrm{IC}\times\sigma_y=0.011180 IC × σ y = 0.011180
23-E07 月 1:q = 4 q=4 q = 4 n = 8 n=8 n = 8 ⌊ 4 ( 2 r − 1 ) / 16 ⌋ + 1 \lfloor4(2r-1)/16\rfloor+1 ⌊ 4 ( 2 r − 1 ) /16 ⌋ + 1 0.06 , 0.05 0.06,\allowbreak 0.05 0.06 , 0.05 0.00 , 0.01 0.00,\allowbreak 0.01 0.00 , 0.01 = 0.050 =0.050 = 0.050 0.05 , 0.04 0.05,\allowbreak 0.04 0.05 , 0.04 0.00 , − 0.01 0.00,\allowbreak -0.01 0.00 , − 0.01 − 0.005 -0.005 − 0.005 = 0.050 =0.050 = 0.050 ± 0.5 \pm0.5 ± 0.5 = 0.5 + 0.5 = 1.0 =0.5+0.5=1.0 = 0.5 + 0.5 = 1.0 = 0.050 − 0.0010 × 1.0 = 0.049 =0.050-0.0010\times1.0=0.049 = 0.050 − 0.0010 × 1.0 = 0.049
23-E08 V I F = 1 + 2 [ 0.9 × 3 4 + 0.81 × 2 4 + 0.729 × 1 4 ] = 1 + 2 ( 0.675 + 0.405 + 0.18225 ) = 3.5245 \mathrm{VIF}=1+2[0.9\times\tfrac34+0.81\times\tfrac24+0.729\times\tfrac14]=1+2(0.675+0.405+0.18225)=3.5245 VIF = 1 + 2 [ 0.9 × 4 3 + 0.81 × 4 2 + 0.729 × 4 1 ] = 1 + 2 ( 0.675 + 0.405 + 0.18225 ) = 3.5245 n e f f = 240 / 3.5245 = 68.1 n_{\mathrm{eff}}=240/3.5245=68.1 n eff = 240/3.5245 = 68.1 t = 3.1 / 3.5245 = 1.65 t=3.1/\sqrt{3.5245}=1.65 t = 3.1/ 3.5245 = 1.65 V I F N W = 1 + 2 [ 0.9 × ( 3 4 ) 2 + 0.81 × ( 2 4 ) 2 + 0.729 × ( 1 4 ) 2 ] = 1 + 2 ( 0.50625 + 0.2025 + 0.04556 ) = 2.5086 \mathrm{VIF}_{\mathrm{NW}}=1+2[0.9\times(\tfrac34)^2+0.81\times(\tfrac24)^2+0.729\times(\tfrac14)^2]=1+2(0.50625+0.2025+0.04556)=2.5086 VIF NW = 1 + 2 [ 0.9 × ( 4 3 ) 2 + 0.81 × ( 4 2 ) 2 + 0.729 × ( 4 1 ) 2 ] = 1 + 2 ( 0.50625 + 0.2025 + 0.04556 ) = 2.5086 t = 3.1 / 2.5086 = 1.957 t=3.1/\sqrt{2.5086}=1.957 t = 3.1/ 2.5086 = 1.957 t = 3.1 t=3.1 t = 3.1
23-E09 按6.7节稳定线性构造,半衰期 ln 0.5 / ln 0.9 = 6.58 \ln0.5/\ln0.9=6.58 ln 0.5/ ln 0.9 = 6.58 ρ \rho ρ
23-R01 三期有效信号数 ( 4 , 4 , 4 ) (4,4,4) ( 4 , 4 , 4 ) ( 3 , 4 , 4 ) (3,4,4) ( 3 , 4 , 4 ) ( 0.5 , N a N , − 1 ) (0.5,\mathrm{NaN},-1) ( 0.5 , NaN , − 1 ) − 0.25 -0.25 − 0.25 t = − 1 / 3 t=-1/3 t = − 1/3
23-R03 有限VIF为 1 + 2 ∑ j = 1 2 ( 1 − j / 120 ) ρ j ( 1 − j / 3 ) 1+2\sum_{j=1}^{2}(1-j/120)\rho^j(1-j/3) 1 + 2 ∑ j = 1 2 ( 1 − j /120 ) ρ j ( 1 − j /3 ) 120 / V I F = 46.1978 120/\mathrm{VIF}=46.1978 120/ VIF = 46.1978 − 0.5 -0.5 − 0.5
23-R02 原始 FM 斜率 ± 0.02 \pm0.02 ± 0.02 ± 0.02236 \pm0.02236 ± 0.02236 z / N z/N z / N 5 \sqrt5 5 ± 0.05 \pm0.05 ± 0.05 ( 0.3 , 0 ) (0.3,0) ( 0.3 , 0 ) 10 / 7 10/7 10/7 ( 3 / 7 , 0 ) (3/7,0) ( 3/7 , 0 ) 3 / 7 3/7 3/7
23-P01 参考实现
import numpy as np
import pandas as pd
from quant_course.factor_research import bucket_returns, lead_return
def five_bucket_table (signal: pd.DataFrame, returns: pd.DataFrame ) -> pd.Series:
table = bucket_returns(signal, lead_return(returns, 1 ), 5 ).dropna()
return table.mean()
rng = np.random.default_rng(11 )
idx = pd.period_range("2010-01" , periods=120 , freq="M" )
cols = [f"S{i:03d} " for i in range (200 )]
signal = pd.DataFrame(rng.standard_normal((120 , 200 )), index=idx, columns=cols)
returns = 0.004 * signal.shift(1 ) + pd.DataFrame(0.08 * rng.standard_normal((120 , 200 )), index=idx, columns=cols)
signal.iloc[5 , :20 ] = np.nan
signal.iloc[7 ] = np.round (signal.iloc[7 ], 0 )
mean = five_bucket_table(signal, returns)
assert mean.loc[5 ] > mean.loc[1 ] and mean["LS" ] > 0
assert np.all (np.diff(mean.loc[[1 , 2 , 3 , 4 , 5 ]].to_numpy()) > -0.0015 )
print (mean.round (5 ).to_dict())
23-P02 参考实现 :见第 12 节错误 1 的代码,把混合相关与逐日 IC 一起输出,并把 2 * level 的系数改为 0 验证两者都接近 0。
23-P03 参考实现
import numpy as np
from scipy import stats
rng = np.random.default_rng(13 )
months, names, h, rho, worlds = 120 , 100 , 3 , 0.85 , 400
naive, nw, non = [], [], []
for _ in range (worlds):
total = months + h
z = np.empty((total, names)); z[0 ] = rng.standard_normal(names)
for t in range (1 , total):
z[t] = rho * z[t - 1 ] + np.sqrt(1 - rho**2 ) * rng.standard_normal(names)
r = 0.08 * rng.standard_normal((total, names))
label = sum (r[k:k + months] for k in range (1 , h + 1 ))
zs = z[:months] - z[:months].mean(axis=1 , keepdims=True ); ls = label - label.mean(axis=1 , keepdims=True )
ic = (zs * ls).sum (axis=1 ) / np.sqrt((zs**2 ).sum (axis=1 ) * (ls**2 ).sum (axis=1 ))
naive.append(ic.mean() / (ic.std(ddof=1 ) / np.sqrt(months)))
d = ic - ic.mean(); lrv = d @ d / months + 2 * sum ((1 - j / h) * (d[j:] @ d[:-j]) / months for j in range (1 , h))
nw.append(ic.mean() / np.sqrt(lrv / months))
sub = ic[::h]; non.append(sub.mean() / (sub.std(ddof=1 ) / np.sqrt(len (sub))))
reject = lambda a, c=1.96 : float ((np.abs (a) > c).mean())
assert reject(naive) > 0.15 and reject(nw) > reject(non) and reject(non, stats.t.ppf(0.975 , 39 )) < 0.09
print (reject(naive), reject(nw), reject(non, stats.t.ppf(0.975 , 39 )))
23-C01 由 4 节,E [ y ∣ z ] = μ y + I C σ y z \mathbb E[y\mid z]=\mu_y+\mathrm{IC}\sigma_yz E [ y ∣ z ] = μ y + IC σ y z z > c q z>c_q z > c q Pr = 1 / q \Pr=1/q Pr = 1/ q E [ z ∣ z > c q ] = ∫ c q ∞ z φ ( z ) d z / ( 1 / q ) = q φ ( c q ) \mathbb E[z\mid z>c_q]=\int_{c_q}^{\infty}z\varphi(z)dz\big/(1/q)=q\,\varphi(c_q) E [ z ∣ z > c q ] = ∫ c q ∞ z φ ( z ) d z / ( 1/ q ) = q φ ( c q ) ∫ c ∞ z φ ( z ) d z = φ ( c ) \int_c^\infty z\varphi(z)dz=\varphi(c) ∫ c ∞ z φ ( z ) d z = φ ( c ) E [ z ∣ z < − c q ] = − q φ ( c q ) \mathbb E[z\mid z<-c_q]=-q\varphi(c_q) E [ z ∣ z < − c q ] = − q φ ( c q ) = 2 I C σ y q φ ( c q ) =2\,\mathrm{IC}\sigma_yq\varphi(c_q) = 2 IC σ y q φ ( c q ) q φ ( c q ) q\varphi(c_q) q φ ( c q ) q = 3 q=3 q = 3 c = 0.4307 c=0.4307 c = 0.4307 φ = 0.3636 \varphi=0.3636 φ = 0.3636 1.091 1.091 1.091 q = 5 q=5 q = 5 c = 0.8416 c=0.8416 c = 0.8416 φ = 0.2800 \varphi=0.2800 φ = 0.2800 1.400 1.400 1.400 q = 10 q=10 q = 10 c = 1.2816 c=1.2816 c = 1.2816 φ = 0.1755 \varphi=0.1755 φ = 0.1755 1.755 1.755 1.755 q = 20 q=20 q = 20 c = 1.6449 c=1.6449 c = 1.6449 φ = 0.1031 \varphi=0.1031 φ = 0.1031 2.063 2.063 2.063 q q q N / q N/q N / q ≈ σ y / N / q \approx\sigma_y/\sqrt{N/q} ≈ σ y / N / q σ y 2 ( 1 − I C 2 ) \sigma_y^2(1-\mathrm{IC}^2) σ y 2 ( 1 − IC 2 ) N = 300 , q = 20 N=300,q=20 N = 300 , q = 20 0.08 / 15 = 2.1 % 0.08/\sqrt{15}=2.1\% 0.08/ 15 = 2.1% q q q
23-C02(评分依据与参考) 参考列:date(月末 signal_time)、security_id(永久标识)、book_equity、market_cap(取各自 available_at ≤ signal_time 的最新版本,第13章 select_pit_vintage)、b_m(账面/市值,权益 ≤0 置 NaN 并写 reason)、industry(signal_time 时已知的分类)、rank_pct(日内,行业内另一列)、bucket、label_1m、label_3m(标注区间)。缺失:权益非正、市值缺失,保留为 NaN 不填 0;并列:平均名次。三个反假象检验:(1) 把 available_at 推迟一个月,IC 是否消失(时间检验);(2) 行业内排序后 IC 是否仍为正(行业效应检验);(3) 去掉最大 5% 市值的资产后 IC 是否仍为正(规模集中检验);另可用置换检验。评分按原稿四项。
19. 进一步阅读
Must Know:Petersen(2005 NBER 工作稿)摘要与引言,再读式 (8)(9) 所在的小节,理解 FM 标准误假定什么;用途:知道什么时候 FM 的 t t t
Should Know:Jegadeesh–Titman(1993)§I,理解重叠持有组合与换手;第25章详读。
Should Know:本课程第22章第6节的多重检验与第15章的 HAC。
Advanced:Fama–MacBeth(1973)原文、Newey–West(1987)原文、Grinold–Kahn 关于 IC 与基本法则的章节;本章未读这些文献,如需核对符号与结论请先取得文本。
Optional:任何一份公开的因子研究报告,练习找出“研究表”的每一列在什么时点可得。
20. 参考文献
引用键与读取范围见 source_notes.md 。
CH23_PETERSEN2005:Petersen, M. A. (2005/2006). “Estimating Standard Errors in Finance Panel Data Sets: Comparing Approaches.” NBER WP 11280。支持第 5、6.6 节关于 Fama–MacBeth 估计与标准误;RFS 2009 终稿未读。
CH23_JT1993:Jegadeesh, N., Titman, S. (1993). “Returns to Buying Winners and Selling Losers.” Journal of Finance 48(1),支持重叠持有的说明。
CH23_SCIPY_RANKDATA:SciPy 1.18.1 scipy.stats.rankdata 文档,支持平均名次定义。
FRENCH:Kenneth R. French Data Library,10 Industry Portfolios(冻结快照)。