第 16 章/ 45
时间序列 I:从自相关到 ARIMA(Time Series I: Dependence and ARIMA)
主线:先说明序列在时间上怎样依赖,再估计只使用过去信息的模型,并用严格按时间推进的预测检验它。
1. 本章目标
本章结束时,你应能完成五件事:
把带频率的时间索引作为数据的一部分;识别缺月、乱序和缺失值,拒绝把时间压成没有间隔的行号。
从有限均值、方差和自协方差写出弱平稳条件,并说明它与严格平稳、白噪声和独立同分布的关系。
从递推式 X t = c + ϕ X t − 1 + ε t X_t=c+\phi X_{t-1}+\varepsilon_t X t = c + ϕ X t − 1 + ε t
结合滞后算子解释 AR、MA、ARMA、ARIMA;知道 ACF/PACF 是辨认候选模型的线索,不是自动选模器。
将模型阶数和参数选择限制在训练窗口,在每个预测起点只看该点以前的观测,并与朴素基准比较。
数学单位统一写清:月度收益以小数表示,0.01 表示该月收益 1%;均值和预测单位也是每月收益小数,方差单位是收益小数的平方;ACF、PACF 是无量纲数;滞后 k k k k k k k k k
2. 为什么 Quant 需要它
时间序列模型把“最近的值是否包含关于下一期的信息”变成可以陈述和检验的问题。量化工作中,这一步常发生在数据清理之后、回归或策略测试之前:我们先选定目标量(价格、收益、利差或波动代理),再描述它怎样依赖自己的历史,最后判断这种关系能否在预测时点成立。
把日、月或季度数据只存成一列数字会丢掉观测间隔。若一只资产缺了 2024 年 3 月,直接 dropna() 后把 2 月和 4 月视作相邻一步,AR(1) 就不再表示“一月滞后”。若把累计价格水平当作平稳收益建模,趋势会制造看似很强的相关。若在整段数据上先选阶数、再声称后半段是样本外预测,未来已经参与了研究决策。
本章沿一条完整链条推进:定义观察时钟 → 计算自协方差和相关 → 用低阶模型表达依赖 → 用训练数据估计 → 检查模型留下什么 → 逐期向前预测 → 和朴素基准比较。时间索引并非装饰;它决定滞后和预测目标是什么。
3. 直觉
想象两只“月度收益机器”。它们长期平均都给出 0.5% 的月收益,单月波动的长期标准差都是 4%,但第一台每个月重新抽一张独立的签;第二台会把上个月偏离长期均值的部分保留 70%。单看平均收益和波动,两台机器难以区分;如果第二台上个月高于平均,这个月也更可能偏高。差别在时间排列。
这类“记忆”用自相关表示。正的滞后 1 自相关表示相邻月通常同向偏离均值;负值表示相邻月倾向反向;接近零只说明线性相关小,并不排除非线性依赖、波动聚集或共同外部冲击。
还有一个常见误会:观察到的收益线条平稳地上下波动,不等于已证明数据生成机制平稳。一次结构变化、少量极端月、缓慢随机趋势,都可能让有限样本图形误导。图先提出问题,理论假设和后续检验再提供不同证据。
3.1 随机过程不是一条折线
随机过程(stochastic process)是带时间索引的一族随机变量 { X t } \{X_t\} { X t } x 1 , … , x n x_1,\ldots,x_n x 1 , … , x n
可能世界
一月收益
二月收益
三月收益
A(实际看到的路径)
1%
−1%
2%
B
−1%
2%
0%
C
0%
1%
−2%
一月这一列对应随机变量 X 1 X_1 X 1 E [ X 1 ] \mathbb E[X_1] E [ X 1 ] x ˉ \bar x x ˉ Z Z Z X t = Z X_t=Z X t = Z Z Z Z E [ Z ] \mathbb E[Z] E [ Z ]
两台收益机器的总体参数可以写在同一张表里。令 s = 0.04 s=0.04 s = 0.04 μ = 0.005 \mu=0.005 μ = 0.005
总体对象
IID 机器
AR(1) 机器,ϕ = 0.7 \phi=0.7 ϕ = 0.7
长期均值
0.005
0.005
单月方差
0.0016
0.0016
创新标准差
0.04
0.04 1 − 0.7 2 = 0.0285657 0.04\sqrt{1-0.7^2}=0.0285657 0.04 1 − 0. 7 2 = 0.0285657
滞后1协方差
0
0.7 ( 0.0016 ) = 0.00112 0.7(0.0016)=0.00112 0.7 ( 0.0016 ) = 0.00112
滞后2相关
0
0.7 2 = 0.49 0.7^2=0.49 0. 7 2 = 0.49
相同的边际均值、方差没有决定相邻两个月如何共同变化;AR 创新波动要更小,因为历史冲击也在贡献当月总波动。有限样本表中的样本数值不会精确等于这里的总体参数。
4. 数学基础
令 X t X_t X t t t t X t − k X_{t-k} X t − k k k k P t P_t P t
R t = P t P t − 1 − 1 , r t = log P t − log P t − 1 .
R_t=\frac{P_t}{P_{t-1}}-1, \qquad r_t=\log P_t-\log P_{t-1}.
R t = P t − 1 P t − 1 , r t = log P t − log P t − 1 . 若价格以欧元表示,P t P_t P t R t R_t R t r t r_t r t r t ≈ R t r_t\approx R_t r t ≈ R t
本章把日历月份写为月度 PeriodIndex。2024-02 到 2024-03 的滞后是一个月,即使两个自然月的天数不同;这不是假设 2 月和 3 月有相同日数。一个缺失的月份则是缺失观测,不能用“下一个留下来的 CSV 行”冒充一个月滞后。核心代码要求月份连续并拒绝 NaN、正负无穷和复数输入,不自动填补。
给定有限方差的平稳序列,均值、方差和自协方差为
μ = E [ X t ] , γ ( k ) = Cov ( X t , X t − k ) , ρ ( k ) = γ ( k ) γ ( 0 ) .
\mu=\mathbb{E}[X_t],\qquad \gamma(k)=\operatorname{Cov}(X_t,X_{t-k}),\qquad
\rho(k)=\frac{\gamma(k)}{\gamma(0)}.
μ = E [ X t ] , γ ( k ) = Cov ( X t , X t − k ) , ρ ( k ) = γ ( 0 ) γ ( k ) . 这里 μ \mu μ X t X_t X t γ ( k ) \gamma(k) γ ( k ) ρ ( k ) \rho(k) ρ ( k ) ρ ( 0 ) = 1 \rho(0)=1 ρ ( 0 ) = 1 X t X_t X t k = 12 k=12 k = 12
5. 正式定义
严格平稳 (strict stationarity)要求任意正整数 m m m t 1 , … , t m t_1,\ldots,t_m t 1 , … , t m h h h ( X t 1 , … , X t m ) (X_{t_1},\ldots,X_{t_m}) ( X t 1 , … , X t m ) ( X t 1 + h , … , X t m + h ) (X_{t_1+h},\ldots,X_{t_m+h}) ( X t 1 + h , … , X t m + h )
弱平稳 (weak stationarity,也称协方差平稳)要求二阶矩存在,均值不随 t t t Cov ( X t , X t − k ) \operatorname{Cov}(X_t,X_{t-k}) Cov ( X t , X t − k ) k k k t t t
白噪声 (white noise, WN)在本章采用二阶定义:E [ ε t ] = 0 \mathbb{E}[\varepsilon_t]=0 E [ ε t ] = 0 Var ( ε t ) = σ 2 < ∞ \operatorname{Var}(\varepsilon_t)=\sigma^2<\infty Var ( ε t ) = σ 2 < ∞ 独立同分布 (independent and identically distributed, IID)还要求每期彼此独立且边际分布相同。IID 零均值有限方差噪声是白噪声;仅有“相关系数接近零”不能推出 IID。若噪声联合高斯,零相关才可进一步推出独立。
自相关函数 (autocorrelation function, ACF)列出 ρ ( k ) \rho(k) ρ ( k ) k k k 偏自相关函数 (partial autocorrelation function, PACF)在控制中间滞后 X t − 1 , … , X t − k + 1 X_{t-1},\ldots,X_{t-k+1} X t − 1 , … , X t − k + 1 X t X_t X t X t − k X_{t-k} X t − k A R ( k ) \mathrm{AR}(k) AR ( k )
若观测值为 x 1 , … , x n x_1,\ldots,x_n x 1 , … , x n
γ ^ ( k ) = 1 n ∑ t = k + 1 n ( x t − x ˉ ) ( x t − k − x ˉ ) , ρ ^ ( k ) = γ ^ ( k ) γ ^ ( 0 ) .
\hat\gamma(k)=\frac{1}{n}\sum_{t=k+1}^{n}(x_t-\bar x)(x_{t-k}-\bar x),\qquad
\hat\rho(k)=\frac{\hat\gamma(k)}{\hat\gamma(0)}.
γ ^ ( k ) = n 1 t = k + 1 ∑ n ( x t − x ˉ ) ( x t − k − x ˉ ) , ρ ^ ( k ) = γ ^ ( 0 ) γ ^ ( k ) . 这里 n n n k k k x ˉ \bar x x ˉ n n n n − k n-k n − k x t x_t x t k k k x t − k x_{t-k} x t − k
自回归模型 (autoregressive model, A R ( p ) \mathrm{AR}(p) AR ( p ) 移动平均模型 (moving average model, M A ( q ) \mathrm{MA}(q) MA ( q ) q q q 自回归移动平均模型 (autoregressive moving average, A R M A ( p , q ) \mathrm{ARMA}(p,q) ARMA ( p , q ) 差分自回归移动平均模型 (autoregressive integrated moving average, A R I M A ( p , d , q ) \mathrm{ARIMA}(p,d,q) ARIMA ( p , d , q ) d d d
滞后算子 (lag operator)L L L L X t = X t − 1 LX_t=X_{t-1} L X t = X t − 1 L k X t = X t − k L^kX_t=X_{t-k} L k X t = X t − k ∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1 ∣ θ ∣ < 1 |\theta|<1 ∣ θ ∣ < 1
预测区间 (prediction interval)给定模型与信息集后,为未来单个观测量提供不确定性范围;它比“条件均值的置信区间”更宽,因为未来创新本身也会波动。若使用正态误差、参数当作已知且预测方差为 V h V_h V h
X ^ T + h ∣ T ± z 1 − α / 2 V h .
\hat X_{T+h\mid T}\pm z_{1-\alpha/2}\sqrt{V_h}.
X ^ T + h ∣ T ± z 1 − α /2 V h . 其中 X ^ T + h ∣ T \hat X_{T+h\mid T} X ^ T + h ∣ T V h V_h V h z 1 − α / 2 z_{1-\alpha/2} z 1 − α /2
6. 推导
6.1 AR(1):从递推式到稳态矩
先写带常数项的 AR(1):
X t = c + ϕ X t − 1 + ε t ,
X_t=c+\phi X_{t-1}+\varepsilon_t,
X t = c + ϕ X t − 1 + ε t , c c c X t X_t X t ϕ \phi ϕ ε t \varepsilon_t ε t X t X_t X t σ 2 \sigma^2 σ 2
μ = c + ϕ μ ⟹ μ = c 1 − ϕ ,
\mu=c+\phi\mu \quad\Longrightarrow\quad \mu=\frac{c}{1-\phi},
μ = c + ϕ μ ⟹ μ = 1 − ϕ c , 在因果平稳条件 ∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1 Y t = X t − μ Y_t=X_t-\mu Y t = X t − μ
Y t = ϕ Y t − 1 + ε t .
Y_t=\phi Y_{t-1}+\varepsilon_t.
Y t = ϕ Y t − 1 + ε t . 中心化的目的是把长期位置与围绕它的波动分开;此处 E [ Y t ] = 0 \mathbb{E}[Y_t]=0 E [ Y t ] = 0 Y t − 1 Y_{t-1} Y t − 1
γ ( 0 ) = E [ Y t 2 ] = ϕ 2 E [ Y t − 1 2 ] + 2 ϕ E [ Y t − 1 ε t ] + E [ ε t 2 ] = ϕ 2 γ ( 0 ) + σ 2 , γ ( 0 ) = σ 2 1 − ϕ 2 .
\begin{aligned}
\gamma(0)&=\mathbb{E}[Y_t^2]
=\phi^2\mathbb{E}[Y_{t-1}^2]+2\phi\mathbb{E}[Y_{t-1}\varepsilon_t]+\mathbb{E}[\varepsilon_t^2]\\
&=\phi^2\gamma(0)+\sigma^2,
\end{aligned}
\qquad
\gamma(0)=\frac{\sigma^2}{1-\phi^2}.
γ ( 0 ) = E [ Y t 2 ] = ϕ 2 E [ Y t − 1 2 ] + 2 ϕ E [ Y t − 1 ε t ] + E [ ε t 2 ] = ϕ 2 γ ( 0 ) + σ 2 , γ ( 0 ) = 1 − ϕ 2 σ 2 . 在本章的因果设定中,创新是当期新冲击,且与过去不相关。要让冲击权重 1 , ϕ , ϕ 2 , … 1,\phi,\phi^2,\ldots 1 , ϕ , ϕ 2 , … ∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1 σ 2 / ( 1 − ϕ 2 ) \sigma^2/(1-\phi^2) σ 2 / ( 1 − ϕ 2 ) ∣ ϕ ∣ ≥ 1 |\phi|\ge1 ∣ ϕ ∣ ≥ 1
再把 Y t = ϕ Y t − 1 + ε t Y_t=\phi Y_{t-1}+\varepsilon_t Y t = ϕ Y t − 1 + ε t Y t − k Y_{t-k} Y t − k k ≥ 1 k\ge1 k ≥ 1 Y t − k Y_{t-k} Y t − k
γ ( k ) = ϕ γ ( k − 1 ) .
\gamma(k)=\phi\gamma(k-1).
γ ( k ) = ϕ γ ( k − 1 ) . 反复应用递推关系,得到 γ ( k ) = ϕ k γ ( 0 ) \gamma(k)=\phi^k\gamma(0) γ ( k ) = ϕ k γ ( 0 )
ρ ( k ) = γ ( k ) γ ( 0 ) = ϕ k , k ≥ 0.
\rho(k)=\frac{\gamma(k)}{\gamma(0)}=\phi^k,\qquad k\ge0.
ρ ( k ) = γ ( 0 ) γ ( k ) = ϕ k , k ≥ 0. 若 ϕ = 0.7 \phi=0.7 ϕ = 0.7 0.7 , 0.49 , 0.343 , … 0.7,0.49,0.343,\ldots 0.7 , 0.49 , 0.343 , … ϕ < 0 \phi<0 ϕ < 0 ϕ \phi ϕ
当 ∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1
Y t = ε t + ϕ ε t − 1 + ϕ 2 ε t − 2 + ⋯ .
Y_t=\varepsilon_t+\phi\varepsilon_{t-1}+\phi^2\varepsilon_{t-2}+\cdots.
Y t = ε t + ϕ ε t − 1 + ϕ 2 ε t − 2 + ⋯ . 有限展开的余项为 ϕ m Y t − m \phi^mY_{t-m} ϕ m Y t − m m m m ϕ j \phi^j ϕ j
6.1.1 稳定递推与平稳初始化是两件事
∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1 X 0 X_0 X 0 h h h c = ( 1 − ϕ ) μ c=(1-\phi)\mu c = ( 1 − ϕ ) μ
X h = μ + ϕ h ( X 0 − μ ) + ∑ j = 1 h ϕ h − j ε j .
X_h=\mu+\phi^h(X_0-\mu)+\sum_{j=1}^{h}\phi^{h-j}\varepsilon_j.
X h = μ + ϕ h ( X 0 − μ ) + j = 1 ∑ h ϕ h − j ε j . 在未来创新与 X 0 X_0 X 0
E [ X h ] = μ + ϕ h ( E [ X 0 ] − μ ) , Var ( X h ) = ϕ 2 h Var ( X 0 ) + σ 2 ∑ j = 0 h − 1 ϕ 2 j .
\mathbb E[X_h]=\mu+\phi^h(\mathbb E[X_0]-\mu),\qquad
\operatorname{Var}(X_h)=\phi^{2h}\operatorname{Var}(X_0)+\sigma^2\sum_{j=0}^{h-1}\phi^{2j}.
E [ X h ] = μ + ϕ h ( E [ X 0 ] − μ ) , Var ( X h ) = ϕ 2 h Var ( X 0 ) + σ 2 j = 0 ∑ h − 1 ϕ 2 j . 第一项来自起点,第二项来自已经进入系统的创新;固定起点的方差为零。取 μ = 0.005 , ϕ = 0.5 , σ = 0.06 \mu=0.005,\phi=0.5,\sigma=0.06 μ = 0.005 , ϕ = 0.5 , σ = 0.06 X 0 = μ X_0=\mu X 0 = μ
h h h 均值
有限起点方差
平稳初始化方差
0
0.005
0
0.0048
1
0.005
0.0036
0.0048
2
0.005
0.0045
0.0048
3
0.005
0.004725
0.0048
均值相同却方差随时间改变,故左侧初始过程不是弱平稳。若 X 0 X_0 X 0 μ \mu μ σ 2 / ( 1 − ϕ 2 ) \sigma^2/(1-\phi^2) σ 2 / ( 1 − ϕ 2 ) X 0 ∼ N ( μ , σ 2 / ( 1 − ϕ 2 ) ) X_0\sim N(\mu,\sigma^2/(1-\phi^2)) X 0 ∼ N ( μ , σ 2 / ( 1 − ϕ 2 ))
6.2 多步预测误差怎样变宽
为推导条件预测均值和条件误差方差,假设未来创新彼此独立、同分布,且整个未来创新集合与预测起点已知信息独立;创新均值为零、方差为 σ 2 \sigma^2 σ 2 F T \mathcal F_T F T T T T
X ^ T + 1 ∣ T = μ + ϕ ( X T − μ ) .
\hat X_{T+1\mid T}=\mu+\phi(X_T-\mu).
X ^ T + 1 ∣ T = μ + ϕ ( X T − μ ) . 右边的 X T X_T X T X T + 1 X_{T+1} X T + 1
X ^ T + 2 ∣ T = μ + ϕ ( X ^ T + 1 ∣ T − μ ) = μ + ϕ 2 ( X T − μ ) .
\hat X_{T+2\mid T}=\mu+\phi(\hat X_{T+1\mid T}-\mu)=\mu+\phi^2(X_T-\mu).
X ^ T + 2 ∣ T = μ + ϕ ( X ^ T + 1 ∣ T − μ ) = μ + ϕ 2 ( X T − μ ) . 推广到 h h h μ + ϕ h ( X T − μ ) \mu+\phi^h(X_T-\mu) μ + ϕ h ( X T − μ )
X T + h − X ^ T + h ∣ T = ε T + h + ϕ ε T + h − 1 + ⋯ + ϕ h − 1 ε T + 1 .
X_{T+h}-\hat X_{T+h\mid T}=\varepsilon_{T+h}+\phi\varepsilon_{T+h-1}+\cdots+\phi^{h-1}\varepsilon_{T+1}.
X T + h − X ^ T + h ∣ T = ε T + h + ϕ ε T + h − 1 + ⋯ + ϕ h − 1 ε T + 1 . 在这些假设下,给定 F T \mathcal F_T F T σ 2 \sigma^2 σ 2
V h = σ 2 ∑ j = 0 h − 1 ϕ 2 j = σ 2 1 − ϕ 2 h 1 − ϕ 2 .
V_h=\sigma^2\sum_{j=0}^{h-1}\phi^{2j}
=\sigma^2\frac{1-\phi^{2h}}{1-\phi^2}.
V h = σ 2 j = 0 ∑ h − 1 ϕ 2 j = σ 2 1 − ϕ 2 1 − ϕ 2 h . 这里 V h V_h V h h h h h → ∞ h\to\infty h → ∞ σ 2 / ( 1 − ϕ 2 ) \sigma^2/(1-\phi^2) σ 2 / ( 1 − ϕ 2 )
信息集怎样改变“最好预测”
条件均值是平方损失下、给定 F T \mathcal F_T F T U ∼ U n i f o r m ( 0 , 2 π ) U\sim\mathrm{Uniform}(0,2\pi) U ∼ Uniform ( 0 , 2 π ) e t = cos ( 2 t U ) e_t=\cos(2^tU) e t = cos ( 2 t U ) t = 0 , 1 , … t=0,1,\ldots t = 0 , 1 , … 1 / 2 1/2 1/2
e t + 1 = 2 e t 2 − 1.
e_{t+1}=2e_t^2-1.
e t + 1 = 2 e t 2 − 1. 给定过去的 e t e_t e t E [ e t + 1 ∣ e t ] = 2 e t 2 − 1 \mathbb E[e_{t+1}\mid e_t]=2e_t^2-1 E [ e t + 1 ∣ e t ] = 2 e t 2 − 1
6.3 MA(1)、可逆性与 ARMA
先区分两个都叫 moving average 的对象。价格滚动均值 M t = ( P t + P t − 1 + P t − 2 ) / 3 M_t=(P_t+P_{t-1}+P_{t-2})/3 M t = ( P t + P t − 1 + P t − 2 ) /3 X t = μ + ε t + θ ε t − 1 X_t=\mu+\varepsilon_t+\theta\varepsilon_{t-1} X t = μ + ε t + θ ε t − 1 ε t − 1 = 0.02 , ε t = − 0.01 \varepsilon_{t-1}=0.02,\varepsilon_t=-0.01 ε t − 1 = 0.02 , ε t = − 0.01 θ = 0.5 , μ = 0.005 \theta=0.5,\mu=0.005 θ = 0.5 , μ = 0.005 X t = 0.005 − 0.01 + 0.5 ( 0.02 ) = 0.005 X_t=0.005-0.01+0.5(0.02)=0.005 X t = 0.005 − 0.01 + 0.5 ( 0.02 ) = 0.005 100 , 103 , 102 100,103,102 100 , 103 , 102 101.6667 101.6667 101.6667
采用 X t = μ + ε t + θ ε t − 1 X_t=\mu+\varepsilon_t+\theta\varepsilon_{t-1} X t = μ + ε t + θ ε t − 1 X t − μ = ε t + θ ε t − 1 X_t-\mu=\varepsilon_t+\theta\varepsilon_{t-1} X t − μ = ε t + θ ε t − 1 X t − 1 − μ = ε t − 1 + θ ε t − 2 X_{t-1}-\mu=\varepsilon_{t-1}+\theta\varepsilon_{t-2} X t − 1 − μ = ε t − 1 + θ ε t − 2 σ 2 \sigma^2 σ 2
γ ( 0 ) = σ 2 ( 1 + θ 2 ) , γ ( 1 ) = θ σ 2 , γ ( k ) = 0 ( k ≥ 2 ) , ρ ( 1 ) = θ 1 + θ 2 .
\gamma(0)=\sigma^2(1+\theta^2),\qquad
\gamma(1)=\theta\sigma^2,\qquad
\gamma(k)=0\;(k\ge2),\qquad
\rho(1)=\frac{\theta}{1+\theta^2}.
γ ( 0 ) = σ 2 ( 1 + θ 2 ) , γ ( 1 ) = θ σ 2 , γ ( k ) = 0 ( k ≥ 2 ) , ρ ( 1 ) = 1 + θ 2 θ . 滞后 0 的方差把两项各自的方差相加,因为 ε t \varepsilon_t ε t ε t − 1 \varepsilon_{t-1} ε t − 1 ε t − 1 \varepsilon_{t-1} ε t − 1 θ \theta θ θ σ 2 \theta\sigma^2 θ σ 2
MA(1) 的 ACF 在理论上从滞后 2 起截为零,PACF 一般逐渐衰减。若 ∣ θ ∣ < 1 |\theta|<1 ∣ θ ∣ < 1
ε t = ( 1 + θ L ) − 1 ( X t − μ ) = ( 1 − θ L + θ 2 L 2 − ⋯ ) ( X t − μ ) ,
\varepsilon_t=(1+\theta L)^{-1}(X_t-\mu)
=(1-\theta L+\theta^2L^2-\cdots)(X_t-\mu),
ε t = ( 1 + θ L ) − 1 ( X t − μ ) = ( 1 − θ L + θ 2 L 2 − ⋯ ) ( X t − μ ) , 因为 ( 1 + θ L ) − 1 = 1 − θ L + θ 2 L 2 − ⋯ (1+\theta L)^{-1}=1-\theta L+\theta^2L^2-\cdots ( 1 + θ L ) − 1 = 1 − θ L + θ 2 L 2 − ⋯ ∣ θ ∣ < 1 |\theta|<1 ∣ θ ∣ < 1 θ \theta θ
A R ( p ) \mathrm{AR}(p) AR ( p ) p p p M A ( q ) \mathrm{MA}(q) MA ( q ) q q q
6.4 差分与过度差分
一阶差分定义为 Δ X t = X t − X t − 1 = ( 1 − L ) X t \Delta X_t=X_t-X_{t-1}=(1-L)X_t Δ X t = X t − X t − 1 = ( 1 − L ) X t A R I M A ( p , d , q ) \mathrm{ARIMA}(p,d,q) ARIMA ( p , d , q ) Δ d X t \Delta^d X_t Δ d X t A R M A ( p , q ) \mathrm{ARMA}(p,q) ARMA ( p , q ) X t X_t X t Δ X t \Delta X_t Δ X t X t = log P t X_t=\log P_t X t = log P t Δ X t \Delta X_t Δ X t X t X_t X t
从输入到输出看,一阶差分拿本月水平减去上月水平,并丢掉第一个无法配对的月份。例如月末价格 [ 100 , 101 , 103 , 102 ] [100,101,103,102] [ 100 , 101 , 103 , 102 ] [ 1 , 2 , − 1 ] [1,2,-1] [ 1 , 2 , − 1 ]
差分可能移除随机趋势,也会牺牲样本首行并改变问题。若原始月度序列本来就是白噪声 X t = ε t X_t=\varepsilon_t X t = ε t
Δ X t = ε t − ε t − 1 .
\Delta X_t=\varepsilon_t-\varepsilon_{t-1}.
Δ X t = ε t − ε t − 1 . 它是 θ = − 1 \theta=-1 θ = − 1 2 σ 2 2\sigma^2 2 σ 2 − σ 2 -\sigma^2 − σ 2 − 1 / 2 -1/2 − 1/2 d d d
6.5 差分预测怎样回到原对象
若模型预测 D t = Δ X t D_t=\Delta X_t D t = Δ X t X T + h = X T + ∑ j = 1 h D T + j X_{T+h}=X_T+\sum_{j=1}^{h}D_{T+j} X T + h = X T + ∑ j = 1 h D T + j
X ^ T + h ∣ T = X T + ∑ j = 1 h D ^ T + j ∣ T .
\hat X_{T+h\mid T}=X_T+\sum_{j=1}^{h}\hat D_{T+j\mid T}.
X ^ T + h ∣ T = X T + j = 1 ∑ h D ^ T + j ∣ T . 最后已知价格为 102 欧元/股,下一月和再下一月变化预测为 1、2 欧元/股,水平预测分别为 103、105。若两期变化预测误差 v 1 , v 2 v_1,v_2 v 1 , v 2 v 1 + v 2 v_1+v_2 v 1 + v 2 4 + 4 + 2 ( 1 ) = 10 4+4+2(1)=10 4 + 4 + 2 ( 1 ) = 10
对数价格还多一层:若 X = log P X=\log P X = log P m m m e m e^m e m E [ P ∣ F T ] \mathbb E[P\mid\mathcal F_T] E [ P ∣ F T ] V V V e m + V / 2 e^{m+V/2} e m + V /2 e m e^m e m forecast_arima 输入什么序列就返回该序列的未来预测;若给原水平并设 d = 1 d=1 d = 1
6.6 一个滞后到底有多长
ACF/PACF 的总体对象见第5节;样本估计用来提出候选,而样本外误差才回答候选在下一段预测怎样。两者都依赖有效观测时钟:月份标签属于日历时钟,交易日序号属于交易时钟,逐笔成交序号属于事件时钟。逐笔 AR(1) 的一步是下一笔成交,可能相隔毫秒或数小时,不能直接称作固定一分钟预测。若需要一分钟预测,应先定义一分钟网格和无成交区间的取值含义。
缺月例中,二月到四月相隔两步。给定二月状态,在同一 AR(1) 模型中四月条件均值的偏离乘 ϕ 2 \phi^2 ϕ 2 σ 2 ( 1 + ϕ 2 ) \sigma^2(1+\phi^2) σ 2 ( 1 + ϕ 2 ) ϕ \phi ϕ σ 2 \sigma^2 σ 2
7. 金融解释
对资产价格 P t P_t P t P t P_t P t P t − 1 P_{t-1} P t − 1 R t R_t R t
如果月收益符合稳定 AR(1),正 ϕ \phi ϕ ϕ \phi ϕ
收益线性自相关和波动聚集也要分开。即便收益 ACF 接近零,∣ R t ∣ |R_t| ∣ R t ∣ R t 2 R_t^2 R t 2
月度信息的可交易时间不能从月份标签直接推断。若 R t R_t R t available_at、信号 signal_time、可下单的 trade_time 和目标 return interval。French 月度组合文件没有逐月历史发布时间,故它只用于描述历史发布序列,不是点时训练集。
8. Numerical Example
完整例题:AR条件均值、递归代码与区间
以下均为教学构造数值,不是市场观察。设
X t = 0.005 + 0.5 ( X t − 1 − 0.005 ) + ε t , ε t ∼ I I D N ( 0 , 0.06 2 ) .
X_t=0.005+0.5(X_{t-1}-0.005)+\varepsilon_t,
\qquad \varepsilon_t\overset{\mathrm{IID}}{\sim}N(0,0.06^2).
X t = 0.005 + 0.5 ( X t − 1 − 0.005 ) + ε t , ε t ∼ IID N ( 0 , 0.0 6 2 ) . 此例额外假定创新相互独立、正态且与过去信息独立,因而下面的线性预测也是条件均值;只给白噪声二阶条件不足以保证这一点。长期月均收益为 0.005 0.005 0.005 ϕ = 0.5 \phi=0.5 ϕ = 0.5
Var ( X t ) = 0.06 2 1 − 0.5 2 = 0.0036 0.75 = 0.0048 ,
\operatorname{Var}(X_t)=\frac{0.06^2}{1-0.5^2}
=\frac{0.0036}{0.75}=0.0048,
Var ( X t ) = 1 − 0. 5 2 0.0 6 2 = 0.75 0.0036 = 0.0048 , 所以无条件标准差约为 0.0048 = 0.06928 \sqrt{0.0048}=0.06928 0.0048 = 0.06928 γ ( 0 ) = 0.0048 \gamma(0)=0.0048 γ ( 0 ) = 0.0048 γ ( 1 ) = 0.0024 \gamma(1)=0.0024 γ ( 1 ) = 0.0024 γ ( 2 ) = 0.0012 \gamma(2)=0.0012 γ ( 2 ) = 0.0012 1 , 0.5 , 0.25 1,0.5,0.25 1 , 0.5 , 0.25 γ \gamma γ
若本月收益为 X T = 0.04 X_T=0.04 X T = 0.04
X ^ T + 1 ∣ T = 0.005 + 0.5 ( 0.04 − 0.005 ) = 0.0225.
\hat X_{T+1\mid T}=0.005+0.5(0.04-0.005)=0.0225.
X ^ T + 1 ∣ T = 0.005 + 0.5 ( 0.04 − 0.005 ) = 0.0225. 注意结果是 2.25%,不是将 4% 直接乘以 0.5 得 2%。再往后一个月,X ^ T + 2 ∣ T = 0.005 + 0.5 2 ( 0.035 ) = 0.01375 \hat X_{T+2\mid T}=0.005+0.5^2(0.035)=0.01375 X ^ T + 2 ∣ T = 0.005 + 0. 5 2 ( 0.035 ) = 0.01375 μ \mu μ ϕ \phi ϕ
月份
已观察月收益
角色
2025-01
0.0100(1.00%)
历史观测
2025-02
0.0300(3.00%)
历史观测
2025-03
0.0400(4.00%)
预测起点 T T T
输入是最后一条已观察值 X T = 0.04 X_T=0.04 X T = 0.04 0.005 + 0.5 ( 0.04 − 0.005 ) = 0.0225 0.005+0.5(0.04-0.005)=0.0225 0.005 + 0.5 ( 0.04 − 0.005 ) = 0.0225 0.005 + 0.5 ( 0.0225 − 0.005 ) = 0.01375 0.005+0.5(0.0225-0.005)=0.01375 0.005 + 0.5 ( 0.0225 − 0.005 ) = 0.01375
import numpy as np
import pandas as pd
observed = pd.Series(
[0.01 , 0.03 , 0.04 ],
index=pd.PeriodIndex(["2025-01" , "2025-02" , "2025-03" ], freq="M" ),
name="monthly_return" ,
)
mu = 0.005
phi = 0.5
x_t = float (observed.iloc[-1 ])
forecast_april = mu + phi * (x_t - mu)
forecast_may = mu + phi * (forecast_april - mu)
print ("forecast target months:" , observed.index[-1 ] + 1 , observed.index[-1 ] + 2 )
print ("forecast means:" , forecast_april, forecast_may)
assert np.isclose(forecast_april, 0.0225 )
assert np.isclose(forecast_may, 0.01375 )
代码输出的两个数与手算一致。它只读到 2025-03;若要拟合未知 μ , ϕ \mu,\phi μ , ϕ fit_arima 一个足够长、严格截止在预测起点的训练序列。
参数已知且创新正态时,一步预测误差方差是 V 1 = 0.06 2 = 0.0036 V_1=0.06^2=0.0036 V 1 = 0.0 6 2 = 0.0036 0.0225 ± 1.96 ( 0.06 ) = [ − 0.0951 , 0.1401 ] 0.0225\pm1.96(0.06)=[-0.0951,0.1401] 0.0225 ± 1.96 ( 0.06 ) = [ − 0.0951 , 0.1401 ] [ − 9.51 % , 14.01 % ] [-9.51\%,14.01\%] [ − 9.51% , 14.01% ] V 2 = 0.06 2 ( 1 + 0.5 2 ) = 0.0045 V_2=0.06^2(1+0.5^2)=0.0045 V 2 = 0.0 6 2 ( 1 + 0. 5 2 ) = 0.0045 ϕ , μ , σ 2 \phi,\mu,\sigma^2 ϕ , μ , σ 2
另设 MA(1) 的 θ = 0.5 , σ = 0.06 \theta=0.5,\sigma=0.06 θ = 0.5 , σ = 0.06 γ ( 0 ) = 0.0036 ( 1 + 0.25 ) = 0.0045 \gamma(0)=0.0036(1+0.25)=0.0045 γ ( 0 ) = 0.0036 ( 1 + 0.25 ) = 0.0045 γ ( 1 ) = 0.5 ( 0.0036 ) = 0.0018 \gamma(1)=0.5(0.0036)=0.0018 γ ( 1 ) = 0.5 ( 0.0036 ) = 0.0018 ρ ( 1 ) = 0.4 \rho(1)=0.4 ρ ( 1 ) = 0.4 ρ ( k ) = 0 \rho(k)=0 ρ ( k ) = 0 k ≥ 2 k\ge2 k ≥ 2
最后比较两台构造收益机器:取共同均值 0.005 和边际标准差 0.04。IID 机器的所有非零滞后总体 ACF 都为 0;AR(1) 机器设 ϕ = 0.7 \phi=0.7 ϕ = 0.7 0.04 1 − 0.7 2 ≈ 0.02857 0.04\sqrt{1-0.7^2}\approx0.02857 0.04 1 − 0. 7 2 ≈ 0.02857 0.04 2 0.04^2 0.0 4 2
9. Python Implementation
本读者版的默认运行入口
从接受I3读者包根目录,按其环境说明 建立独立环境后运行:
.venv/bin/python run_notebook.py notebooks/ch16_time_series.ipynb
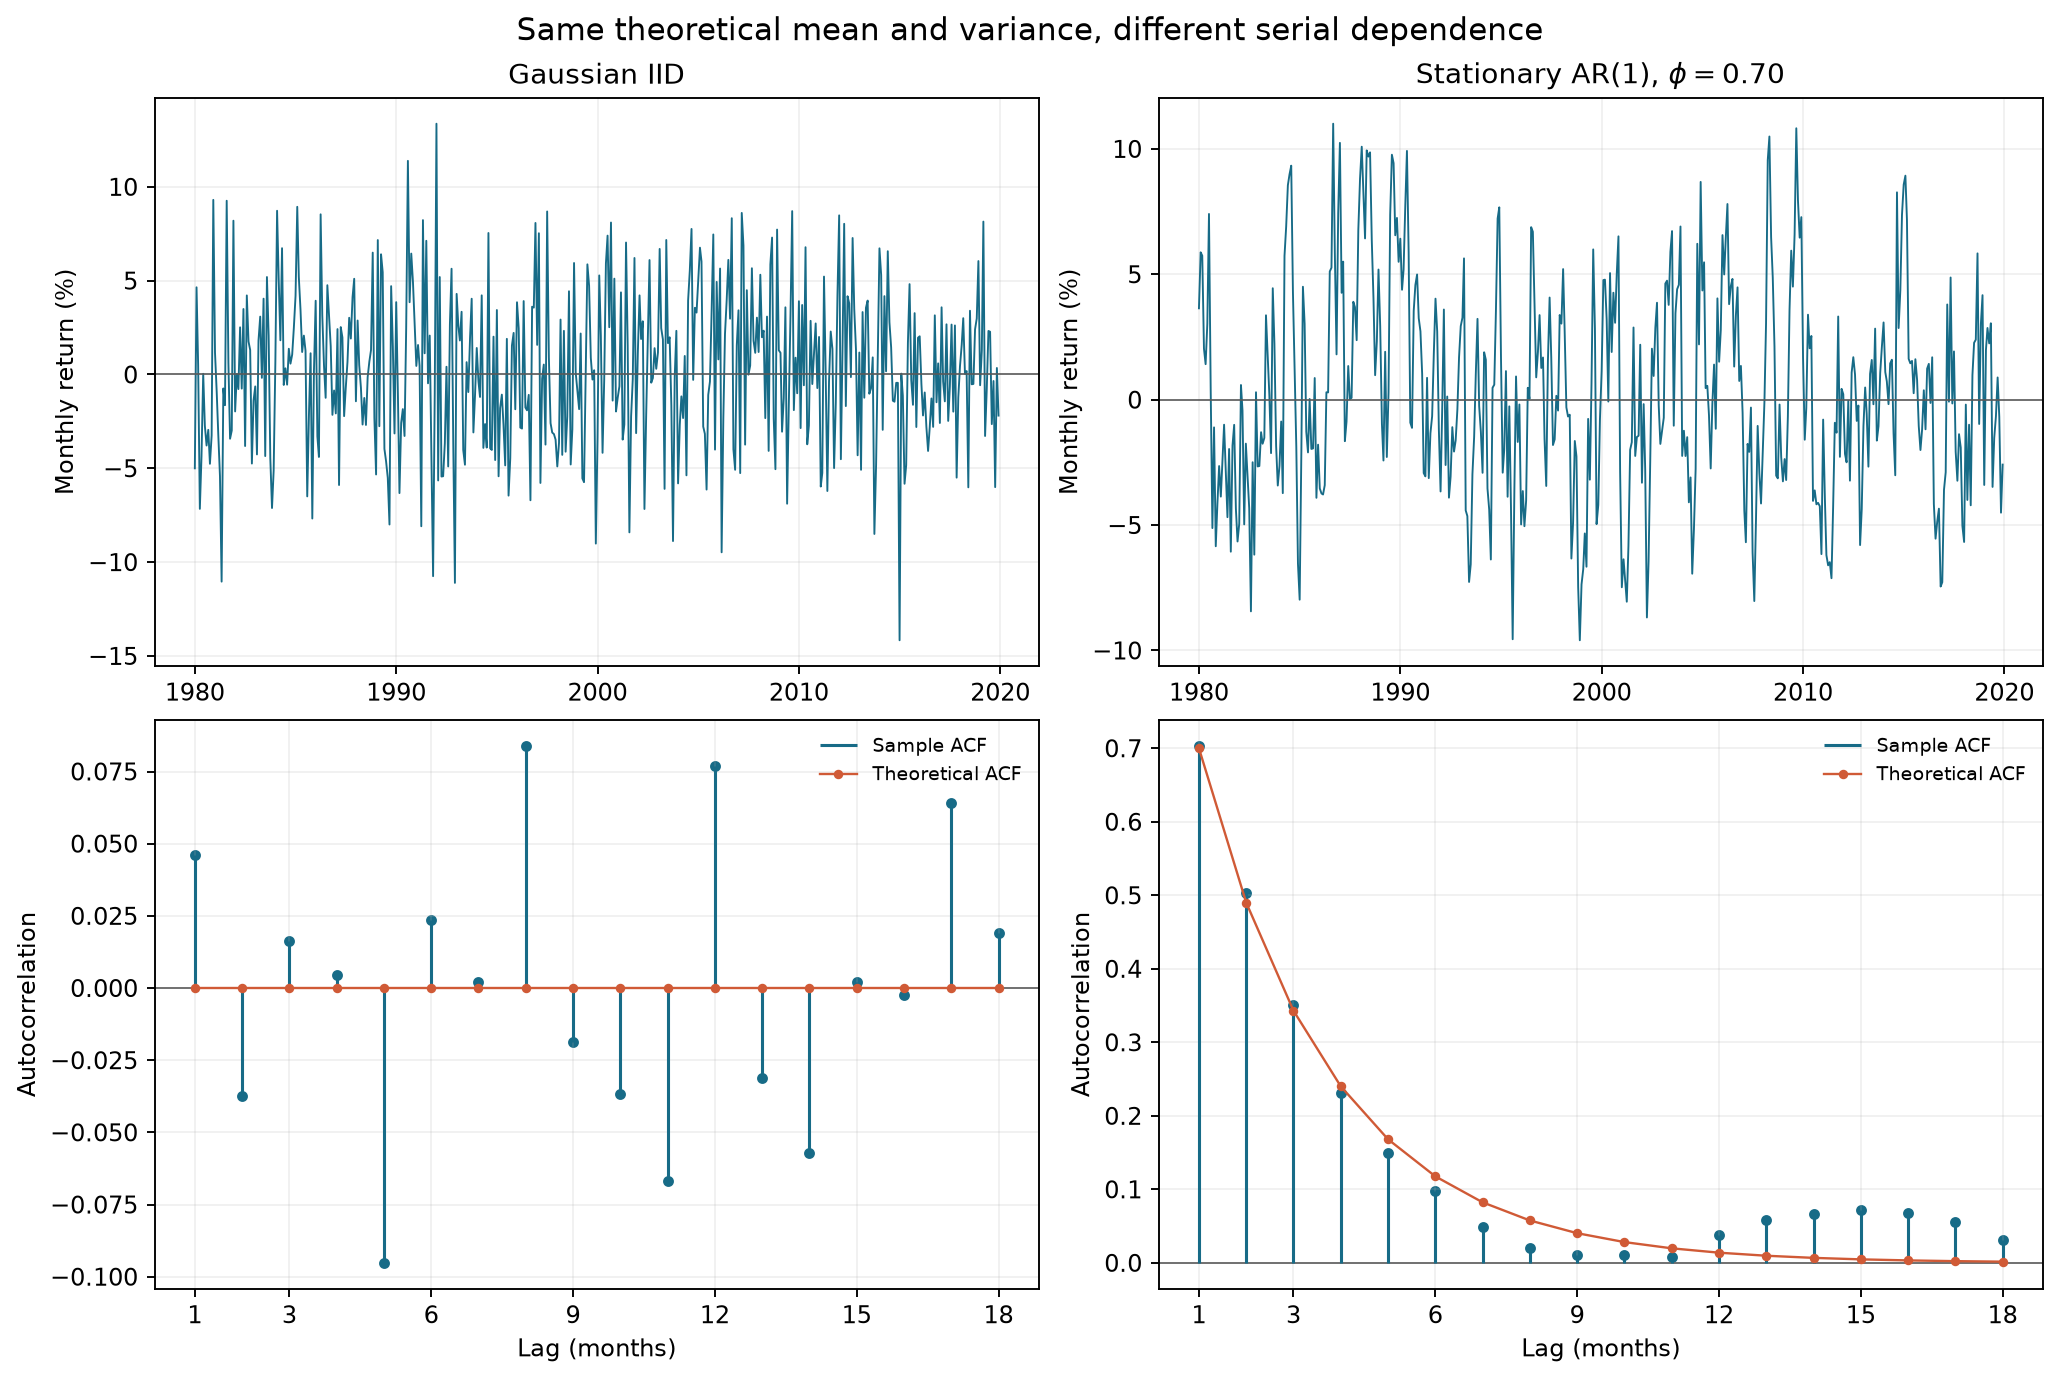
默认种子20261016构造1980-01起480个月的IID与AR(1)收益,均值0.005、边际标准差0.04、AR系数0.7。AR初值从稳态正态分布抽取,创新标准差为0.04乘以sqrt(1−0.7²)。先核理论矩与样本ACF/PACF,再以前360个月(截至2009-12)训练,三步预测从2010-01开始。训练残差用lag=12、model_df=1做Ljung–Box诊断;后120个月逐月扩展训练,比较一步ARIMA与当时训练均值基准的RMSE。
Notebook显示fixtures/figures/a4/ch16_stationarity_acf.png随包既有图;显示不等于本次重新生成。RUN_FRENCH=False关闭历史市场分支。虽然创建并打印runs/ch16_time_series_<uuid>/,本Notebook不向它写CSV或PNG。运行器另在唯一runs/execution_*目录保存执行副本与状态;两个目录用途不同。构造计算不形成市场预测或策略净收益证据;第10–11节的French历史图表与数字保留原有身份。
下方CLI与制作测试属于历史课程工作根流程,不是本包默认路线;未随包提供的制作测试不要求读者补回。I3 CLI第16章仍无条件读取French,CLI第17章历史分支需--french-data,均不替代上述默认命令。
历史课程工作根与原实现
本章核心实现位于 time_series.pyvalidate_monthly_series 要求升序、唯一、连续的 PeriodIndex(freq="M") 和有限实数;缺月、NaN、无穷、复数都会显式报错。split_monthly_series 只按行数前后切分,不随机打乱。forecast_arima(train, ...) 的输入只有训练前缀;rolling_origin_forecast 在每个目标月之前重拟合一个扩展窗口,再预测下一月。该教学封装支持非季节阶数 d = 0 d=0 d = 0
statsmodels 的 ARIMA 似然实现对很小的十进制收益数可能出现数值收敛警告。本章拟合函数把月收益小数乘以 100 转成百分点后拟合,再把预测均值、区间与残差缩回小数;AR/MA 系数不因统一线性缩放而变。FittedARIMA.result 是 statsmodels 在百分点单位上的拟合结果,截距、残差和创新标准差若直接读取仍是百分点;优先用 .residuals 取得小数残差。
估计时,输入是严格截止于预测起点的月收益序列,模型阶数 ( p , d , q ) (p,d,q) ( p , d , q ) fit() 在该训练样本上估计参数,之后 get_forecast() 才产生未来条件均值和预测区间。ACF/PACF 只帮助提出小范围候选。可在训练窗内用 AIC/BIC 比较拟合候选,再用按时间推进的验证窗比较 MAE/RMSE;最终留出窗不能参与反复选阶。
本封装对 d = 0 d=0 d = 0 trend="c",statsmodels 把趋势项作为回归常数,因此这里的 const 表示序列的恒定水平/无条件均值。若写成教材中的递推截距形式 X t = c + ϕ X t − 1 + ε t X_t=c+\phi X_{t-1}+\varepsilon_t X t = c + ϕ X t − 1 + ε t c = ( 1 − ϕ ) μ c=(1-\phi)\mu c = ( 1 − ϕ ) μ const 直接当成递推式的 c c c d = 1 d=1 d = 1 trend="n",即不估计漂移项。模型还约束 AR 根为平稳、MA 根为可逆,并要求缺失时报错;这些计算选项不会证明数据符合模型。标准预测区间依赖模型创新结构,正态区间还依赖正态误差近似,参数已估计时也没有自动囊括所有参数不确定性。
在 quant_course/ 项目根目录执行脚本和专项测试:
.venv/bin/python code/ch16_time_series.py
.venv/bin/python -m pytest -q tests/test_ch16_time_series.py
脚本用固定种子 20261016 生成 480 个月的 IID 与 AR(1) 构造数据,绘图后打印理论与样本矩、模拟扩展窗 RMSE,并读取 French 行业快照计算描述性统计。Notebook ch16_time_series.ipynbquant-course-venv 内核重跑;Notebook 直接调用 src/,不是另写一套核心函数。
下面是完整的月频切分和一步预测示例。收益小数表示月度收益,target_period 是预测目标月份;它不是实际 trade_time。
import numpy as np
from quant_course.time_series import (
forecast_arima,
simulate_stationary_pair,
split_monthly_series,
training_mean_forecast,
)
monthly_returns = simulate_stationary_pair(
n=120 , seed=20261016 , mean=0.005 , marginal_sd=0.04 , phi=0.7
)["ar1" ]
train, test = split_monthly_series(monthly_returns, train_size=96 )
prediction = forecast_arima(train, steps=1 , order=(1 , 0 , 0 ))
baseline = training_mean_forecast(train, steps=1 )
print ("train through:" , train.index[-1 ], "target:" , prediction.index[0 ])
print ("ARIMA forecast:" , float (prediction.iloc[0 ]["forecast" ]))
print ("training-mean baseline:" , float (baseline.iloc[0 ]))
print ("realized test return, for retrospective scoring only:" , float (test.iloc[0 ]))
assert prediction.index[0 ] == test.index[0 ]
assert np.isfinite(prediction.to_numpy()).all ()
对于样本 ACF/PACF,sample_acf_pacf 明确返回滞后 1 到 L L L adjusted=False, fft=False, missing="raise",PACF 使用 method="ywadjusted"。ACF/PACF 的有限样本置信界依赖额外假设,正文图不把越过一条线当成模型证明。
10. Visualization
下图是脚本生成的 480 期月频模拟,随机种子为 20261016。上排横轴是月度观测时间,纵轴是月收益百分数;下排横轴是滞后月数,纵轴是无量纲 ACF。蓝色是样本 ACF,橙色是由生成参数计算的总体 ACF。IID 过程的橙线在零处,AR(1) 的理论相关按 0.7 k 0.7^k 0. 7 k
11. Real Market Example
本地真实样本是 French 10 行业组合的当前月度价值加权收益缓存 月度行业收益CSV,对应原始来源见 数据详情页 和 保存的数据清单。缓存由 2026-10-05 下载的 ZIP 解析,选择“Average Value Weighted Returns — Monthly”区块,将源文件百分数除以 100;样本 1,202 个月,从 1926-07 到 2026-08。它是行业组合的发布收益,不是逐股 OHLCV 价格或基金成交回报。
脚本实际读取 NoDur(消费耐用品以外的非耐用品行业)列,得到均值 0.009411、样本标准差 0.045564、样本 ACF(1)=0.094385、ACF(12)=0.034820。数字用于确认字段、单位和描述性算法确实运行;它们不表示显著性、稳定性、可预测收益或策略有效。月收益并非同方差 IID 的定理样本,A1 清单还说明这份缓存是当前发布版本,不能回建每月当时可见版本,故不能用它宣称真实历史滚动预测。
读取规则是将 month 保留为 YYYYMM 字符串,再转为 PeriodIndex(freq="M");每个行业列是小数形式的简单月收益。数据无 OHLCV 日区块,不能把它合成日度数据。清单没有核实一个可用于课程外再分发的通用许可;公开下载不自动等于可任意转发。
12. Common Mistakes
把月末 DatetimeIndex 当作等间隔天数。 2 月 29 日到 3 月 31 日和 3 月 31 日到 4 月 30 日都应是一个观测月,但自然天数不同。对逐月序列使用月度 PeriodIndex;若任务关心实际天数或营业日,就应明确定义另一种时间尺度,不能靠行号猜测。
先删掉缺失月份再算滞后。 dropna() 会让后续两行相邻,模型看不出中间跨了两个月。本章严格拒绝缺月/缺失;修复方式是回到来源判断缺失含义并定义合适方法,而不是自动补零、前向填充或假装时间等距。
import numpy as np
import pandas as pd
from quant_course.time_series import validate_monthly_series
incomplete = pd.Series(
[0.01 , -0.02 ],
index=pd.PeriodIndex(["2024-01" , "2024-03" ], freq="M" ),
name="monthly_return" ,
)
try :
validate_monthly_series(incomplete)
except ValueError as error:
print (type (error).__name__ + ":" , error)
把价格水平和收益混为一谈。 若价格为 100、110、121,价格的自相关通常很高,因为上一期价格直接进入本期价格;简单收益却是 10% 和 10%。即便价格 AR(1) 拟合很好,也不能据此宣布收益有同样预测关系。需要时先按目标问题计算收益,再单独定义收益区间。
看到 ACF/PACF 的“截尾”就定阶。 样本相关是估计量,几十个滞后里总可能有随机尖峰。低阶图形模式只产生候选;选阶必须在训练窗口内完成,再在时间顺序验证窗比较预测损失。不能一边看最终留出结果、一边反复改 p , q , d p,q,d p , q , d
用全样本选择变换或估计预处理,再切分。 预先固定、只用当前与过去观测的因果后向差分本身不必然泄漏未来信息;风险在于用全样本选择差分阶数、拟合标准化或填补规则,或把未来状态与缺失结构带入过去的决定。先定义有可得时间的原始数据;训练和验证切点要对应预测起点;任何估计型变换只从训练数据拟合。
把 Ljung–Box 的大 p 值写成“残差独立”。 检验只是在选定滞后集和渐近参考分布下检查一组线性自相关;小样本检验功效有限,也不检查残差平方的相关、厚尾或参数稳定性。报告检验的 H 0 H_0 H 0
检验从残差样本 e 1 , … , e n e_1,\ldots,e_n e 1 , … , e n 1 1 1 h h h
Q = n ( n + 2 ) ∑ k = 1 h ρ ^ e ( k ) 2 n − k .
Q=n(n+2)\sum_{k=1}^{h}\frac{\hat\rho_e(k)^2}{n-k}.
Q = n ( n + 2 ) k = 1 ∑ h n − k ρ ^ e ( k ) 2 . 原假设是这些滞后上的总体残差自相关同时为零;在常用渐近校准下,参考自由度为 h − m h-m h − m m m m model_df(对 ARMA 拟合通常扣除已估 AR、MA 参数数)。例如 h = 12 , m = 1 h=12,m=1 h = 12 , m = 1
import pandas as pd
from quant_course.time_series import ljung_box_diagnostic, simulate_stationary_pair
residuals = simulate_stationary_pair(n=120 , seed=20261016 )["iid" ]
diagnostic = ljung_box_diagnostic(residuals, model_df=1 , lag=12 )
print (diagnostic.to_string())
print ("Interpretation: a failure to reject is not proof of IID residuals." )
13. Quant Research Application
研究问题先限定为:“过去月度收益是否能改善下一月收益的点预测?”它不是“AR(1) 是否证明动量因果机制”,也不是“能否无成本交易”。完整设计可以按下列步骤执行:
定义变量和时钟。 记录价格或组合收益的来源、币种、频率、复权/股息口径和月度区间。若特征 X t X_t X t t t t available_at 不能早于实际发布时间;signal_time 只能在全部输入可见后;trade_time 必须晚于信号且符合所选市场撮合规则。目标 Y t + 1 Y_{t+1} Y t + 1 Y t Y_t Y t 先做描述,不以图判平稳。 查看价格水平和收益的不同图形、缺月、异常值、分布和 ACF/PACF。一个月度 PeriodIndex 每步为一个月;实证数据不等于收益一定平稳。本章不做单位根或协整检验,这些检验放在第 17 章。预先定训练和验证。 例如前 15 年训练、接下来逐月滚动预测;每个起点只用起点以前可见的观测重估参数。阶数和带宽都在训练范围内选,保留最后一段用于一次最终验证。若输入源没有可核验的历史发布时间或版本,应把结果降为“当前快照的描述分析”,不能伪称点时回测。与朴素基准比较。 对接近零均值的收益,训练均值或零收益基准都可作为明确候选;每个起点的训练均值只能由当时以前计算。按目标收益小数计算 MAE/RMSE,并比较同一预测月份上的误差。若 ARIMA 没有稳定胜过基准,应保留这一结果。诊断并做反证。 检查残差的线性自相关、分布异常、窗口间参数变化和误差随波动状态变化;尝试预先说明的模型阶数和起点敏感性。如果信号时点无效、预测误差不优于基准、模型只在一段时期改善、或残差/参数显示结构失配,就不能将相关结构包装成可预测 alpha。
核心滚动函数每一步内部只传入此前的前缀。它演示数据访问规则,不自动构造历史 available_at,也不替你执行交易。对 French 当前月度收益快照,不具备历史逐月入库/发布时间,不能进行合格的历史点时预测实验。
14. Chapter Summary
先把时间步、收益目标和索引定义清楚,滞后才有经济含义。平稳性刻画分布/矩结构是否随时间改变;白噪声描述二阶相关结构;ACF/PACF概括不同滞后的线性关系。AR、MA、ARMA、ARIMA 是对这些关系的参数化表达,不是自动识别经济机制的工具。
AR(1) 展示了本章核心链条:∣ ϕ ∣ < 1 |\phi|<1 ∣ ϕ ∣ < 1 σ 2 / ( 1 − ϕ 2 ) \sigma^2/(1-\phi^2) σ 2 / ( 1 − ϕ 2 ) ϕ k \phi^k ϕ k
15. Exercises
题目均在同章第 18 节解答。除特别说明外,ε t \varepsilon_t ε t
16-E01(概念) 用数学语言区分严格平稳与弱平稳。说明有限二阶矩下严格平稳为什么能推出弱平稳,再给出一个弱平稳但非严格平稳的构造思路。
16-E02(概念) “白噪声就是 IID”是否正确?构造一列均值为零、方差为 1、非零滞后协方差为零但不独立的过程,并指出可观测的依赖证据。
16-E03(概念) 总体 ACF/PACF 的典型模式如何帮助区分 AR(1)、MA(1) 与 ARMA(1,1)?说明为何这些模式不能单独定阶。
16-E04(时间轴) CSV 有 2024-01, 2024-02, 2024-04 三条月收益,直接删掉缺失行后执行 shift(1),第二、三条之间代表几个月?如何表示正确时间并处理缺失?
16-E05(概念) 为什么“价格图看起来一直上涨”既不能证明单位根,也不能直接证明月收益不可预测?哪个问题留给第 17 章?
16-E06(预测) 预测区间与条件均值置信区间的目标有什么不同?使用正态 AR(1) 区间时,哪些不确定性和分布假设仍需检查?
16-E07(手算:AR(1) 矩) X t = 0.005 + 0.5 ( X t − 1 − 0.005 ) + ε t X_t=0.005+0.5(X_{t-1}-0.005)+\varepsilon_t X t = 0.005 + 0.5 ( X t − 1 − 0.005 ) + ε t sd ( ε t ) = 0.06 \operatorname{sd}(\varepsilon_t)=0.06 sd ( ε t ) = 0.06 γ ( 1 ) \gamma(1) γ ( 1 )
16-E08(手算:预测) 对 E07 的过程,若本月 X T = 0.04 X_T=0.04 X T = 0.04 σ 2 \sigma^2 σ 2
16-E09(手算:MA(1)) X t = μ + ε t + 0.5 ε t − 1 X_t=\mu+\varepsilon_t+0.5\varepsilon_{t-1} X t = μ + ε t + 0.5 ε t − 1 sd ( ε t ) = 0.06 \operatorname{sd}(\varepsilon_t)=0.06 sd ( ε t ) = 0.06 γ ( 0 ) \gamma(0) γ ( 0 ) γ ( 1 ) \gamma(1) γ ( 1 ) k ≥ 2 k\ge2 k ≥ 2
16-E10(手算:差分) 若 X t = ε t X_t=\varepsilon_t X t = ε t σ 2 \sigma^2 σ 2 Δ X t \Delta X_t Δ X t
16-P01(编程) 用固定种子生成 240 个月的两条模拟序列;计算 AR(1) 的 ACF/PACF 到 12 阶,输出首个滞后和样本数量;再断言一个缺月样本会被严格验证器拒绝。
16-P02(编程) 对固定种子的 240 个月 AR(1) 模拟序列,用前 180 个月训练,预测下一个月。输出目标月份、ARIMA 预测、训练均值基准和测试实值。断言目标索引正好是测试首月;不可将测试实值传入拟合函数。
16-P03(编程) 对 P02 训练数据拟合 ARIMA(1,0,0),计算训练残差滞后 12 的 Ljung–Box 检验并输出检验统计量、p 值和自由度。用一句话解释原假设以及该检验不能证明什么。
16-C01(挑战:同矩异相关) 自行构造理论均值、方差相同的 IID 与 AR(1) 月序列;选择种子和样本长度,画两条路径和 ACF,核对理论 AR(1) ACF。写出有限样本可能偏离理论的原因,并说明你没有据此得到什么金融结论。按“参数与假设、随机种子与可复现、矩匹配推导、时间轴/单位、证据边界”五项各 0–2 分评分,共 10 分。
16-C02(挑战:真实数据研究设计) 用 French NoDur 月收益设计“是否改善下一月收益预测”的研究方案。明确单位、时间戳、滚动窗、基准、残差诊断和可证伪条件;评估当前缓存能否支持 PIT 回测。按“来源和版本、目标与时序、无泄漏验证、基准和指标、限制及反证”五项各 0–2 分评分,共 10 分。
16. Programming Exercises
本节的 P01–P03 已列在上一节,分别要求频率契约、仅历史预测和残差诊断。编程参考解必须使用 quant_course.time_series 核心实现,不在 Notebook 中重写 ACF 或拟合逻辑。
17. Challenge Problems
C01 比较总体定律和有限样本图形;C02 检查公开快照、信息时间与历史策略证据之间的距离。两题重点是避免把模拟性质或当前发布日期倒灌成当时可得信息。
补充练习(独立编号)
16-N01(识别与手算;§3.1、§6.1.1) :总体方差为 0.0048 的 AR(1) 从固定均值起点运行,ϕ = 0.5 , σ = 0.06 \phi=0.5,\sigma=0.06 ϕ = 0.5 , σ = 0.06 16-N02(诊断;§6.2–6.3) :给定 e t = 0.5 e_t=0.5 e t = 0.5 16-N03(预测还原与研究判断;§6.5–6.6) :最后水平102,未来两期变化预测1和2,误差方差各4、协方差1。求两期水平预测和第二期误差方差。若仅有二月和四月月收益,应如何处理相邻行滞后?若ARIMA原水平输入设d = 1 d=1 d = 1
18. Solutions / Solution Hints
16-E01 答案。 严格平稳要求所有有限维联合分布在共同时间平移下不变;弱平稳只约束常数均值、有限常方差以及仅随滞后改变的自协方差。若严格平稳且二阶矩存在,则边际均值、方差不随时点变化,任意两期协方差只受相隔 k k k + 2 +\sqrt2 + 2 − 2 -\sqrt2 − 2
16-E02 答案。 令 Z t Z_t Z t ε t = Z t Z t − 1 \varepsilon_t=Z_tZ_{t-1} ε t = Z t Z t − 1 E [ Z t 2 ] E [ Z t − 1 2 ] = 1 \mathbb{E}[Z_t^2]\mathbb{E}[Z_{t-1}^2]=1 E [ Z t 2 ] E [ Z t − 1 2 ] = 1 Z t 2 Z_t^2 Z t 2
E [ ε t 2 ε t + 1 2 ] = E [ Z t 4 ] = 3 , E [ ε t 2 ] E [ ε t + 1 2 ] = 1 , Cov ( ε t 2 , ε t + 1 2 ) = 2.
\mathbb{E}[\varepsilon_t^2\varepsilon_{t+1}^2]=\mathbb{E}[Z_t^4]=3,
\quad \mathbb{E}[\varepsilon_t^2]\mathbb{E}[\varepsilon_{t+1}^2]=1,
\quad \operatorname{Cov}(\varepsilon_t^2,\varepsilon_{t+1}^2)=2.
E [ ε t 2 ε t + 1 2 ] = E [ Z t 4 ] = 3 , E [ ε t 2 ] E [ ε t + 1 2 ] = 1 , Cov ( ε t 2 , ε t + 1 2 ) = 2. 因此相邻创新不独立。白噪声只保证二阶不相关,不能替代 IID 假设。
16-E03 答案。 理论 AR(1) 的 ACF 为 ϕ k \phi^k ϕ k
16-E04 答案。 删除 3 月后,留下行的 shift(1) 会把 2 月行当成 4 月行的前一观测,但它们实际相隔两个月。保留月标签并构造成月频 PeriodIndex,验证索引连续;缺失月份要查原始数据和缺失含义,使用明确适用的缺失模型或限定样本,不应当成一个月滞后,也不能默认填零。
16-E05 答案。 上涨趋势可来自确定性趋势、随机趋势、结构变化、复权方式或样本选择;一张价格图无法区分。价格水平随自身过去高度相关,也不说明收益 P t / P t − 1 − 1 P_t/P_{t-1}-1 P t / P t − 1 − 1
16-E06 答案。 条件均值置信区间关注未知均值估计的不确定性;预测区间关注未来一个随机观测,因此还包括未来创新的方差。常见 AR(1) 正态预测区间把 μ , ϕ , σ 2 \mu,\phi,\sigma^2 μ , ϕ , σ 2
16-E07 逐步解答。 均值由中心化表达式直接读出 μ = 0.005 \mu=0.005 μ = 0.005 0.06 2 = 0.0036 0.06^2=0.0036 0.0 6 2 = 0.0036
γ ( 0 ) = Var ( X t ) = 0.0036 1 − 0.25 = 0.0048 , s d ( X t ) = 0.0048 ≈ 0.06928.
\gamma(0)=\operatorname{Var}(X_t)=\frac{0.0036}{1-0.25}=0.0048,
\quad sd(X_t)=\sqrt{0.0048}\approx0.06928.
γ ( 0 ) = Var ( X t ) = 1 − 0.25 0.0036 = 0.0048 , s d ( X t ) = 0.0048 ≈ 0.06928. 标准差约为月收益 6.928%。下一步 γ ( 1 ) = ϕ γ ( 0 ) = 0.5 ( 0.0048 ) = 0.0024 \gamma(1)=\phi\gamma(0)=0.5(0.0048)=0.0024 γ ( 1 ) = ϕ γ ( 0 ) = 0.5 ( 0.0048 ) = 0.0024 = 0.0024 / 0.0048 = 0.5 =0.0024/0.0048=0.5 = 0.0024/0.0048 = 0.5 γ ( 2 ) = 0.5 ( 0.0024 ) = 0.0012 \gamma(2)=0.5(0.0024)=0.0012 γ ( 2 ) = 0.5 ( 0.0024 ) = 0.0012 = 0.25 =0.25 = 0.25
16-E08 逐步解答。 一步偏离均值为 0.04 − 0.005 = 0.035 0.04-0.005=0.035 0.04 − 0.005 = 0.035
0.005 + 0.5 2 ( 0.035 ) = 0.01375 ,
0.005+0.5^2(0.035)=0.01375,
0.005 + 0. 5 2 ( 0.035 ) = 0.01375 , 即 1.375%。一步误差方差只含一个未来创新,为 (0.0036);两步误差为 ε T + 2 + 0.5 ε T + 1 \varepsilon_{T+2}+0.5\varepsilon_{T+1} ε T + 2 + 0.5 ε T + 1 0.0036 ( 1 + 0.25 ) = 0.0045 0.0036(1+0.25)=0.0045 0.0036 ( 1 + 0.25 ) = 0.0045
16-E09 逐步解答。 MA(1) 方差由两项不相关创新平方相加:γ ( 0 ) = 0.06 2 ( 1 + 0.5 2 ) = 0.0045 \gamma(0)=0.06^2(1+0.5^2)=0.0045 γ ( 0 ) = 0.0 6 2 ( 1 + 0. 5 2 ) = 0.0045 0.5 ε t − 1 0.5\varepsilon_{t-1} 0.5 ε t − 1 ε t − 1 \varepsilon_{t-1} ε t − 1 γ ( 1 ) = 0.5 ( 0.0036 ) = 0.0018 \gamma(1)=0.5(0.0036)=0.0018 γ ( 1 ) = 0.5 ( 0.0036 ) = 0.0018 ρ ( 1 ) = 0.0018 / 0.0045 = 0.4 \rho(1)=0.0018/0.0045=0.4 ρ ( 1 ) = 0.0018/0.0045 = 0.4
对本章约定的 (1+0.5L),零点是 L = − 2 L=-2 L = − 2 ∣ θ ∣ < 1 |\theta|<1 ∣ θ ∣ < 1 L = − 1 / θ L=-1/\theta L = − 1/ θ
16-E10 逐步解答。 Δ X t = ε t − ε t − 1 \Delta X_t=\varepsilon_t-\varepsilon_{t-1} Δ X t = ε t − ε t − 1 2 σ 2 2\sigma^2 2 σ 2 Δ X t − 1 = ε t − 1 − ε t − 2 \Delta X_{t-1}=\varepsilon_{t-1}-\varepsilon_{t-2} Δ X t − 1 = ε t − 1 − ε t − 2 − σ 2 -\sigma^2 − σ 2
16-P01 参考实现。 下列脚本单独运行,构造连续月度 PeriodIndex,再计算 ACF/PACF;含缺月索引会被验证器拒绝。
import pandas as pd
from quant_course.time_series import (
sample_acf_pacf,
simulate_stationary_pair,
validate_monthly_series,
)
pair = simulate_stationary_pair(n=240 , seed=20261016 , phi=0.7 )
summary = sample_acf_pacf(pair["ar1" ], lags=12 )
print ("n:" , len (pair), "lag-1 ACF:" , float (summary.loc[1 , "acf" ]))
assert summary.index[0 ] == 1 and summary.index[-1 ] == 12
missing_month = pd.Series(
[0.01 , 0.03 ], index=pd.PeriodIndex(["2000-01" , "2000-03" ], freq="M" )
)
try :
validate_monthly_series(missing_month)
except ValueError as error:
print ("gap rejected:" , error)
else :
raise AssertionError("a missing calendar month was accepted" )
16-P02 参考实现。 唯一传给 forecast_arima 的是前 180 个月。程序只在回看时读取测试首月的实际值,并断言预测目标月份与测试首月完全一致。
from quant_course.time_series import (
forecast_arima,
simulate_stationary_pair,
split_monthly_series,
training_mean_forecast,
)
returns = simulate_stationary_pair(n=240 , seed=20261016 , phi=0.7 )["ar1" ]
train, test = split_monthly_series(returns, train_size=180 )
prediction = forecast_arima(train, steps=1 , order=(1 , 0 , 0 ))
baseline = training_mean_forecast(train, steps=1 )
print ({
"origin" : str (train.index[-1 ]),
"target" : str (prediction.index[0 ]),
"arima" : float (prediction.iloc[0 ]["forecast" ]),
"training_mean" : float (baseline.iloc[0 ]),
"realized_for_scoring" : float (test.iloc[0 ]),
})
assert prediction.index[0 ] == test.index[0 ]
assert train.index[-1 ] + 1 == test.index[0 ]
16-P03 参考实现。 model_df=1 扣除已估计 AR(1) 系数的一个自由度;lag=12 联合查看前 12 个月。H 0 H_0 H 0
from quant_course.time_series import (
fit_arima,
ljung_box_diagnostic,
simulate_stationary_pair,
)
series = simulate_stationary_pair(n=240 , seed=20261016 , phi=0.7 )["ar1" ]
training = series.iloc[:180 ]
fitted = fit_arima(training, order=(1 , 0 , 0 ))
model_df = 1
lag_months = 12
test = ljung_box_diagnostic(fitted.residuals, model_df=model_df, lag=lag_months)
print (test.to_string())
print ("reference chi-square degrees of freedom:" , lag_months - model_df)
print ("H0: the first 12 residual autocorrelations are jointly zero; non-rejection is not proof of IID." )
16-C01 参考论证、数值和评分。 令边际目标标准差 s = 0.04 s=0.04 s = 0.04 μ = 0.005 \mu=0.005 μ = 0.005 ϕ = 0.7 \phi=0.7 ϕ = 0.7 N ( μ , s 2 ) \mathcal{N}(\mu,s^2) N ( μ , s 2 ) s 1 − ϕ 2 = 0.0285657 s\sqrt{1-\phi^2}=0.0285657 s 1 − ϕ 2 = 0.0285657 s 2 s^2 s 2 0.7 k 0.7^k 0. 7 k
import numpy as np
from quant_course.time_series import sample_acf_pacf, simulate_stationary_pair
pair = simulate_stationary_pair(n=480 , seed=20261016 , mean=0.005 , marginal_sd=0.04 , phi=0.7 )
for name in ("iid" , "ar1" ):
acf_values = sample_acf_pacf(pair[name], lags=12 )
print (name, "mean" , f"{pair[name].mean():.6 f} " , "sd" , f"{pair[name].std(ddof=1 ):.6 f} " , "rho1" , f"{acf_values.loc[1 , 'acf' ]:.6 f} " )
assert pair.index.freqstr == "M"
评分每项 0–2 分:明确 s ε = s 1 − ϕ 2 s_\varepsilon=s\sqrt{1-\phi^2} s ε = s 1 − ϕ 2
16-C02 参考研究方案、可接受结论与评分。 当前数据允许演示将字符串月标签变为月频 PeriodIndex、校验连续月份、计算收益均值/标准差/ACF;它不能提供每个历史月的原始版本、公告/入库 available_at 或历史信号首次可用时点。故严谨结论应为:“在 2026-10-05 保存的当前 French 发布快照上,NoDur 月收益的描述统计为……;该资料不足以判断历史实时预测能力。”不能把下载时点当作 1926 年以来逐月信息时间,也不能将行业组合收益当作可成交个股价格。
如要升级为预测研究,需取得且保留每个观察当时可见的版本与时间戳,定义 X t X_t X t Y t + 1 Y_{t+1} Y t + 1
评分每项 0–2 分:正确引用数据版和行业组合单位(2 分);区分月份标签、发布时间、signal_time、trade_time 与目标收益区间(2 分);按时间滚动且只用过去训练(2 分);预先定义朴素基准和样本外指标(2 分);明示缺少历史 PIT 版本并给反证条件(2 分)。若把当前 CSV 直接称为 PIT 或把 ACF 当 alpha,时间和证据两项均计 0 分。
补充练习答案
16-N01。 前三期方差为 0.0036 0.0036 0.0036 0.0036 ( 1 + 0.25 ) = 0.0045 0.0036(1+0.25)=0.0045 0.0036 ( 1 + 0.25 ) = 0.0045 0.0036 ( 1 + 0.25 + 0.0625 ) = 0.004725 0.0036(1+0.25+0.0625)=0.004725 0.0036 ( 1 + 0.25 + 0.0625 ) = 0.004725 X t = Z X_t=Z X t = Z Z Z Z E Z \mathbb E Z E Z
16-N02。 下一期为 2 ( 0.5 ) 2 − 1 = − 0.5 2(0.5)^2-1=-0.5 2 ( 0.5 ) 2 − 1 = − 0.5
16-N03。 水平预测为103、105;第二期误差方差 4 + 4 + 2 ( 1 ) = 10 4+4+2(1)=10 4 + 4 + 2 ( 1 ) = 10 ϕ 2 \phi^2 ϕ 2 σ 2 ( 1 + ϕ 2 ) \sigma^2(1+\phi^2) σ 2 ( 1 + ϕ 2 ) p , 1 , q p,1,q p , 1 , q
19. Further Reading
20. References
本章正文的定义和 AR(1)/MA(1) 矩公式为独立推导;statsmodels 文档用来核验代码接口与参数含义。完整核验日期、阅读页范围、运行依赖和不能由数据支持的结论见 source_notes.md
statsmodels ARIMA、ARIMAResults.get_forecast、acf、pacf、acorr_ljungbox 与 ArmaProcess 官方文档:支持本章实现与 API 说明,不支持模型有效或市场可预测性结论。
Kenneth R. French Data Library 10 Industry Portfolios 数据说明 :支持所下载组合文件的来源与字段背景;本章数字从缓存及哈希清单复核。公开下载页面不被解释为课程目录外任意再分发许可。