第 43 章/ 45
贝叶斯推断、因果识别与非结构化数据(Bayesian Inference, Causal Identification, and Alternative Text Data)
本章以冻结的构造结果为起点,保留模板泛化和摘要信任边界;未训练或调用模型。
主线:金融研究中的预测、概率更新与干预决策具有截然不同的数理本质。贝叶斯推断用后验概率刻画小样本与群组间的不确定性;因果识别用潜在结果与 DAG 表达混杂路径,并在明确假设下识别干预效应;替代数据与大语言模型则必须在时点资格(Point-in-Time, PIT)、延迟入库、版本修订与训练语料截止的严格契约下完成特征提炼。任何跨期拟合词表、混淆事后平滑与实时预测、或将 LLM 预训练截止等同于历史 PIT 的行为,都会导致致命的前瞻偏差。
先修:第6章 概率论与第7章 数理统计(条件概率、贝叶斯定理、期望与方差)、第8章 线性回归(最小二乘与正则化)、第12章 基本面量化与 PIT(财报发布与时点可得性)、第22章 研究设计(因果推断与混杂偏误)、第31章 标签净化与禁运与第38章 机器学习管线(严格时间序列验证与特征防泄漏)。
完成后你能:推导 Beta-Binomial 共轭后验及未来两期联合预测协方差;手算已知超参数的正态层级均值部分池化收缩与后验预测方差;构建因果 DAG 并在识别假设下用分层标准化识别 ATE,手算 Simpson 悖论的反转机制并诊断重叠性(Positivity)破坏;建立严谨的盘后业绩电话会时点账本,在时区转换与延迟入库约束下过滤版本资格;在训练窗内独立拟合 TF-IDF 词表,比较文本 Ridge 回归与历史均值基准;手算稠密词嵌入余弦相似度与否定词情感翻转;设计包含提示词版本哈希与训练语料截止审查的大模型离线研究台账。
1. 本章目标
- 掌握贝叶斯共轭更新与预测分布:从先验与似然出发,完整推导 Beta-Binomial 的后验参数
;推导未来单期预测均值 与未来两期联合预测概率 ;证明两次未来的伯努利试验给定参数 是条件独立的,但在边际后验预测分布下是相关的,其协方差严格等于后验方差 。 - 理解层级模型与部分池化(Partial Pooling)的收缩机制:以 Gelman et al. (BDA3) 第 5.4 节为基准,在已知超参数
条件下,推导各连续收益率资产组后验均值的精度加权收缩权重 ;手算小样本组 ( ) 与大样本组 ( ) 向全市场先验均值 的收缩差异,并推导包含群组不确定性与新观测噪声的后验预测方差 。明确本章限定在已知超参数的教学范围,不夸大为估计未知超参数的经验贝叶斯。 - 建立因果图(DAG)与潜在结果框架(Potential Outcomes):区分统计关联
与因果干预 ;逐项列出识别因果平均处理效应(ATE)的四大假设:一致性(Consistency)、条件可交换性(Conditional Exchangeability)、正值性/重叠(Positivity / Overlap)以及稳定个体处理值假设(SUTVA,包含无个体间干扰与无隐藏处理版本);手算 Simpson 悖论案例,说明二值成功率的未调整粗差 ( ,即 个百分点) 如何通过分层标准化得到负向观测差,并在识别假设下解释为ATE ( ,即 个百分点);强调不能脱离识别假设将调整后关联等同于无条件真实因果;编写对撞物(Collider)偏误的可运行反例并推导负协方差 。 - 规范非结构化替代数据的时点契约(PIT Contract):建立包含
event_time、available_at、ingested_at、revision_time、signal_time、trade_time与label_available_at的多时区规范账本;以美股盘后 16:05 财报电话会为例,施加 20 分钟供应商延迟与 5 分钟内部入库延迟,推演夏令时(EST/EDT)与 UTC 转换规则;编写对晚于信号时间的修订版本(Amendments)与延迟入库记录的剔除逻辑;明确区分公开可访问性与商业抓取/训练/再分发授权许可边界。 - 构建防泄漏文本预测管线与基准对齐:使用4固定模板循环形成的120条构造业绩电话会事件(带有
CONSTRUCTED_CALL_前缀,明确教学构造),严格执行训练集(59 篇)、验证集(29 篇)与测试集(30 篇)时序划分(训练与验证标签成熟时点严格在后续块首个信号时点之前成熟,<);在训练窗内独立拟合词表与 IDF,冻结后投影至验证集与测试集;处理测试窗外(OOV)词汇时确保训练特征不变异;在统一的测试集上比较全局均值基准与 TF-IDF + Ridge 回归;保留低信噪比下的真实负结果(测试集 MSEvs 均值基准 ,相对 ;时序汇总 Spearman 秩相关系数 ;明确每日仅单一资产因而截面 IC 未定义,均值常数基准秩相关未定义);本章为 prediction-only,提供对接下游真实投资组合账本与费用测算的接口规约,不虚构轮换资产的成交换手。 - 理解词嵌入与否定词情感分析的底层几何:给出 TF-IDF 正式数学定义及 2 篇教学文档完整逐步手算;通过
手算稠密嵌入矩阵解释词向量空间夹角与平均池化(Mean Pooling);通过词袋模型(说明词袋表示不假设词语统计独立)在否定词("not", "no")修饰下的误判,揭示一元词频特征的局限性与 n-gram / 规则增强的必要性。 - 建立严密的大语言模型(LLM)离线研究台账:建立离线提示词模板、版本控制与包含完整实际输入文本的 SHA-256 哈希校验机制;模型明确标记为未调用(
not_run / unknown),预训练截止日仅作为假设反例;深入剖析大模型预训练语料截止时间为何不能等同于可核查的历史 PIT 资格;阐明零温与种子不能消除硬件及底层非确定性漂移;分析量化研究中的幻觉、不可复现性与事实性核验方法。
所有运行目录须为尚不存在的新路径;示例再次执行时更换 trial 编号。
完成条件:第 15–17 节练习可独立推导手算或运行;code/ch43_bayesian_text.py 在独立输出目录下执行成功并生成完整图表与摘要。
2. 为什么 Quant 需要它
以下公司与电话会场景均为构造教学情境,不是已取得的市场事实。先验错误、样本依赖和因果假设不成立仍可能使结论失效。
量化研究员经常面临三类典型的认知陷阱与建模失败:
第一类陷阱是小样本下的点估计幻觉。在低频宏观对冲或特定事件驱动(如违约事件、CEO 离职、重大并购)策略中,历史样本量极小(可能仅有十几次甚至几次观测)。频率学派的点估计(如样本均值)会剧烈波动;若某行业仅有 4 家公司披露了业绩预喜且全部上涨,样本频率点估计为100%,但这不表示频率学派推断断言总体胜率必为100%;小样本区间仍表达不确定性。贝叶斯方法提供了一套公理化的不确定性更新框架,通过引入合理的先验分布,将极端小样本估计拉向全市场先验均值(收缩效应),并输出完整的后验分布与后验预测方差。收缩有助于降低小样本估计的敏感性,但不能保证优化器配置稳定;错误先验也会引入偏差。
第二类陷阱是把混杂关联当成干预效果。本章构造的补充电话会案例中,处理组总体达标率比对照组高38个百分点;高关注度公司在处理组占比更高,且基础达标率更高。按关注度分层后,两层内的观测差都为−10个百分点。这个方向反转说明总体关联受分组权重影响;把标准化差解释为ATE仍须后文的识别假设,不能从这张表推断管理层行为的真实机制或实际交易盈亏。
第三类陷阱是非结构化数据与大模型应用中的前瞻泄漏(Look-ahead Leakage)。随着另类数据(新闻、研报、电话会、社交媒体)与大语言模型的普及,文本数据已成为前沿量化的兵家必争之地。然而,文本数据的时点结构极其脆弱:
- 入库延迟:新闻发布于盘后 16:05,供应商分发需 20 分钟,公司内部入库需 5 分钟。在 16:30 之前,本地量化研究数据库根本不可用该文本,若策略信号在 16:15 生成并假想在盘后撮合,则直接构成了实盘不可行的时间穿越;
- 事后修订:财务电话会速记稿常常在次日被发行人更正或补充,若直接拿最新的修订版本回测历史信号,便泄漏了未来更正信息;
- 预训练语料污染:大语言模型的预训练语料爬取自互联网,假设模型训练截止至 2023 年底,那么训练语料可能包含 2022 年事件发生后的报道。仅凭截止声明不能证明用于 2022 年历史信号的输出没有未来知识;是否实际受污染仍需专门实验。
本章在数理上打通贝叶斯推断与因果识别,在工程上落地严密的 Point-in-Time 文本处理链条,为量化研究建立起不可逾越的时间与因果护城河。
3. 直觉
为了建立清晰的物理图像,我们从三个金融与统计案例出发:
3.1 贝叶斯共轭更新与资产收益率层级收缩
- 共轭更新直觉:设某量化策略的交易胜率为
。在实盘之前,你基于全市场同类策略的先验认知设定 (期望胜率 0.5)。若10次构造交易中8次盈利,极大似然点估计为80%,但这个点估计不表达小样本不确定性。本例所设先验下,贝叶斯更新给出后验均值 ,自适应地在先验常识与微弱样本之间取得平衡。 - 连续资产收益率的部分池化(Partial Pooling):考虑跨行业或风格群组的连续超额收益率估计。设全市场长期无条件超额收益先验中枢为
,组间离散度为 ,单笔交易观测噪声为 。 - 组 1 为新上市科技股,历史样本极小(
),样本均值为 ( )。由于样本量极低,模型赋予其 的收缩权重,后验均值被强烈拉回至 ; - 组 2 为成熟大盘蓝筹,历史样本充分(
),样本均值为 ( )。由于证据扎实,模型赋予其 的样本权重,后验均值为 。 部分池化机制自动完成了“对缺乏证据的群组克制信任、对证据确凿的群组尊重数据”的收缩折衷。
- 组 1 为新上市科技股,历史样本极小(
3.2 辛普森悖论与分析师关注度混杂
本例构造200家公司记录,处理是“盘后补充电话会(发布补充指引,
3.3 电话会文本的时间旅行
某上市公司于盘后 16:05 结束了电话会。你在历史数据库里检索到该电话会的文本,并用它计算次日 09:30 开盘买入的信号。看似时间是顺流而下的,但数据库里的这篇文本很可能是次日上午 10:00 经过公司法律与投资者关系部门二次校对后的修订版(更正了口误数据)。如果在 09:00 就使用这篇文本计算情感得分,你的算法实际上搭乘了“时间机器”。必须在信号时点冻结历史入库账本,严格拒绝未来版本。
4. 数学基础
本章统一遵循课程标准符号表(notation.md),先修符号、维度与时间契约如下:
| 符号 | 含义 | 维度 / 单位 | 成立条件 / 解释 |
|---|---|---|---|
| 成功概率或单次试验二值事件的参数 | 标量,无量纲, |
伯努利试验参数 | |
| Beta 分布超参数 | 标量,正实数, |
伪成功次数与伪失败次数 | |
| 层级模型中组 |
标量,与观察同单位 | 服从公共先验分布 |
|
| 群组先验均值与先验标准差(超参数) | 标量,收益单位 | 本章教学严格限定为已知常数 | |
| 单个样本的观测噪声标准差 | 标量,收益单位 | 已知常数, |
|
| 组 |
整数,实数 | ||
| 组 |
标量, |
||
| 组 |
标量,收益平方单位 | ||
| 混杂变量、处理变量、结果变量 | 离散或连续标量 | ||
| 潜在结果变量(Potential Outcomes) | 标量 | 假想干预 |
|
| 平均处理效应(Average Treatment Effect) | 标量,结果单位 | ||
| 现实物理事件发生时点 | UTC 时间戳 | 财报披露、电话会召开时刻 | |
| 外部供应商可提供文本的最早时点 | UTC 时间戳 | 包含传输与转码延迟 | |
| 本地数据库完成入库的最早时点 | UTC 时间戳 | 包含本地 ETL 延迟 | |
| 策略产生买卖信号的决策时点 | UTC 时间戳 | 可用与入库均不晚于信号 | |
| 订单在交易所实际撮合成交时点 | UTC 时间戳 | 严格晚于信号时点 | |
| 收益目标或评估标签完全成熟可知的时点 | UTC 时间戳 | 训练集标签可得时点必须在拟合决策之前 |
5. 正式定义
5.1 贝叶斯共轭更新(Conjugate Bayesian Updating)
参数
分母是边际似然(marginal likelihood),保证后验积分为 1;离散参数时将积分换为求和。它不是把数据概率与参数概率混为一谈。
在贝叶斯统计中,若先验分布
5.2 后验预测分布(Posterior Predictive Distribution)
后验预测分布是在观测到已有数据
核心命题:对于未来两次共享同一未知参数
当后验浓度有限且两个 Beta 参数均为正时,协方差精确等于
5.3 正态层级模型与部分池化(Normal Hierarchical Model & Partial Pooling)
以下闭式解假设:给定已知超参数时各组先验独立;给定各自
考虑
在已知超参数
后验精度是先验精度与样本精度之和:
5.4 潜在结果(Potential Outcomes)与平均处理效应(ATE)
设二值处理变量
:该个体接受处理( )时的潜在结果; :该个体未接受处理( )时的潜在结果。
因果推断的根本难题在于,现实中每个个体只能观察到其中一个潜在结果:。
目标人群的平均处理效应(Average Treatment Effect, ATE)定义为:
5.5 因果识别的四大假设(Causal Identification Assumptions)
依据 Hernán & Robins (2020),要将观测数据中的统计对比转化为因果 ATE,必须满足以下四大基础假设:
-
一致性(Consistency):若个体实际接受处理
,则其观察到的结果 等于潜在结果 ,即 。 -
条件可交换性(Conditional Exchangeability / No Unmeasured Confounding):在充分控制混杂协变量
的条件下,潜在结果分布与实际处理分配条件独立: 。在 DAG 中,这意味着控制 能够完全阻断所有连接 与 的后门路径(Backdoor Paths)。 -
正值性 / 重叠(Positivity / Overlap):在目标总体的每一个混杂分层
(即 )内,接受处理和对照的概率均严格大于零: 正值性是指所有分层均有正概率接受任一处理,绝非变量服从正态分布。若某层全部接受处理或全部未接受处理,该层的对照潜在结果无法从数据中识别,算法必须显式报错拒绝,绝不可静默填充!
-
稳定个体处理值假设(Stable Unit Treatment Value Assumption, SUTVA):包含两个紧密关联的核心维度:
- 无个体间干扰(No Interference):某个体的处理状态不会影响其他个体的潜在结果(例如一只股票召开电话会并被纳入策略买入,不会直接改变未开会股票在平行世界下的潜在超额收益);
- 无处理版本变异 / 无隐藏版本(Treatment Variation Irrelevance / No Hidden Versions of Treatment):对于声明的处理水平
,不存在未被观测到的异质处理版本导致潜在结果产生差异(例如不论由 CEO 还是 CFO 召开、不论语速快慢,处理定义 在因果机制上是同质等价的)。
5.6 分层标准化(Standardization)
在条件可交换性、正值性、一致性与 SUTVA 同时满足时,目标总体因果 ATE 可通过在目标人群边际分布
必须强调:分层标准化计算得到的数值对比,仅在上述四大识别假设完全成立时才能被解释为目标总体因果平均处理效应(Causal ATE);若存在未观测混杂(Unmeasured Confounder)、违反 SUTVA 或发生样本选择偏误,调整后的统计关联仍然只是特定控制下的条件关联,绝不能直接无条件宣称为真实因果。
5.7 时点可得性(Point-in-Time, PIT)与延迟契约
输入必须具有非缺失、带时区的完整事件、修订、可用、入库、信号、成交和标签时间。教学选择器要求每个 source_id 只有一个决策截止,版本编号为递增正整数;重复版本、矛盾时间和缺失正文会报错,晚入库版本被过滤。许可字段只保存来源说明,不由程序自动认定法律授权。直接训练入口也执行这些检查。
替代数据必须记录每个版本的完整生命周期时间戳:
- 资格判定(在上述有效输入与版本语义前提下):当且仅当
时,该版本在决策时刻具备可用资格。 - 版本更替:若同一事件发布了多个修订版,决策时点只能使用在信号截止前最新已入库的合规版本,禁止事后向前覆盖。
5.8 词袋模型(Bag-of-Words, BoW)与 TF-IDF 特征表示
- 词袋模型将一段文本视作词汇出现频数的无序多重集(Multiset),忽略词序、语法与句法依存。
- 重要概念澄清:词袋特征表示法本身并不假设词语在统计上相互独立(将各个特征的条件分布视为相互独立的假设属于朴素贝叶斯分类器 Naive Bayes 等特定模型,而非 BoW 向量表示本身)。词袋表示的根本局限在于丢弃了顺序信息,无法原生捕捉修饰词、短语组合与否定词极性翻转。
- 词频-逆文档频率(TF-IDF)通过对常见虚词降权、对领域特异性信息词赋权,构建反映词项重要程度的连续稠密/稀疏向量。
5.9 离线大语言模型审查台账与不可复现性防御
在量化研究中规范使用大语言模型(LLM)时,必须构建具备离线审计能力的哈希摘要校验台账:
- 完整提示词(Prompt Template + 实际输入文本)进行 SHA-256 密码学哈希(摘要);
- 密码学哈希只校验摘要一致性,需要独立可信的预期摘要基准;不是加密,也不是不可变时间戳存证。若输入和记录内摘要一起改变,本地重算仍可一致。独立保存的可信摘要能用于对照,但本教学代码不提供该基准的可信保管机制。
- 模型调用状态显式记录为未调用(
model_status: not_run),模型标识记录为not_run / unknown,训练语料截断日仅能作为反例检验假设; - 明确记录复现性局限:设置
temperature=0和固定种子并不能保证跨硬件架构、跨推理引擎版本的比特级复现;模型底层更新或浮点计算漂移会显著影响文本特征输出。
本章所有因果数表均为构造关联数据。生成器不观测潜在结果,无法检验无未测混杂等识别假设;标准化差只有在假设成立时才可解释为 ATE。
6. 推导
6.1 Beta-Binomial 共轭后验与预测协方差推导
步骤 1:先验密度与似然函数。
设参数
在给定共享
步骤 2:后验密度计算。
根据贝叶斯定理,后验密度与先验和似然的乘积成正比:
对比 Beta 分布的核,直接识别出后验分布为:
步骤 3:后验均值与方差。
由 Beta 分布的一阶和二阶矩性质:
步骤 4:后验预测概率与协方差。
对单次未来试验
对未来两次试验
利用方差恒等式
两期联合成功的协方差为:
证毕。在上述有限正参数条件下,两次试验给定
6.2 正态层级均值收缩(Partial Pooling)推导
前提假设:沿用§5.3的组先验独立与给定组均值后条件独立同方差假设;超参数
步骤 1:共轭更新精度合成。
组样本均值的抽样精度为
由正态分布的共轭性质,对数后验密度为二次型:
展开二次项系数:
直接识别后验精度
步骤 2:后验均值加权分解。
线性项系数除以二次项系数,得到后验均值
定义收缩权重
则后验均值表示为先验均值与样本均值的凸组合:
步骤 3:后验预测方差。
对该组未来的新观测
证毕。
6.3 辛普森反转与因果标准化推导
设二值混杂变量
步骤 1:未调整关联差异。
根据全概率公式,未调整条件期望为:
因此,未调整差为:
注意:
步骤 2:因果标准化的识别推导。
由一致性与条件可交换性
在目标人群
在上述识别假设与目标总体正值性下,相减得到因果平均处理效应:
此式中,两项在每一层使用的权重均为相同的目标总体边际分布
6.4 TF-IDF 形式化数学与双文档逐步手算
步骤 1:形式化数学定义。
设语料库包含
-
词频(Term Frequency, TF):文档
中词项 的出现次数记为 。在标准词频中取原始词频 。 -
平滑逆文档频率(Smooth Inverse Document Frequency, IDF):为防止零除及对仅出现一次的罕见词过分赋权,采用 scikit-learn 标准平滑对数公式:
其中
为语料库中包含词项 的文档总数。 -
加权向量与 L2 归一化:
为了减弱文档长度尺度差异,当
时进行 L2 单位化:
若文档为空或全部词项为 OOV,本实现保留零向量,不做除零;零向量与其他向量的余弦相似度未定义。
步骤 2:两篇教学文档手算实例。
设训练语料仅包含两篇微型文档:
- 文档 1:
- 文档 2:
语料库文档数。
-
提取词表与词频: 按字母表排序的词表为:
["growth", "loss", "profit"]()。 词频向量: 词频向量:
-
计算文档频数
与平滑 : -
词项
"growth"出现在和 中, : -
词项
"loss"仅出现在中, : -
词项
"profit"仅出现在中, :
-
-
计算未归一化特征向量
: -
-
模长
-
归一化向量
: -
-
模长
-
归一化向量
:
-
-
计算两文档余弦相似度:
该近似数值表明,两篇文档虽然共享高频词
"growth",但由于特征词"profit"与"loss"的 IDF 赋权更高且相互正交,归一化后的余弦相似度被拉低至约。
6.5 稠密词嵌入空间几何与均值池化(Mean Pooling)推导
设每个词汇被映射到一个
-
短语/句子均值池化(Mean Pooling): 对于包含
个词项的文本序列 ,其未归一化稠密句子表征为词向量的简单代数均值: -
单位球投影(要求
且 ):
单位词向量也可能相消:
与稀疏高维的 TF-IDF 相比,稠密词嵌入将同义词(如 "growth" 与 "expansion")映射在临近的超球面区域,从而能够绕过一元词袋的完全正交限制。但在金融场景下,若无特定领域微调,通用嵌入极易将反义词(如 "profit" 与 "loss")判定为高度相似(因为它们经常出现在相同的语法上下文中)。这也是金融量化必须严格审查嵌入表征质量的核心原因。
7. 金融解释
7.1 贝叶斯收缩如何表达组合输入的不确定性?
在量化资产配置(如 Black-Litterman 模型或多因子收益预测)中,直接使用历史样本均值进行均值-方差优化是著名的“误差放大器”(Error Maximizer)。历史样本均值受短期市场特质冲击扰动巨大。
正态层级模型(Partial Pooling)的金融学实质是:全市场的所有资产共享一个基准的长期风险溢价均值
7.2 混杂与做市商策略中的逆向选择
考虑一种可能的微观结构机制:主动订单流
7.3 替代数据时间延迟与过拟合虚荣
量化团队在向管理层汇报另类数据回测时,极易展示虚高 Sharpe 的回测曲线。其根源往往是“时间戳造假”:新闻或文本虽然在 16:05 发生,但在实际生产中,数据供应商的解析服务常因网络抖动发生排队,或者内部数据工程 ETL 在盘后存在并发瓶颈。只有严格把关可用与入库时间均不晚于信号,才满足文本可得性的必要条件;成交、标签、样本选择和模型有效性仍需另行验证。
7.4 新闻更新与电话会修订:两个时点场景
构造新闻 CONSTRUCTED_NEWS_001 于 2022-03-14 09:12 EDT 发布,09:13 供应商可得、09:14 本地入库。09:15 信号可以使用 v1;09:16 发布、09:18 入库的 v2 即使更准确,也不能覆盖这个历史信号。换算为 UTC 后为 13:12、13:13、13:14、13:15、13:16、13:18,日期相同;这与 §8 的盘后电话会跨日场景不同。下列独立代码复用完整字段结构,明确只改变构造新闻记录,不将其并入冻结主实验:
import pandas as pd
from quant_course.bayesian_text import (
    generate_constructed_text_dataset,
    filter_pit_eligible_documents,
)
base, _ = generate_constructed_text_dataset()
v1 = base.iloc[[0]].copy()
v1["source_id"] = "CONSTRUCTED_NEWS_001"
times = {
    'event_time': '2022-03-14T13:12:00Z',
    'revision_time': '2022-03-14T13:12:00Z',
    'available_at': '2022-03-14T13:13:00Z',
    'ingested_at': '2022-03-14T13:14:00Z',
    'signal_time': '2022-03-14T13:15:00Z',
    'trade_time': '2022-03-14T13:30:00Z',
    'label_start': '2022-03-14T13:30:00Z',
    'label_end': '2022-03-15T13:30:00Z',
    'label_available_at': '2022-03-15T13:30:00Z',
}
for field, stamp in times.items():
    v1[field] = pd.Timestamp(stamp)
v1["text"] = "constructed preliminary revenue growth report"
v2 = v1.copy()
v2["version_id"] = 2
v2["revision_time"] = pd.Timestamp("2022-03-14T13:16:00Z")
v2["available_at"] = pd.Timestamp("2022-03-14T13:17:00Z")
v2["ingested_at"] = pd.Timestamp("2022-03-14T13:18:00Z")
v2["text"] = "constructed corrected revenue decline report"
selected = filter_pit_eligible_documents(pd.concat([v1, v2], ignore_index=True))
assert selected["version_id"].tolist() == [1]
print(selected[["source_id", "version_id", "text"]])
新闻供应商是否保存原版、电话会文本是否经过事后校对,都要向具体来源核对。时点过滤不能恢复从未存档的旧版本。训练内的 TF-IDF 也不能补救把未来修订当作历史输入的错误。
贝叶斯案例同样需要模型边界:二项更新假设给定
8. Numerical Example
本节继承历史 A8-C 冻结协议 qa/a8/ch42_ch43_batch/EXPERIMENT_PROTOCOL.json 与同目录 EXPERIMENT_ADDENDUM_v1.json 下的构造结果。历史手算/代码核对和补充演示保持原身份;BIL20未重跑。
8.1 Beta-Binomial 手算实例
-
输入:先验
;观察到 次试验,成功 次。 -
后验参数:
-
后验均值与方差:
-
未来预测:
-
单次试验预测成功概率:
。 -
两次试验联合成功概率:
-
后验均值平方:
。 -
差值核对:
两者完全精确吻合。
-
8.2 正态层级收缩手算实例
本例的收益用小数表示:
-
已知超参数:先验均值
,先验标准差 ;观测标准差 。 -
精度常数:
-
组 1:
, 样本均值 。 - 收缩权重:
。 - 后验均值:
。 - 后验精度:
。 - 后验标准差:
。 - 后验预测方差:
。 - 预测标准差:
。
- 收缩权重:
-
组 2:
, 样本均值 。 - 收缩权重:
。 - 后验均值:
。 - 后验精度:
。 - 后验标准差:
。 - 后验预测方差:
。 - 预测标准差:
。
- 收缩权重:
8.3 辛普森因果分层手算实例
-
评估指标定义:本案例中的结果变量
表示次日开盘超额收益达到基准阈值的二值成功事件,其均值 代表无量纲成功概率;两概率之差乘以 100 才是百分点(Percentage Points, pp),绝非平均收益率百分比。 -
列联表数据(总样本
): - 高关注度层
(行业龙头): - 处理组
(开会): ,成功 次 ( ); - 对照组
(未开会): ,成功 次 ( ); - 层内对比:
(成功率降低 个百分点)。
- 处理组
- 低关注度层
(微盘尾部): - 处理组
(开会): ,成功 次 ( ); - 对照组
(未开会): ,成功 次 ( ); - 层内对比:
(成功率降低 个百分点)。
- 处理组
- 高关注度层
-
未调整粗差对比:
- 处理组总计:
,总成功 ( ); - 对照组总计:
,总成功 ( ); - 未调整粗差:
(表面成功率高出 个百分点)。
- 处理组总计:
-
标准化观测差;在§5.5识别假设下解释为 ATE(目标总体分布
): 未调整差为
个百分点,标准化差为 个百分点;只有在本例假定的识别条件成立时,后者才解释为目标总体 ATE。该表展示了权重引起的关联反转,本身不证明处理的真实因果方向。
8.4 TF-IDF 双文档手算对照表
基于第 6.4 节逐步推导,
| 词项 |
文档频数 |
平滑 |
未归一化 |
未归一化 |
L2 归一化 |
L2 归一化 |
||
|---|---|---|---|---|---|---|---|---|
growth |
1 | 1 | 2 | 1.000000 | 1.000000 | 1.000000 | 0.579739 | 0.579739 |
loss |
0 | 1 | 1 | 1.405465 | 0.000000 | 1.405465 | 0.000000 | 0.814802 |
profit |
1 | 0 | 1 | 1.405465 | 1.405465 | 0.000000 | 0.814802 | 0.000000 |
- 向量模长:
- 余弦相似度:
8.5 文本预测模型严格时序划分与构造结果数表
依据历史冻结协议,4个固定文本模板循环形成120条构造事件(不是120条独立新文本)。成熟训练59、验证29、测试30条各含同样4模板;只验证时间块外推,未验证新文本、新模板或新公司语言的泛化。OOV负例仅检查词表/IDF不变,不构成新文本预测能力测试。
120条构造电话会事件(CONSTRUCTED_CALL_000 至 119)执行严格时序划分。训练集标签可得时点必须严格早于验证集首个信号时点(label_available_at < next_signal_time,<);验证集标签必须严格早于测试集首个信号时点。
- 样本切分规模:
- 训练集(Train):合格样本 59 篇(索引 0..58;索引 59 样本标签在
09:30 成熟,晚于验证集首个信号 09:00,严格剪除); - 验证集(Val):合格样本 29 篇(索引 60..88;索引 89 样本标签在
09:30 成熟,晚于测试集首个信号 09:00,严格剪除); - 测试集(Test):样本 30 篇(索引 90..119)。
- 训练集(Train):合格样本 59 篇(索引 0..58;索引 59 样本标签在
- 训练词表规模:严格在 59 篇训练文本上 fit,提取独有词表 42 词。
- 验证集 Ridge 超参数调优:
(最优超参数: )
- 测试集最终评估对比:
| 评估口径 | 训练全局均值基准 | TF-IDF + Ridge 回归 ( |
经济学 / 统计学含义 |
|---|---|---|---|
| 测试集均方误差 (MSE) | Ridge 预测误差略大于朴素历史常数均值 | ||
| 相对测试集 |
相对均值基准出现负向 |
||
| 时序汇总 Spearman 秩相关 | 未定义 (常数预测零方差) | 30 个测试交易日的时序汇总排序相关性 | |
| 每日横截面 IC | 未定义 ( |
未定义 ( |
每日仅单一资产,截面协方差数学上无法定义 |
| 该结果为本章构造教学实验的负结果:在噪声收益远超文本微弱信号时,复杂模型极易在测试集上输给朴素常数均值。严禁随意填充 0 或声称交易优势。 |
8.6 否定词情感与手算词嵌入实例
人工矩阵每行分别对应 growth、profit、loss、decline、stable、steady,三列只是教学轴(强度、动量、不确定性),不是估计得到的金融因子:
先将每行除以自身范数。例如 growth 的模长为
句子先对其单位词向量取均值,再归一化;本例忽略连接词 and。以下代码给出全部向量与相似度:
from quant_course.bayesian_text import hand_embedding_matrix, negation_sentiment_scorer
vectors, similarities = hand_embedding_matrix()
print(vectors, similarities)
print(negation_sentiment_scorer("earnings performance did not improve showing no growth"))
- 否定词翻转:
句子:“earnings performance did not improve showing no growth despite aggressive restructuring”
- 固定词典的朴素一元计分(BoW 本身并不指定情感权重):识别出
"improve"() 与 "growth"(),得分 (严重误判为极度乐观!); - 否定词滑动窗口算法:
"not"激活 3 词翻转窗口,"improve"被翻转为; "no"激活翻转窗口,"growth"被翻转为,综合得分 (符合本构造句的预设负面含义)。此三词窗口规则未保证复杂否定、双重否定、讽刺或一般金融文本的准确性。
- 固定词典的朴素一元计分(BoW 本身并不指定情感权重):识别出
- 词嵌入空间余弦相似度(基于
人工指定、归一化嵌入矩阵(未训练真实语料)): growth与profit的余弦相似度为; growth与loss的余弦相似度为; - 短语
("growth and profit") 与短语 ("loss and decline") 的均值池化向量余弦相似度为 。
9. Python Implementation
核心模块为 src/quant_course 下的 bayesian_text.py。独立脚本为 code 下的 ch43_bayesian_text.py;测试为 tests 下的 test_bayesian_text.py。历史执行数量与结果见 A8-C/C19 的适用 QA 记录;BIL20只做教学修订。
9.1 执行命令与运行契约
以下命令从课程源码根目录运行。
- 执行环境:课程标准虚拟环境
.venv/bin/python。 - 独立 CLI 调用方式:
.venv/bin/python code/ch43_bayesian_text.py --out build/batches/A8-C/reader/runs/ch43_trial_01 - 安全保护:若指定的
--out目录已存在,脚本立即抛出FileExistsError并拒绝覆盖已有历史实验证据。
9.2 核心函数接口与独立运行例子
下面先传入原始60/30/30时间切片;train_text_prediction_models 在内部再次核PIT资格,并按 label_available_at < 下一块首个 signal_time 过滤训练与验证标签。索引59的标签在 < 条件。
本章已执行的文本预测路径是构造文本上的 TF-IDF + Ridge;§8.6 的 not_run / unknown 的离线台账与审查练习。三者的训练与评估身份应分别辨认。
# 1. 贝叶斯共轭与预测
from quant_course.bayesian_text import beta_binomial_posterior_predictive
res_bayes = beta_binomial_posterior_predictive(
    alpha_prior=2.0, beta_prior=2.0, successes=8, trials=10
)

# 2. 正态层级部分池化
from quant_course.bayesian_text import normal_hierarchical_partial_pooling
res_normal = normal_hierarchical_partial_pooling(
    prior_mean=0.0, prior_sd=0.02, observation_sd=0.04,
    groups=[{"n": 4, "sample_mean": 0.03}, {"n": 36, "sample_mean": 0.01}]
)

# 3. 因果分层与严格重叠性防御
from quant_course.bayesian_text import (
    compute_stratified_ate,
    PositivityViolationError,
    generate_causal_dataset,
)
df_causal = generate_causal_dataset()
ate_res = compute_stratified_ate(
    df_causal, z_col="Z", t_col="T", y_col="Y",
    target_p_z={"high": 0.5, "low": 0.5}
)

# 4. PIT 文本过滤与训练窗 TF-IDF
from quant_course.bayesian_text import (
    filter_pit_eligible_documents,
    TextFeaturePipeline,
    train_text_prediction_models,
)
from quant_course.bayesian_text import generate_constructed_text_dataset
raw_docs_df, _ = generate_constructed_text_dataset()
eligible_docs = filter_pit_eligible_documents(raw_docs_df, cutoff_col="signal_time")
train_df, val_df, test_df = (
    eligible_docs.iloc[:60], eligible_docs.iloc[60:90], eligible_docs.iloc[90:]
)
model_res = train_text_prediction_models(train_df, val_df, test_df, alpha_grid=[0.1, 1.0, 10.0])
10. Visualization
历史冻结的 CONSTRUCTED 教学运行生成并持久化了 5 幅图表;本轮复用原图至 course/zh/chapters/ch43/figures/root_r3/。
图 43-1: 贝叶斯共轭更新与正态层级收缩
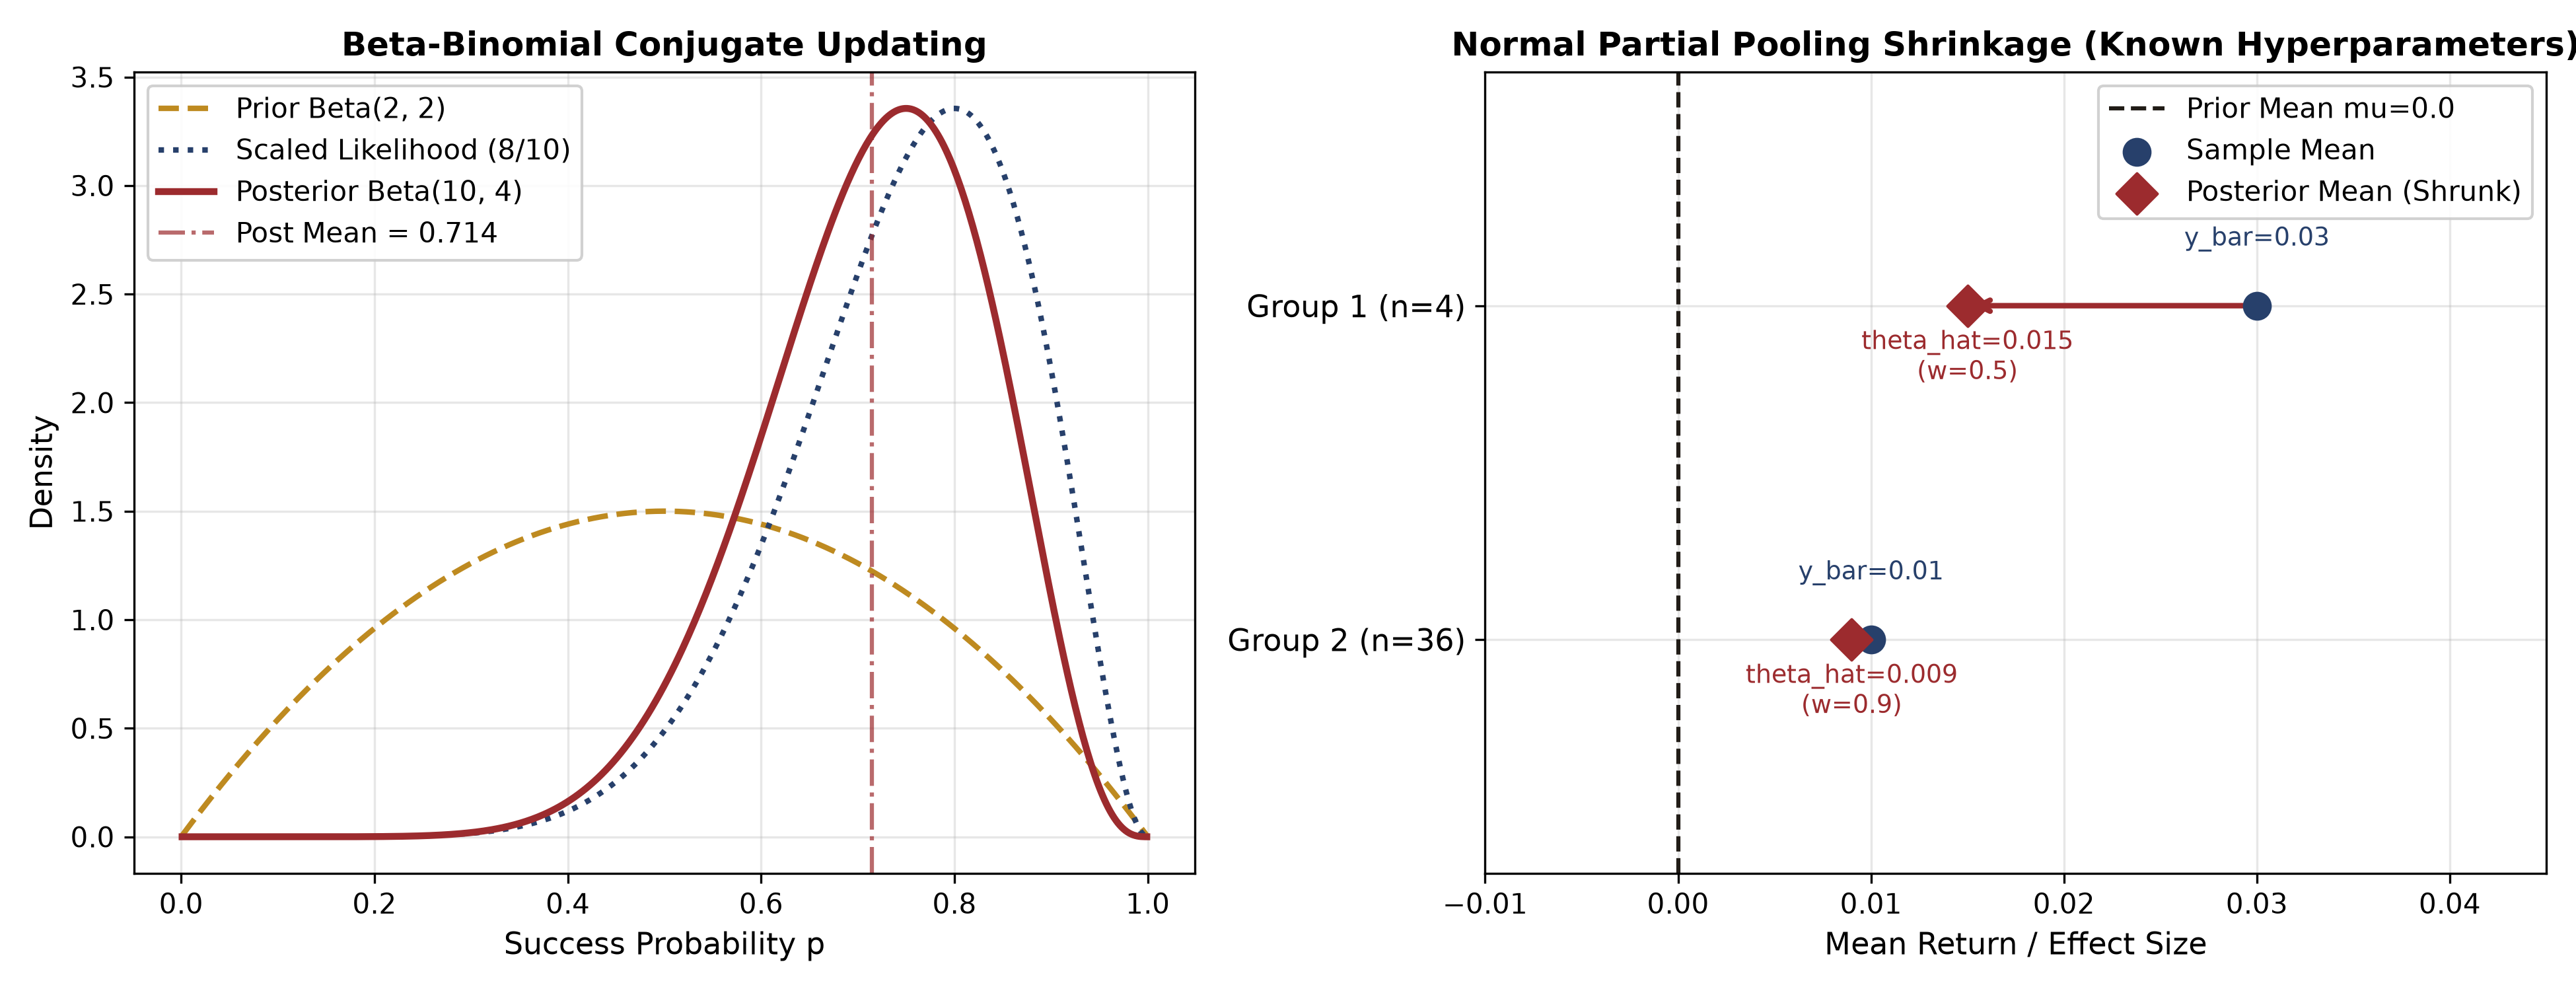
图 43-1 说明:
- 左图(Beta-Binomial 共轭更新):横轴为二项成功概率
,纵轴为概率密度(缩放似然只用于形状比较,并非参数的概率密度)。金色虚线为先验 ,蓝色点线为缩放后的似然函数(10 投 8 中),红色实线为后验分布 。后验均值(红色点划线 )落在先验均值 与极大似然估计 之间,清晰展示了数据的贝叶斯折衷。 - 右图(正态层级部分池化收缩):横轴为组均值收益率,纵轴为各资产群组。黑色虚线为全市场先验均值
。蓝色圆点为组样本均值 ,红色菱形为收缩后的后验均值 。组 1(样本容量 )被强烈收缩了 (箭头由 指向 );组 2(样本容量 )仅被温和收缩 (由 指向 )。
图 43-2: 辛普森悖论与因果标准化对比
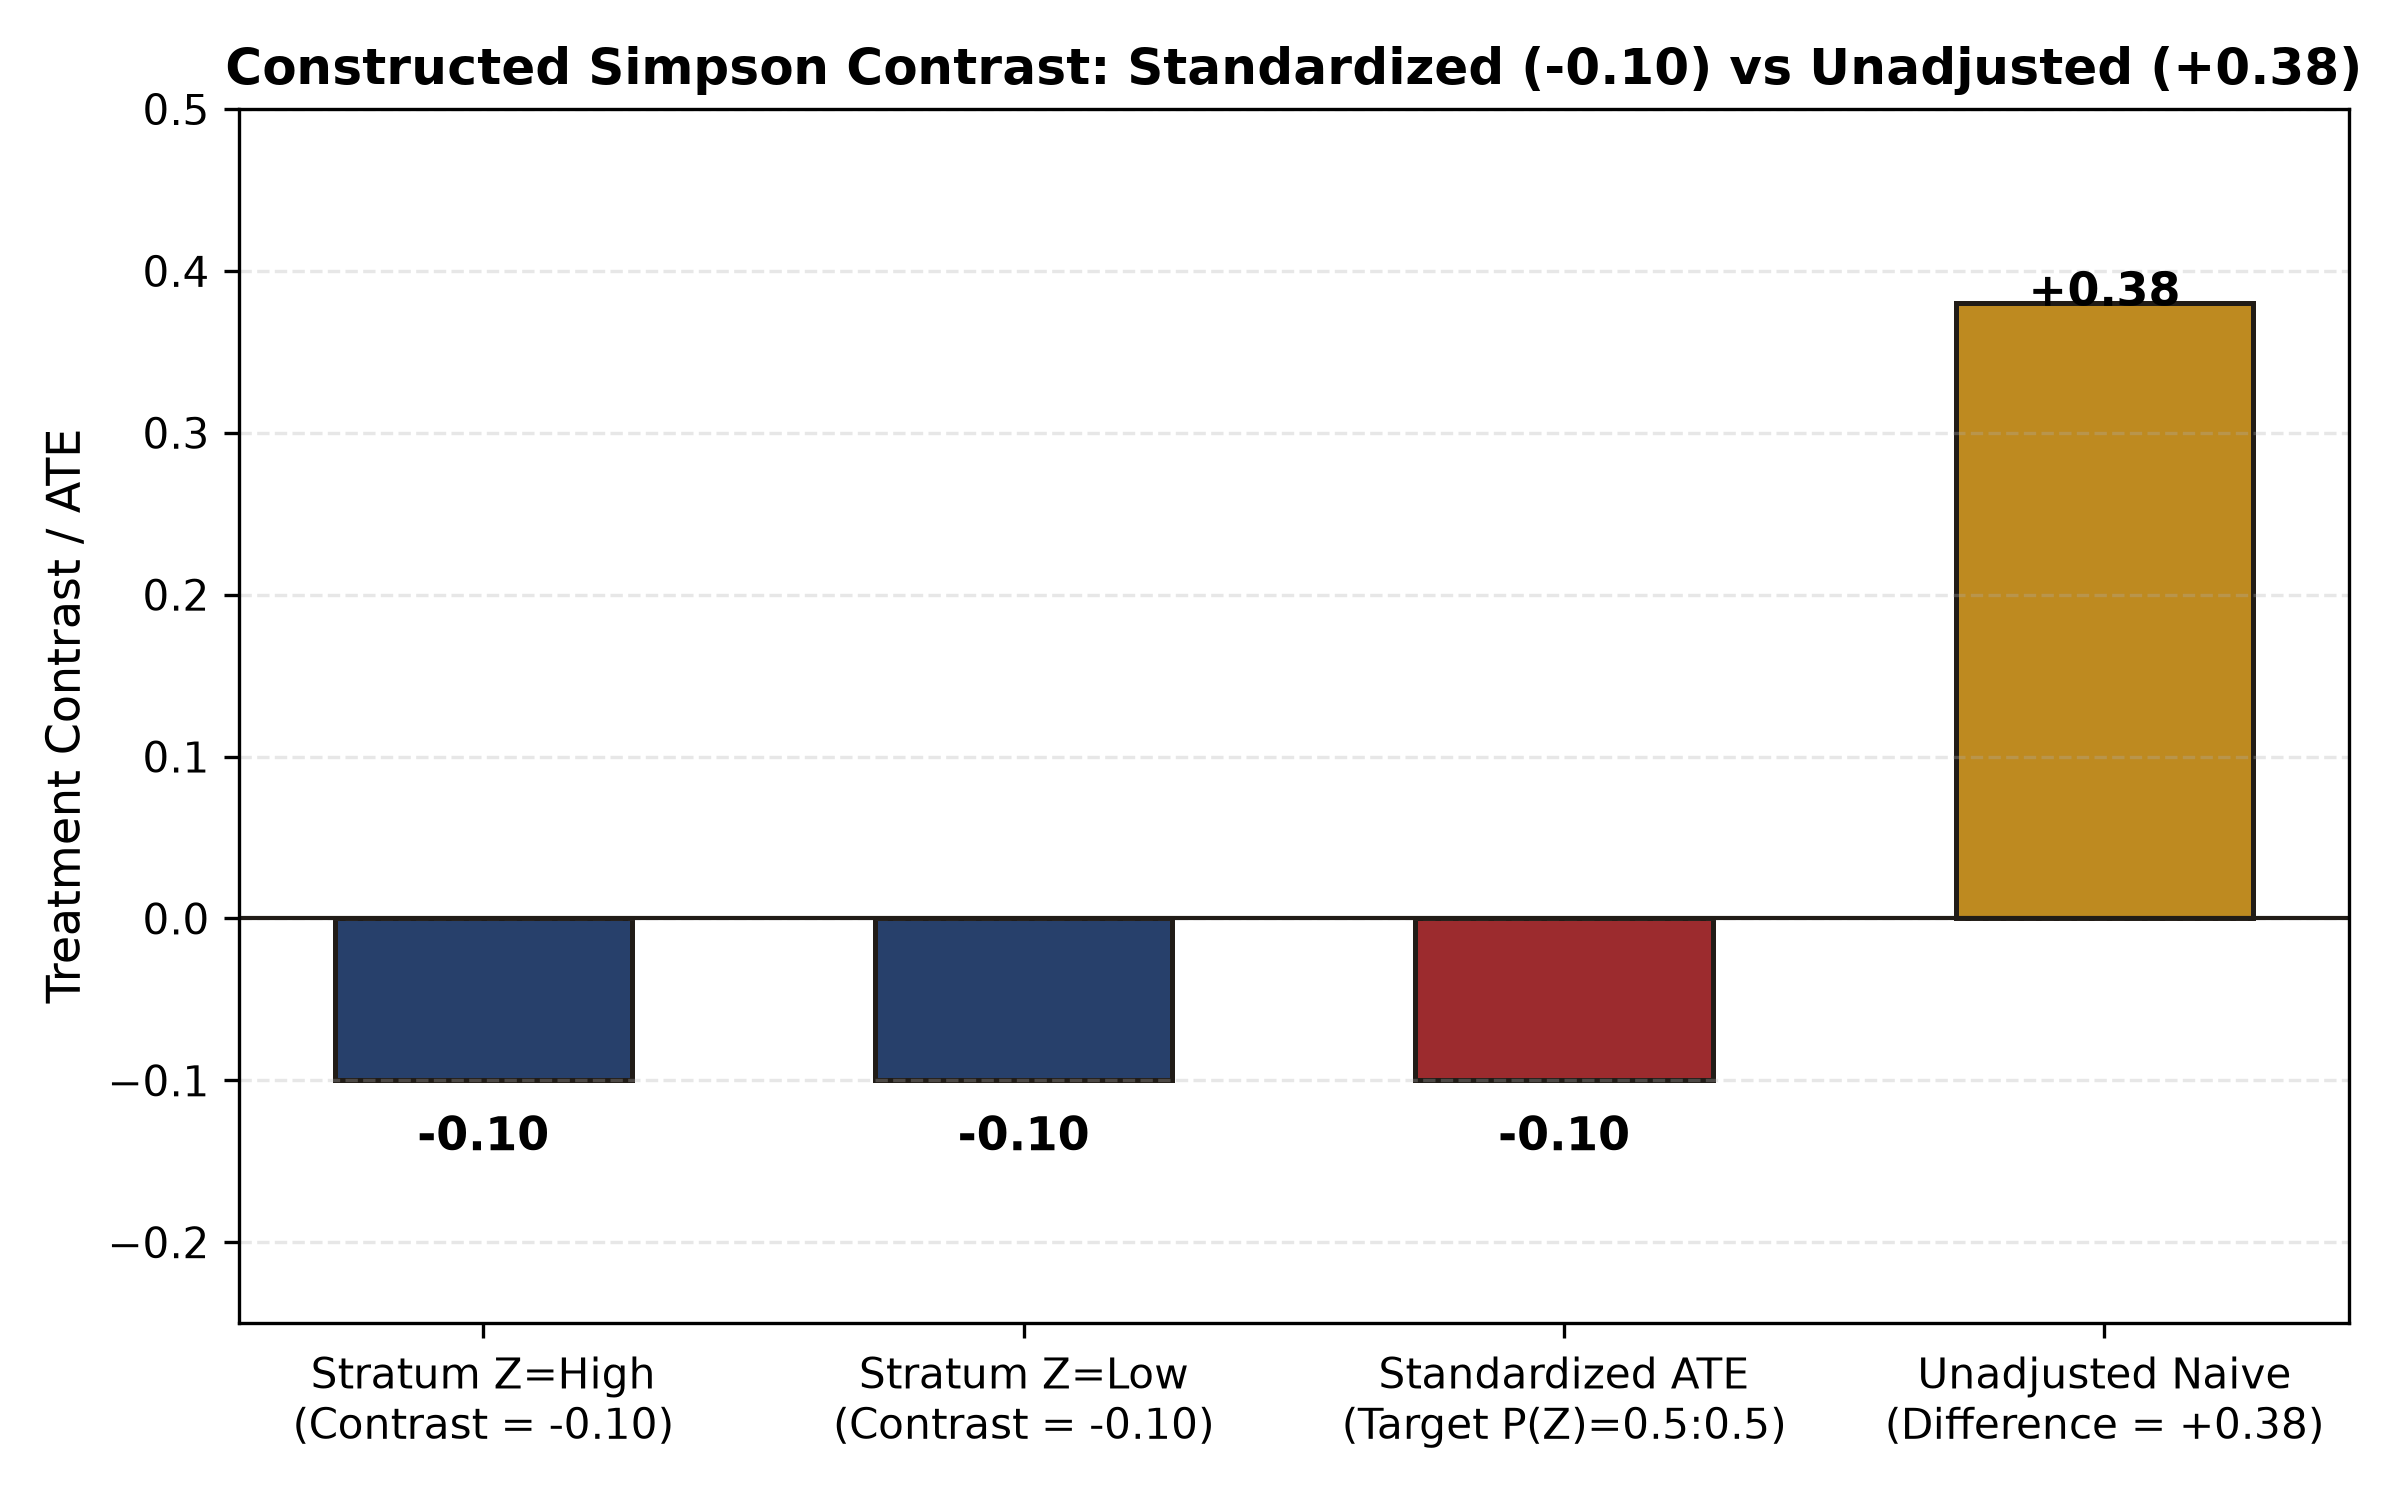
图 43-2 说明:
- 横轴:不同分层与评估口径;纵轴:二值成功概率差(0.10 对应 10 个百分点)。
- 前两根深蓝色柱子代表各层内的观测概率差,高关注度层与低关注度层内开会组相比未开会组均降低了
个百分点( )。 - 第三根红色柱子为按目标人群
标准化后的观测差( )。在所列识别假设下它可解释为目标ATE;柱形图不验证这些假设。 - 第四根金色柱子为未标准化关联差(
)。比较四根柱子可看到分组权重造成的方向反转。
图 43-3: 盘后电话会时点与 PIT 执行契约示意图
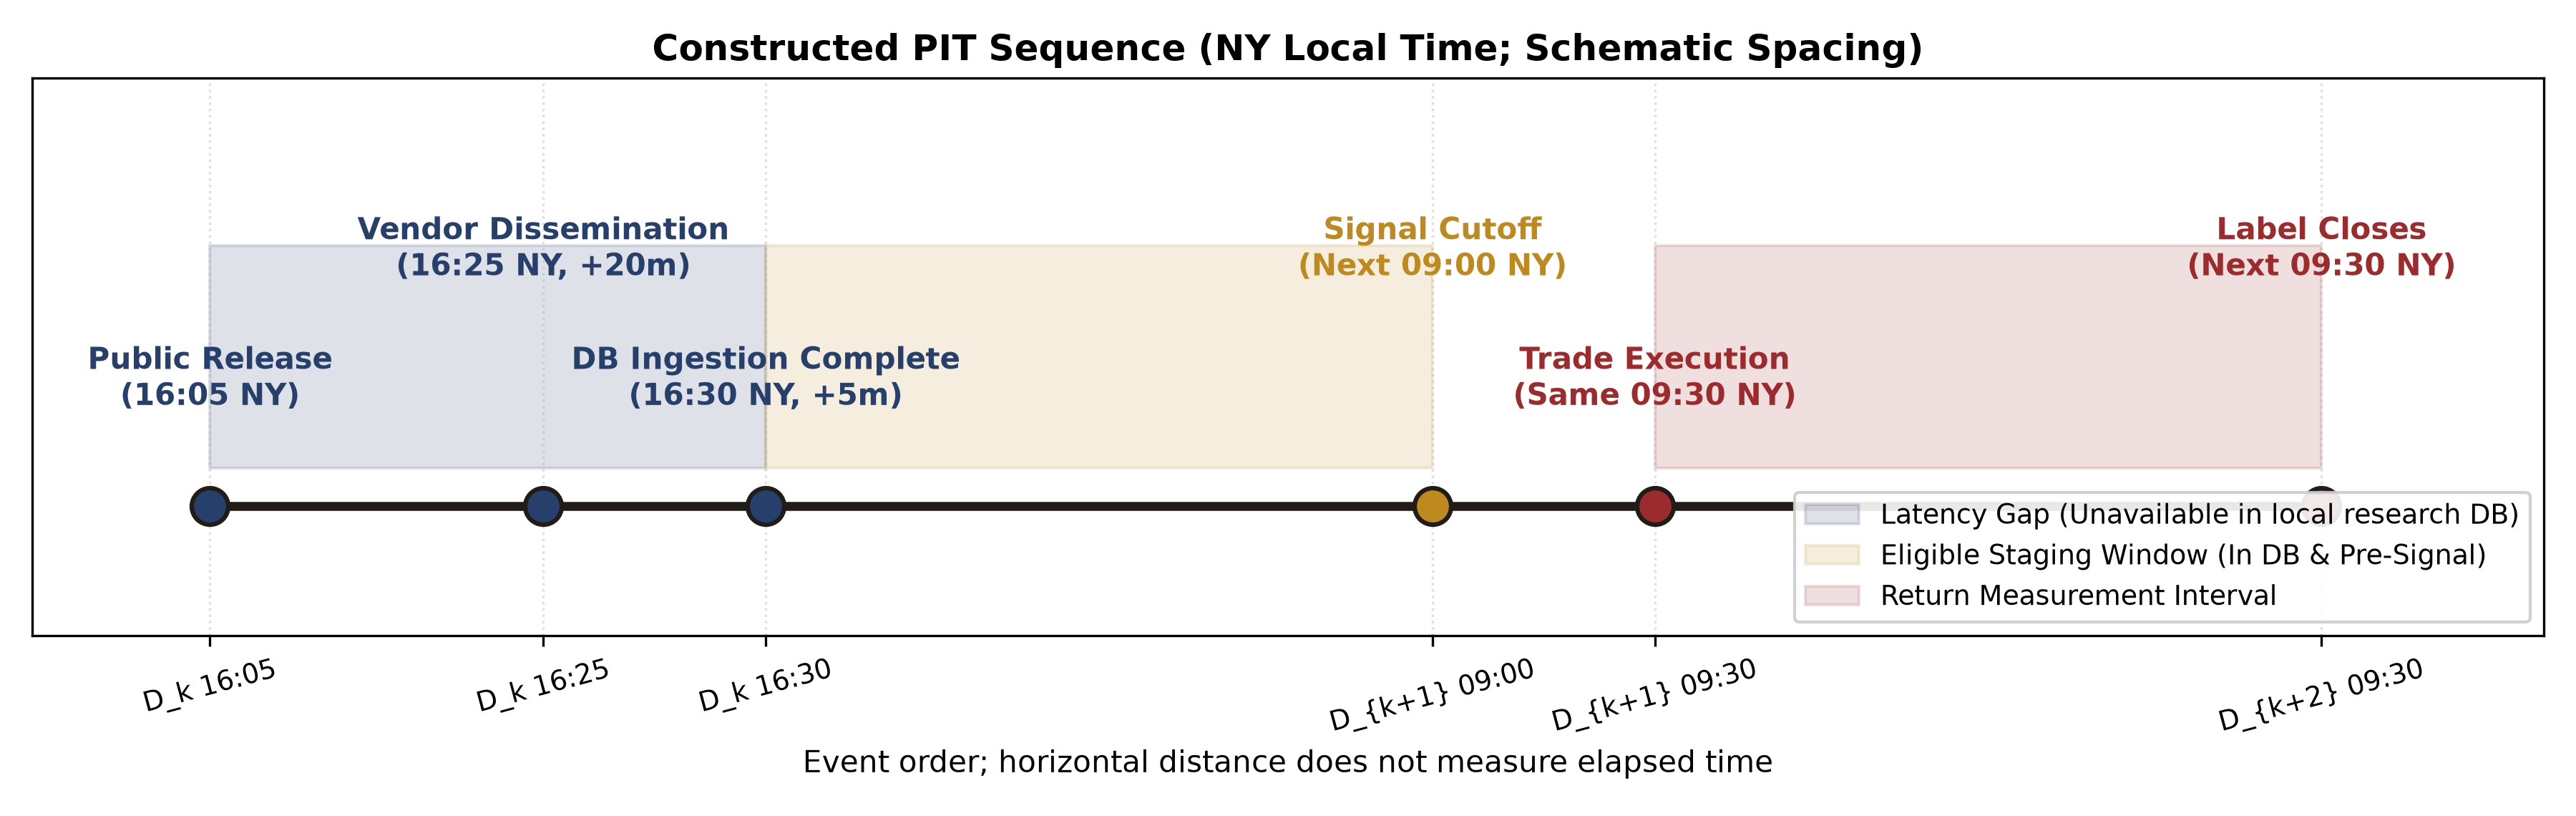
图 43-3 说明:
- 横轴:事件顺序(美东本地时间;间距不代表经过时长,UTC 转换另见 §7.4/43-E05);纵轴:示意高度。
- 蓝色阴影区(
16:05 至 16:30)标示 25 分钟数据分发与内部数据库入库延迟窗口。在此窗口内,本地量化研究数据库尚不可用该数据(尽管事件已于 16:05 在外部物理世界公开)。任何早于 16:30 的本地信号生成逻辑均属于前瞻泄漏。 - 金色阴影区(
16:30 至 09:00)为数据已入库且早于开盘信号的合规计算窗口。 - 红色阴影区(
09:30 至 09:30)为开盘成交后的 1 日持仓收益测量区间,标签在该区间终点才完全成熟。
图 43-4: 测试集预测表现对比(低信噪比实态)
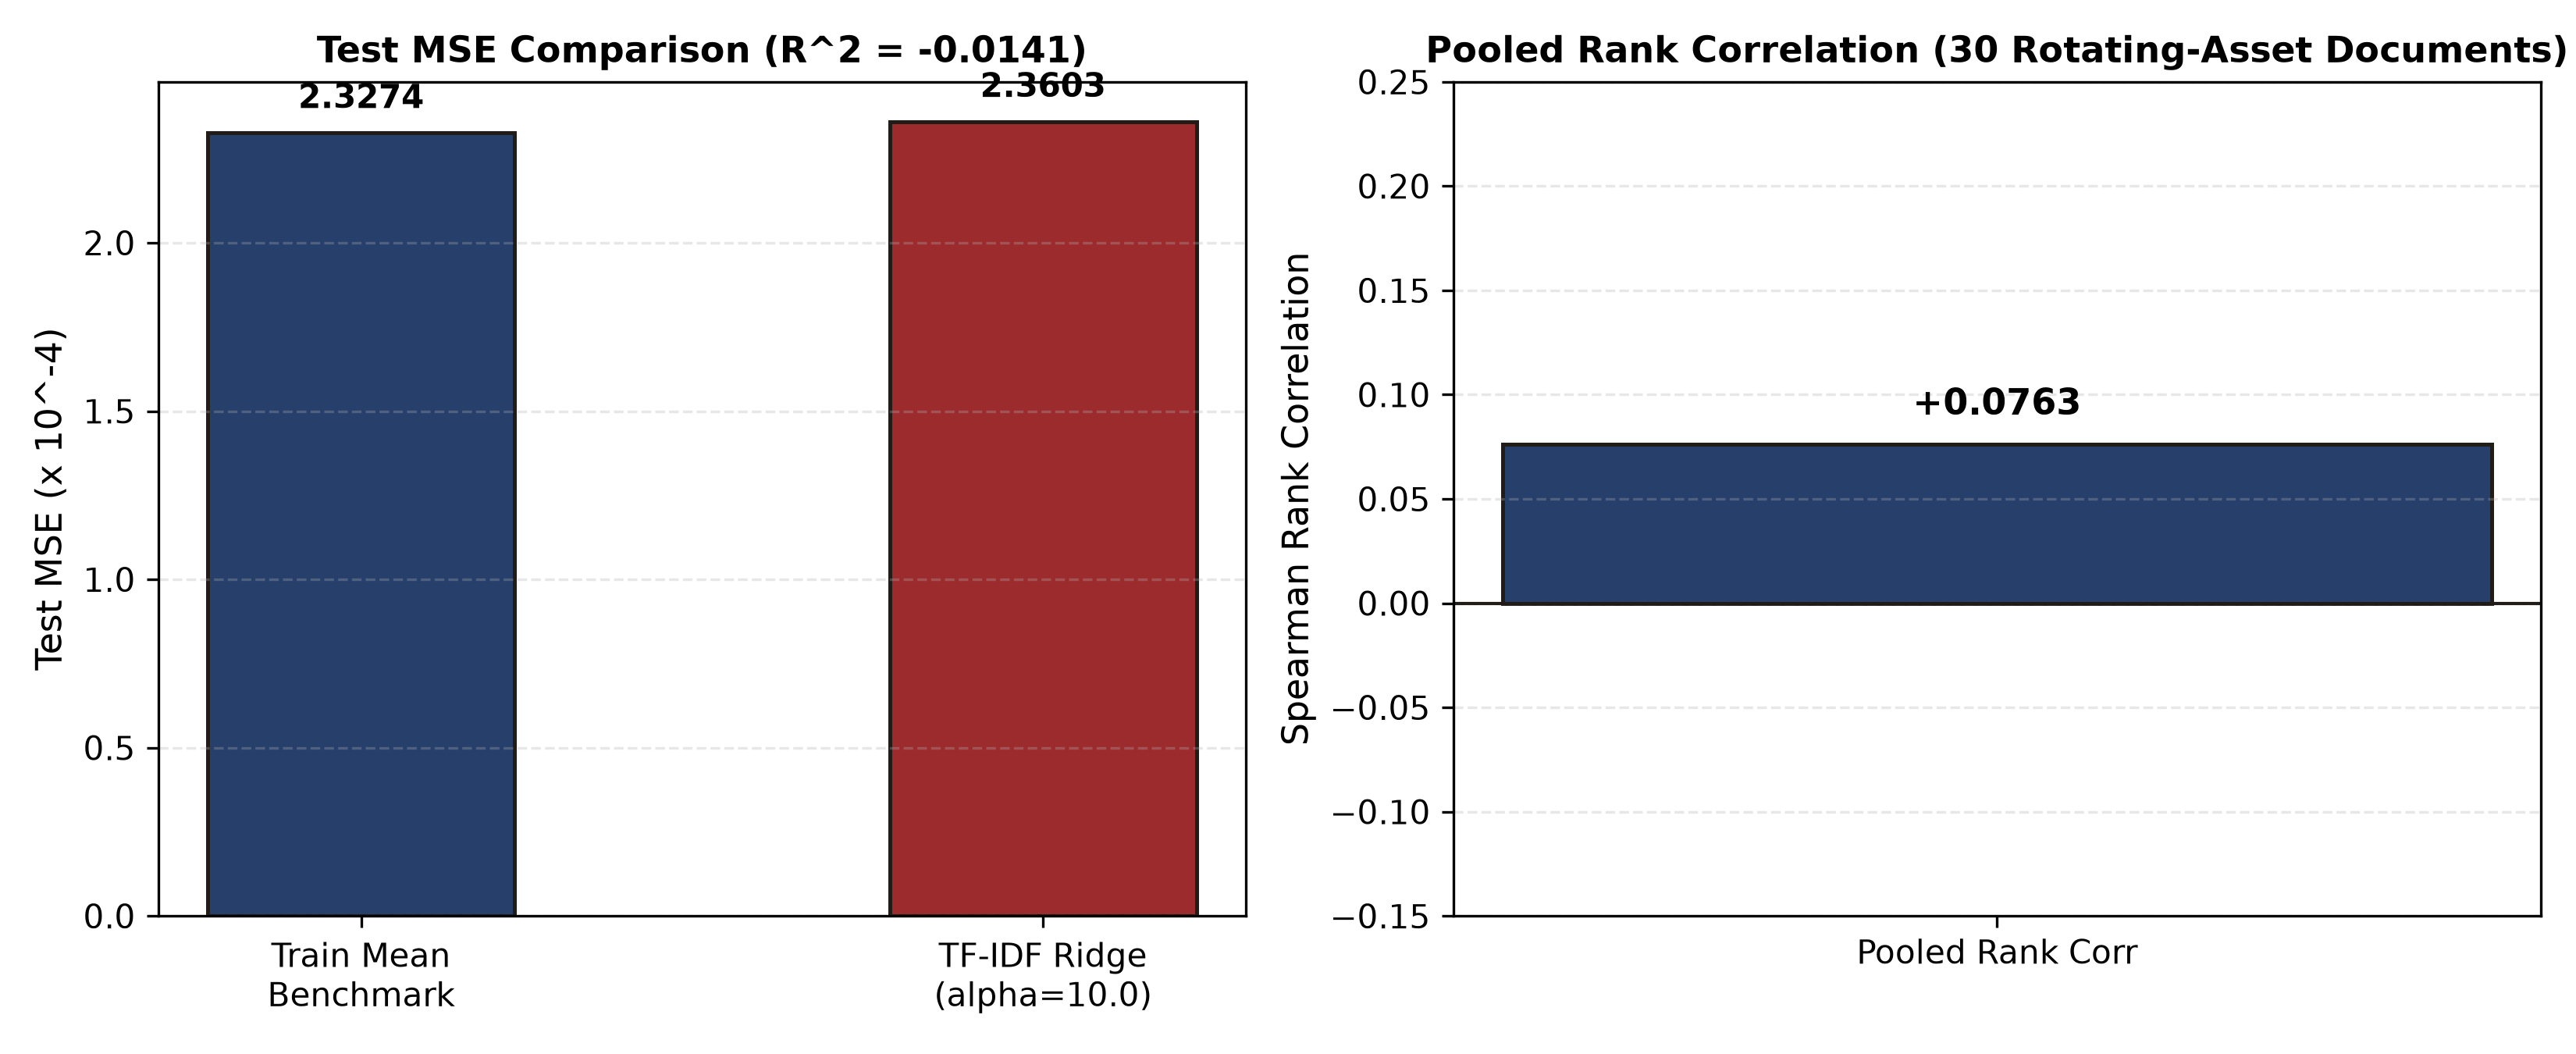
图 43-4 说明:
- 左图:测试集均方误差(MSE
),训练全局均值基准为 ,TF-IDF + Ridge 回归为 ,测试集相对 为 。 - 右图:测试集 30 个交易日的时序汇总 Spearman 秩相关系数为
。明确指出:由于数据集中每个交易日仅有单一资产样本( ),每日横截面 IC 在数学上无法定义;训练全局均值基准输出常数预测,其方差为 0 因而秩相关同样未定义。 - 观察结论:在本章构造数据中,强噪声(
)远超弱文本信号( )。该次样本的汇总相关性为正,但不足以证明模型学到了可重复的排序关系,但在绝对均方误差上并不能击败朴素均值。这构成了典型的金融机器学习负结果,警示量化研究员不可脱离实际信噪比盲目相信文本因子的盈利能力。
图 43-5: 因果混杂与对撞有向无环图(DAG)
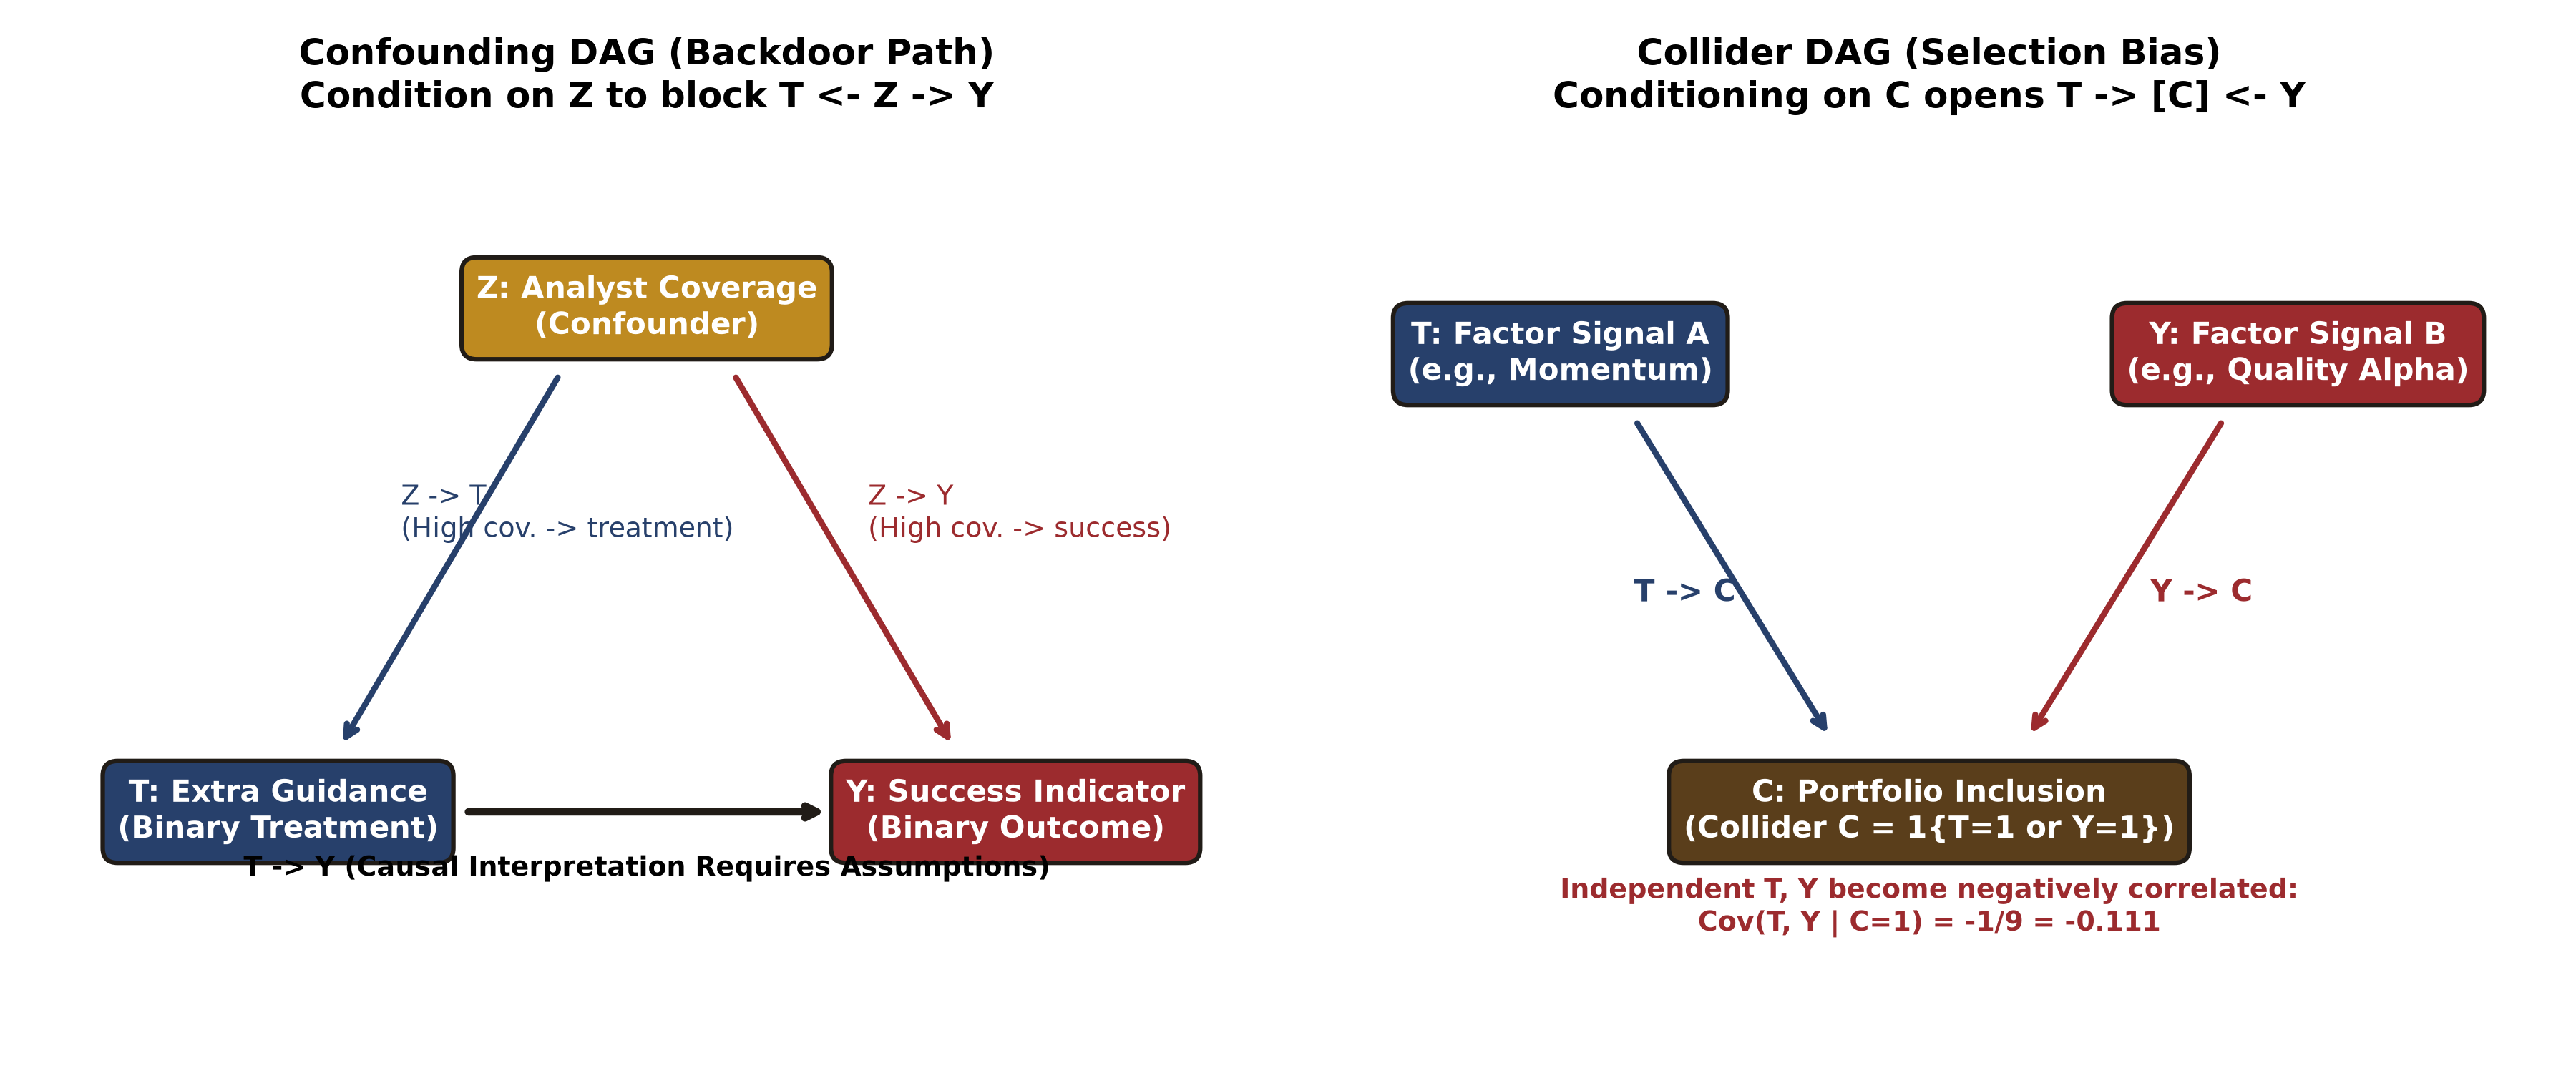
图 43-5 说明:
- 左图(混杂 DAG 与后门路径):
- 节点定义:
为混杂变量(分析师关注度), 为二值处理变量(是否提供额外指引), 为二值成功指标。 - 有向边说明:
(构造情境中高关注度公司更倾向于提供额外指引); (构造情境中高关注度公司具有更高的基准达标率); 表示待识别的因果路径;本表标准化差为 ,只有假设成立时才解释为概率效应。 - 后门路径阻断:后门路径
导致了未经调整的虚假正相关( )。在因果识别中,对混杂节点 进行分层标准化(加框控制)阻断了该路径,在已陈述识别假设下解释标准化处理效应。
- 节点定义:
- 右图(对撞 DAG 与样本选择偏差):
- 节点定义:
为动量因子信号, 为质量 Alpha 因子信号, 为投资组合入选指标(对撞节点,定义为 )。 - 有向边说明:
与 。两个因子在全市场无条件独立( )。 - 对撞偏误产生机制:当研究员错误地将回测池限定在“已入选组合的持仓池”(条件限制
)时,对撞路径被打开,在原本独立的因子之间诱发出虚假的负相关 。
- 节点定义:
11. Real Market Example
真实数据应用中,非结构化文本数据的采选受到严格的技术接口、覆盖偏误与法律授权约束。
11.1 真实监管接口与时点审查边界
SEC 官方 API 页面说明公开申报接口与处理延迟。本轮未核对单个申报原文、字段时区或电话会原文,因此此处只说明接口线索,不能作为真实文本 PIT 或许可证明。
- 通用 API 接口与物理时延:量化工程在接入官方数据时,必须区分物理发生时点与本地入库时点。任何在本地数据库完成解析与落库之前的外部文本,在系统时钟到达入库完成时刻之前均属于“不可用”状态。
- 日历与交易规则:真实量化生产系统必须绑定交易所实际交易日历(如 NYSE 休市日与半日交易)。本章采用的合成工作日日历(Synthetic Weekday Calendar)仅用于剥离假期复杂度以凸显教学主线,不可直接等同于包含复杂休市规则的实盘日历。
11.2 替代数据许可、覆盖范围与样本选择偏差
在替代数据(Alternative Data)采选中,量化团队必须警惕两项重大非技术风险:
- 公开可访问性 vs 法律授权许可:
公开网页上的文本具有“公共可访问性”(Public Accessibility),但这绝不等于具备合规的商业数据抓取、特征提取、模型训练或衍生特征交易再分发许可(Licensing & Redistribution Rights)。使用未获授权的文本训练策略,面临严重的合规与法律追索风险。本教学批次明确记录许可缺口:当前未提供全量商用授权的真实电话会速记语料,因此本章采用带有
CONSTRUCTED_CALL_前缀的构造文本。 - 供应商覆盖偏误诱发的选择偏差(Selection Bias):
设某另类数据供应商提供高频电话会情绪特征,但构造一个覆盖案例:该供应商对高分析师关注度(大市值)公司的覆盖率为
,而对低关注度(中小盘)公司的覆盖率仅为 。若量化研究员直接在“供应商有数据”的样本集(标记为入选指示变量 )上进行因子有效性检验,由于关注度 同时影响了数据可得性 和公司基本面 , 改变了样本组成。若总体高、低关注度各占一半,覆盖后高关注度占 ;基准成功率分别为 0.8、0.2 时,总体均值为 0.5,覆盖样本均值为 0.74。这个 0.24 差异来自选择,不是新因子的效应。仅有 与 不能把 称为对撞节点;对撞还需两个独立原因共同指向 。
12. Common Mistakes
误区 1:混淆因果重叠性(Positivity)与正态性(Normality)
- 错误理解:认为“因果识别要求所有特征服从正态分布”。
- 事实纠正:正值性/重叠性(Positivity)指的是在每一个混杂分层内部,处理组与对照组都有非零的采样概率:
。 - 诊断片段(不独立运行):
# 错误做法:某层没有对照组,直接填充 0 算差值 diff_stratum = mean_t1 - 0.0 # 严重破坏潜在结果识别! - 对应修复片段:
if n_t1 == 0 or n_t0 == 0:
    raise PositivityViolationError(f"Positivity violated in stratum {z}!")
有限样本某层缺一处理组只是样本支持/可计算性防线,不能单独证明总体处理概率为0或1;目标总体有正权重但整层未出现,同样不能用静默漏项或重归一处理。
误区 2:在全样本上 fit 词表与 IDF 导致跨期信息泄漏
- 错误理解:认为“文本无监督,提取 TF-IDF 词表不看未来标签,所以在全样本上 fit 不算泄漏”。
- 事实纠正:测试集的新词频如果提前进入训练集的 IDF,会改变训练特征的尺度;更严重的是,未来重大突发事件的特有词汇(如某项专利名、重组代号)提前进入词表,使模型在历史时间点获得了“未来重要性”的先验信息。
- 修复规则:词表与 IDF 必须且只能在训练集 fit,对验证集与测试集执行 transform,未见词(OOV)直接忽略。
误区 3:将大语言模型的预训练截止日期等同于历史 PIT 资格
- 错误理解:模型训练语料截止到 2023 年 12 月,因此用它来对 2022 年的新闻打分是严格 PIT 的。
- 事实纠正:这个假设截止日晚于历史信号,存在吸收后续报道的可能。不能只凭截止声明确认具体公司已被记忆,也不能由此自动认定每个输出都受污染;应保留模型、语料时点证据与对照实验。
13. Quant Research Application
13.1 完整量化投研设计:盘后文本到次日执行
构建基于业绩电话会的事件驱动信号提取流程:
- 事件监听:美东时间 16:00 盘后开始监听申报流水。16:05 会议结束,16:25 第三方供应商生成速记稿并打上
available_at,16:30 本地量化系统完成入库并打上ingested_at。 - 时点资格检验:在次日美东时间 09:00(信号生成时点),执行
filter_pit_eligible_documents。任何入库时间晚于 09:00 或修订时间晚于 09:00 的版本一律剔除。 - 拟议扩展:滚动前向拟合(Purged Walk-Forward):未来可按另行冻结的协议以滚动窗口拟合 TF-IDF 与 Ridge。本章实际执行的是固定 train/val/test 时间块,不是已执行的滚动验证。注意:窗口最后一日若标签尚未到期(
label_available_at >= next_signal_time),必须予以严格剪除(Purge)。 - 开盘信号输出:在次日 09:00 输出各标的的连续预测收益率
。
13.2 预测专属接口与下游执行系统规约(Prediction-Only Interface Spec)
本章严格限定在信号生成与特征预测阶段(Prediction-Only)。在单资产时序轮换的数据构造下,不能简单对连续轮换不同资产的预测值符号差计算换手率或扣除交易成本(因为离散单资产跨期符号翻转并不构成同一投资组合的连续持仓账本)。下游执行系统须对接课程标准投资组合与执行账本(如第 29 章标准化接口):
- 下游账本必需字段:
doc_id,trade_time,asset_id,target_return_pred,allocated_weight,execution_price,one_way_fee_bps。 - 边界与责任隔离:文本预测模型仅对时点合规的文本输出
; one_way_fee_bps / 10000才是既有回测函数的fee_rate;这些字段是拟议适配层,而不是旧函数参数。还需完整资产价格面板和持仓政策。下游系统负责将映射为多资产目标权重(考虑持仓集中度与风险预算)、结合市场冲击模型测算滑点摩擦,并在满足借券约束的前提下生成完整投资组合 PnL 账本。
14. Chapter Summary
- 推断的本质:贝叶斯推断用概率分布表示认知的不确定性。Beta-Binomial 更新展现了数据对先验的拉动;未来两期联合预测具有由参数不确定性引起的状态相关性(协方差等于后验方差)。正态层级模型在已知超参数下展示了部分池化(Partial Pooling)的自适应收缩能力。
- 因果与统计的分野:统计相关不等于因果效应。混杂因素通过改变处理分配的边际比例诱发辛普森悖论。只有在一致性、条件可交换性、严格正值性与无干扰假设下,通过分层标准化才能恢复真实的 ATE。
- 文本与 PIT 的工程防线:另类数据与大语言模型研究必须筑牢时点防线。词表必须在训练窗内隔离拟合;电话会必须接受入库与修订时间戳的严格审查;大模型离线台账必须记录提示词哈希与预训练语料截止边界。低信噪比下尊重负结果,是成熟量化研究员的基本素养。
15. Exercises
- 43-E01(Beta-Binomial 共轭后验与后验预测):设参数
,观察到 次试验中 次成功。求后验参数、后验均值、后验方差;推导未来单期预测成功率及未来两期联合成功率 ;说明为何 。 - 43-E02(正态层级部分池化计算):设先验均值
,先验标准差 ,观测标准差 。组 1 有 个观测,均值为 ;组 2 有 个观测,均值为 。计算两组的收缩权重、后验均值、后验精度与未来新观测的后验预测方差。 - 43-E03(辛普森混杂因果识别):设混杂变量
,目标总体分布 。根据第 8.3 节列联表,计算未调整差与标准化观测差,列出何种识别假设下后者才可解释为 ATE,并解释符号反转的数理原因。 - 43-E04(因果正值性假设边界):解释因果推断中的正值性(Positivity)假设。设
在目标总体有正权重;若该层所有个体均接受了处理( ),因果 ATE 是否可识别?为什么? - 43-E05(时点日历夏令时转换):某上市公司于 2022 年 3 月 14 日(美股夏令时切换次日)盘后 16:05 美东时间发布财报,请写出其对应的 UTC 时间戳,并推演若存在 25 分钟入库延迟,其最早可在何时用于 09:00 美东时间的信号生成。
- 43-E06(否定词与词袋缺陷):解释为什么本章固定正负词典对一元词袋(Unigram Bag-of-Words)的计分,在遇到短语
"did not improve showing no growth"时会将其判定为高度积极?应如何设计算法修复?
16. Programming Exercises
- 43-P01(实现 Beta 预测协方差核对):编写函数
test_predictive_covariance(),输入任意合法的,断言数值计算得到的 与 在浮点精度内完全相等。 - 43-P02(实现因果正值性防御):编写函数
compute_stratified_ate_safe(),在输入数据集的某个分层缺乏对照组或实验组时,抛出专门定义的PositivityViolationError,并附带违背分层的名称与样本计数。 - 43-P03(实现 PIT 文本版本选择器):编写函数
filter_pit_eligible_documents(),输入包含多版本修订记录的 DataFrame,输出在给定信号时间戳前最新且合规的唯一样本。 - 43-P04(训练窗独立 TF-IDF 特征管线):实现
TextFeaturePipeline,仅允许在训练集上调用fit(),在测试集包含未见新词(OOV)时,断言调用transform()后内部词表与 IDF 不发生任何变异。
17. Challenge Problems
- 43-C01(对撞物偏误与样本选择偏误):设
相互独立且均服从 ,不存在两者间因果作用;准入规则 对应 。请推导并编程证明:当研究员错误地按 进行样本筛选时,会在 与 之间人为诱发出虚假的负相关性。这在量化选股(如仅在标普 500 成分股内选股)中有何警示? - 43-C02(大语言模型离线审查台账与不可复现性防御):设计一套可审计的大语言模型离线教学台账。写出 JSON Schema 规范,包含提示词模板版本、SHA-256 哈希、模型预训练截止日期与真实历史信号日期的时差校验逻辑,说明同时改输入与摘要为何可通过本地检查,并列出独立可信基准的作用及防范非确定性API输出的三大工程红线。
- 43-C03(模板实验的泛化边界):120条事件只含4个固定模板,成熟训练/验证/测试各含这4个模板。有效时点切分验证了什么?能否把OOV词表不变测试或30个测试事件解释为新文本泛化证据?
18. 完整习题答案(Complete Solutions)
43-E01 完整解答
-
后验参数计算:
-
后验均值与方差:
-
单期与两期预测:
- 单期预测:
。 - 两期预测:
。
- 单期预测:
-
不等性机理: 后验均值平方为
。
差值。
原因:给定参数时,两次试验独立。对共同且不确定的 积分后,预测协方差为 ,因此两次试验在边际预测分布下正相关。随后若观察到第一次新试验成功,才会更新 的后验,并提高第二次试验给定这一新结果的条件预测。
43-E02 完整解答
- 组 1 计算:
- 先验精度
,观测方差 。 - 样本精度
。 - 后验精度
。 - 收缩权重
。 - 后验均值
。 - 后验预测方差
。
- 先验精度
- 组 2 计算:
- 样本精度
。 - 后验精度
。 - 收缩权重
。 - 后验均值
。 - 后验预测方差
。
- 样本精度
43-E03 完整解答
- 未调整差异:
, 。
差异。 - 分层对比与标准化 ATE:
层: 。
层: 。
标准化。 - 数理原因:处理组样本有
分配在高胜率层 ,而对照组样本有 分配在低胜率层 。两组的层构成不同造成关联反转;只有在一致性、条件可交换性、目标支持正值性和 SUTVA 等假设下,标准化差才可解释为负向 ATE,数表本身不检验这些假设。
43-E04 完整解答
- 正值性定义:要求在所有满足
的分层中, 。 - 不可识别原因:若某层
,则该层所有个体均接受了处理, 。这意味着在数据中完全不存在对照组样本,潜在结果 在数学上没有任何可观测对应项(分母为零)。如果不引入强参数外推假设,非参数因果 ATE 在理论上是不可识别的。
43-E05 完整解答
- 时区转换:2022 年 3 月 13 日美股进入夏令时(EDT,UTC-4)。2022 年 3 月 14 日 16:05 EDT 转换至 UTC 为
2022-03-14 20:05:00 UTC。 - 延迟与信号:
-
供应商分发延迟 20 分钟
; -
内部数据库入库延迟 5 分钟
(即美东时间 16:30 EDT)。 -
次日信号时间为美东时间 09:00 EDT(即
2022-03-15 13:00:00 UTC)。 -
全时点 UTC 日期与时间绝对比较:
时间裕量为 16 小时 30 分钟。 比较必须包含完整的 UTC 年月日与时间戳(如
2022-03-14 20:30:00 UTC与2022-03-15 13:00:00 UTC)。若粗心忽略跨日日期,直接按日内时间字面量比较20:30 < 13:00,会错误判断为不可用!系统必须使用带有时区感知的绝对时间戳对象比较。
-
43-E06 完整解答
- 一元词袋缺陷:词袋模型对各词项分别作无序频数计数,不假设词项统计独立,丢失了句法修饰与词序关系。本例固定情感词典给
"improve"与"growth"指定正面极性权重。而否定词 "not","no"若未被词表覆盖或仅作为停用词被过滤,朴素词袋累加得到,将强负面语义完全颠倒为高度乐观。 - 本例可用的修复方向(均不保证一般语言准确性):
- 方案 1:引入 n-gram 特征(Bigrams),提取
"not_improve","no_growth"作为独立复合词,赋予负向极性; - 方案 2:基于滑动窗口(如 3 词窗口),当扫描到否定词(
"not","no","never")时,动态激活翻转标志,将其后序修饰的情感词极性直接乘以。
- 方案 1:引入 n-gram 特征(Bigrams),提取
43-P01 参考实现
import numpy as np
from quant_course.bayesian_text import beta_binomial_posterior_predictive

def verify_predictive_covariance(
    alpha: float, beta: float, successes: int, trials: int
) -> dict[str, float]:
    """Verify that predictive covariance equals posterior variance for arbitrary legal parameters."""
    res = beta_binomial_posterior_predictive(
        alpha_prior=alpha, beta_prior=beta, successes=successes, trials=trials
    )
    cov = res["joint_two_successes"] - (res["single_predictive_mean"] ** 2)
    var_post = res["posterior_variance"]
    assert np.isclose(cov, var_post, atol=1e-12), f"Covariance {cov} != Variance {var_post}"
    return {
        "alpha_post": res["alpha_post"],
        "beta_post": res["beta_post"],
        "predictive_covariance": cov,
        "posterior_variance": var_post,
    }

# 调用验证:支持任意合法超参数
test_case_1 = verify_predictive_covariance(2.0, 2.0, 8, 10)
test_case_2 = verify_predictive_covariance(1.0, 3.0, 5, 20)
assert np.isclose(test_case_1["predictive_covariance"], 2.0 / 147.0)
43-P02 参考实现
本参考函数在 target_p_z=None 时以经验层分布为目标;共享核心 compute_stratified_ate 的默认目标是 high/low 各0.5,二者不是同一默认总体。显式传入同一合法权重后才对齐。权重有限、非负且总和为1;正权重目标整层缺失须报错,不能丢弃后重归一。下列检查防止样本支持缺失,不能证明总体正值性或可交换性。
import pandas as pd
from quant_course.bayesian_text import PositivityViolationError

def compute_stratified_ate_safe(
    df: pd.DataFrame,
    z_col: str = "Z",
    t_col: str = "T",
    y_col: str = "Y",
    target_p_z: dict | None = None,
) -> dict:
    """Compute stratified ATE with strict positivity defense raising custom exception."""
    import math
    if df.empty:
        raise ValueError("Input DataFrame is empty.")
    for col in (z_col, t_col, y_col):
        if col not in df:
            raise KeyError(col)
    if df[[z_col, t_col, y_col]].isna().any().any():
        raise ValueError("Causal variables cannot be missing.")
    if not set(df[t_col]).issubset({0, 1}):
        raise ValueError("Treatment must be binary.")
    if not all(math.isfinite(float(y)) for y in df[y_col]):
        raise ValueError("Outcomes must be finite.")
    strata = df[z_col].unique()
    if target_p_z is None:
        p_z = {z: len(df[df[z_col] == z]) / len(df) for z in strata}
    else:
        p_z = dict(target_p_z)
    if not p_z or any(not math.isfinite(float(p)) or not 0 <= p <= 1
                      for p in p_z.values()):
        raise ValueError("Target weights must be finite probabilities.")
    if not math.isclose(sum(p_z.values()), 1.0, rel_tol=0, abs_tol=1e-12):
        raise ValueError("Target probabilities must sum to one.")
    for z, p in p_z.items():
        if p > 0 and z not in set(strata):
            raise PositivityViolationError(
                f"Missing target stratum '{z}': treated_count=0, control_count=0."
            )
    stratum_contrasts = {}

    for z in strata:
        sub = df[df[z_col] == z]
        treated = sub[sub[t_col] == 1]
        control = sub[sub[t_col] == 0]
        n_t1, n_t0 = len(treated), len(control)
        if n_t1 == 0 or n_t0 == 0:
            raise PositivityViolationError(
                f"Positivity violation in stratum '{z}': "
                f"treated_count={n_t1}, control_count={n_t0}."
            )
        stratum_contrasts[z] = treated[y_col].mean() - control[y_col].mean()

    ate = sum(p * stratum_contrasts[z] for z, p in p_z.items() if p > 0)
    return {"ate": ate, "stratum_contrasts": stratum_contrasts}

# 测试验证:断言违背正值性时正确抛出异常
df_fail = pd.DataFrame([
    {"Z": "stratum_a", "T": 1, "Y": 1},
    {"Z": "stratum_a", "T": 1, "Y": 0},  # stratum_a 缺少 T=0
    {"Z": "stratum_b", "T": 1, "Y": 1},
    {"Z": "stratum_b", "T": 0, "Y": 0},
])

try:
    compute_stratified_ate_safe(df_fail)
    raise AssertionError("未能成功捕获正值性破坏!")
except PositivityViolationError as e:
    assert "Positivity violation in stratum 'stratum_a'" in str(e)
43-P03 参考实现
当前选择器先核非空字段、带时区时间戳、source/version 唯一及每 source 单一 cutoff;时间序列须满足 event≤revision≤available≤ingested、signal<trade≤label_start<label_end≤label_available。在这些有效输入前提下,以 max(available,ingested)≤signal 过滤,再按最大 version_id 选完整一行。编号须代表版本先后;函数未额外证明同 source 的 revision 随编号严格单调。多历史 cutoff 须由调用者分组调用,不是本接口直接支持的输入。时点资格不等于权利、模型或整项研究有效性。
import pandas as pd
from quant_course.bayesian_text import (
    filter_pit_eligible_documents,
    generate_constructed_text_dataset,
)

def test_pit_selection_and_deduplication():
    """Verify PIT selection rejects late revisions without splicing corrupted columns."""
    base_df, invalid_df = generate_constructed_text_dataset(seed=4302, n_documents=120)

    # 注入晚修订记录(例如版本2在信号后发布)
    late_revision = invalid_df.iloc[0:1]
    combined = pd.concat([base_df, late_revision], ignore_index=True)

    # 严格根据信号截止时间过滤
    filtered = filter_pit_eligible_documents(combined, cutoff_col="signal_time")

    # 断言保留了版本1,完全排除了版本2,且样本总数严格为120
    assert len(filtered) == 120
    row_10 = filtered[filtered["doc_id"] == 10]
    assert len(row_10) == 1
    assert row_10.iloc[0]["version_id"] == 1

test_pit_selection_and_deduplication()
43-P04 参考实现
import numpy as np
from quant_course.bayesian_text import TextFeaturePipeline

def test_oov_invariance_and_frozen_vocabulary():
    """Verify feature extractor fitted on train never alters vocabulary or IDF on test OOV."""
    train_texts = [
        "quarterly revenue grew strongly beating analyst consensus",
        "earnings performance contracted showing weak operating margins",
    ]
    pipeline = TextFeaturePipeline()
    pipeline.fit(train_texts)

    vocab_before = dict(pipeline.vocabulary_)
    idf_before = np.copy(pipeline.idf_)

    # 输入包含全新未见生词(OOV)与扰动字符串
    test_oov_texts = [
        "completely novel unexpected synthetic jargon xyz123",
        "artificial unigram token with zero intersection",
    ]
    vec_test = pipeline.transform(test_oov_texts)

    # 断言内部词表与 IDF 完全无变异
    assert pipeline.vocabulary_ == vocab_before
    assert np.array_equal(pipeline.idf_, idf_before)
    # 全新生词文本被投影为全零向量,不产生 NaN 或未知溢出
    assert np.allclose(vec_test, 0.0)

test_oov_invariance_and_frozen_vocabulary()
43-C01 完整解答、运行反例与评分标准
DAG 的箭头本身不决定选择后关联的符号;本题负号依赖独立 Bernoulli(0.5) 与 OR 规则。若保持独立输入但改为
-
理论论证与代数推导: 设两个二值选股因子
(动量突破)与 (质量 Alpha)。假设它们在全市场独立同分布,边际概率均为 。 四种联合状态 各具有无条件先验概率 。 显然,无条件协方差为 。 假设投资组合选股准入规则为任一因子表现突出即可入选(对撞节点 )。 当研究员限定在成分股池( )内进行实证分析时: -
状态
被完全剔除; -
剩余三种状态
在 条件下具有相等的条件概率 。 -
条件期望:
-
条件协方差计算:
-
条件相关系数:
原本完全独立的两个因子,仅仅因为研究员对对撞节点
进行了条件筛选,就在样本内部诱发了高达 的强负相关!代码实跑 2000 个样本的经验协方差约为 ,与理论值 数值接近;有限样本经验值不等于理论极限。 -
from quant_course.bayesian_text import demonstrate_collider_bias
r = demonstrate_collider_bias(n=2000, seed=4301)
print(r)
assert abs(r["conditioned_on_collider_covariance"] + 1/9) < 0.03
- 量化投资警示: 在量化选股中,若研究员仅在“沪深 300”或“标普 500”等大市值指数成分股内测试因子,由于入选指数本身受到市值规模与盈利能力的共同筛选,若准入机制符合本例对撞结构,可能在指数内部诱发因子关联;仅在指数内研究本身并不能证明存在该结构或偏误(例如大市值股票内动量与价值的虚假反转),从而将样本选择偏误(Berkson's Paradox)误当成可交易的市场异象。
- 评分标准:
- 满分(10分):清晰给出对撞 DAG 图,完整推导出条件负协方差
与相关系数 ,并深刻指出成分股准入与生存者偏差的量化映射; - 及格(6分):定性说明对撞物诱发负相关,但未给出三种等概率状态的代数展开;
- 不及格(0–5分):混淆混杂物(Confounder)与对撞物(Collider)。
- 满分(10分):清晰给出对撞 DAG 图,完整推导出条件负协方差
43-C02 开放题参考解答与评分标准
- 教学 JSON Schema 与 Python 校验实现:
import json
import hashlib
from jsonschema import validate, ValidationError

# 规范 JSON Schema 定义
AUDIT_LEDGER_SCHEMA = {
    "$schema": "https://json-schema.org/draft/2020-12/schema",
    "title": "LLMOfflineResearchAuditLedger",
    "type": "object",
    "required": [
        "prompt_template_version",
        "sample_input_text",
        "full_prompt_sha256_hash",
        "model_status",
        "model_slug",
        "declared_model_cutoff",
        "provenance_table",
        "reproducibility_limits"
    ],
    "properties": {
        "prompt_template_version": {"type": "string"},
        "sample_input_text": {"type": "string"},
        "full_prompt_sha256_hash": {"type": "string", "pattern": "^[a-f0-9]{64}$"},
        "model_status": {"type": "string", "enum": ["not_run", "offline_cached"]},
        "model_slug": {"type": "string"},
        "declared_model_cutoff": {"type": "string"},
        "provenance_table": {
            "type": "object",
            "required": ["source_id", "historical_signal_time", "cutoff_leakage_risk"],
            "properties": {
                "source_id": {"type": "string"},
                "license": {"type": "string"},
                "historical_signal_time": {"type": "string"},
                "cutoff_leakage_risk": {"type": "string"}
            }
        },
        "reproducibility_limits": {
            "type": "array",
            "items": {"type": "string"}
        }
    }
}

def validate_and_hash_audit_ledger(ledger_dict: dict, trusted_expected_hash=None) -> bool:
    """Check local digest consistency; optionally compare an independently trusted digest."""
    validate(instance=ledger_dict, schema=AUDIT_LEDGER_SCHEMA)

    # 重新计算哈希核验一致性
    template = (
        "You are an offline equity research audit assistant.\n"
        'Analyze the following corporate transcript snippet under strict '
        'Point-in-Time constraints:\n'
        "Snippet: \"{transcript_snippet}\"\n"
        'Identify whether the statement reports historical performance or '
        'provides future guidance.\n'
        'Output format: JSON with keys "type" '
        '(HISTORICAL/FORWARD_LOOKING) and "polarity" (POSITIVE/NEGATIVE/NEUTRAL).\n'
        "Do not assume post-event market price reactions."
    )
    expected_prompt = template.format(transcript_snippet=ledger_dict["sample_input_text"])
    expected_hash = hashlib.sha256(expected_prompt.encode("utf-8")).hexdigest()

    if ledger_dict["full_prompt_sha256_hash"] != expected_hash:
        raise ValueError("Recorded prompt digest does not match the current input.")
    if trusted_expected_hash is not None and expected_hash != trusted_expected_hash:
        raise ValueError("Current prompt differs from the independently trusted digest.")
    return True

def audit_cutoff_relation(ledger):
    # Unknown means unevaluated, not PIT-pass. A later cutoff flags risk, not confirmed contamination.
    import pandas as pd
    declared = ledger["declared_model_cutoff"]
    if declared == "unknown":
        return "not_evaluated"
    cutoff = pd.Timestamp(declared)
    signal = pd.Timestamp(ledger["provenance_table"]["historical_signal_time"])
    if cutoff.tz is None or signal.tz is None:
        raise ValueError("Require full timezone-aware cutoff and signal timestamps.")
    return "potential_future_corpus" if cutoff > signal else "cutoff_only_insufficient_for_PIT"

from quant_course.bayesian_text import llm_offline_audit_ledger
valid_ledger = llm_offline_audit_ledger()
assert validate_and_hash_audit_ledger(valid_ledger)
# Teaching assumption: this digest was preserved independently before local mutation.
# This assignment illustrates a comparison; it does not create trusted timestamp custody.
trusted_baseline = valid_ledger["full_prompt_sha256_hash"]
changed_both = llm_offline_audit_ledger(sample_text="changed input and matching digest")
assert validate_and_hash_audit_ledger(changed_both)  # local consistency alone passes
assert changed_both["full_prompt_sha256_hash"] != trusted_baseline
try:
    validate_and_hash_audit_ledger(changed_both, trusted_baseline)
    raise AssertionError("Changed prompt escaped independent-baseline comparison")
except ValueError:
    pass
assert audit_cutoff_relation(valid_ledger) == "not_evaluated"
tampered = dict(valid_ledger, sample_input_text="changed input")
try:
    validate_and_hash_audit_ledger(tampered)
    raise AssertionError("Tampered input escaped hash validation")
except ValueError:
    pass
scenario = dict(valid_ledger, declared_model_cutoff="2023-12-31T00:00:00+00:00")
assert audit_cutoff_relation(scenario) == "potential_future_corpus"

# 错误反例测试:缺失必需字段或非法的 64 位哈希
invalid_ledger = {
    "prompt_template_version": "v1.2",
    "sample_input_text": "sample",
    "full_prompt_sha256_hash": "invalid_short_hash", # 破坏正则
    "model_status": "not_run"
}
try:
    validate(instance=invalid_ledger, schema=AUDIT_LEDGER_SCHEMA)
    assert False, "未能拦截非法 Schema!"
except ValidationError:
    pass # 正确拦截
日期字段在 Schema 中只是字符串;合法字符串不等于有效时间,仍须如上解析为完整带时区时间戳。unknown 返回 not_evaluated,不是通过。Schema 允许 offline_cached,但本章实际实例仍为 not_run,未调用 LLM。
- 三大工程防线与不可复现性防御:
- 防线 1(输入物理隔离与全提示词哈希):严禁将事后分析或后序股价反应输入给大模型;哈希必须覆盖格式化后的“模板 + 实际文本”整体,而非仅计算静态模板字符串;同时改输入与本地摘要仍可通过一致性校验,须独立可信基准对照,不能称为加密/不可变存证。
- 防线 2(确定性局限与版本漂移防御):生产环境中必须清醒认识到:设置
temperature=0和固定种子并不能保证跨 GPU 微架构、跨 CUDA 驱动或跨推理引擎版本的比特级复现;模型服务商的静默更新会导致特征漂移,必须对关键时点提取结果进行离线持久化与快照归档。 - 防线 3(拒绝预训练 Cutoff 等价 PIT):严禁将商业大模型的预训练截止日期(如 2023-12)等同于可核查的历史时点记录;晚于历史信号的训练语料可能包含后续报道,因此截止声明不足以证明历史无泄漏。模型在未调用时必须如实登记为
not_run / unknown。
- 评分标准:
- 满分(10分):给出标准 JSON Schema 与 Python 校验拦截实现、完整提示词摘要一致性与独立可信基准边界、同时改输入和摘要的反例以及深刻剖析三大工程防线;
- 及格(6分):给出了合法 JSON 与哈希,但未提供正式 Schema 校验代码或对非确定性漂移认识不足;
- 不及格(0–5分):以为大模型自带 PIT,未意识到预训练截止日期的前瞻泄漏危害。
43-C03 完整解答
该实验检查同模板支持集下的时间块外推、标签成熟与训练内预处理;并未留出新文本/新模板,不能证明新文本泛化。OOV检查证明transform不改训练词表和IDF,不证明未见语言上的预测准确性。若将来研究新语言泛化,应另行冻结按文本模板/公司语言留出的数据协议并保留时间约束;本批不改变实验或重训。
19. Further Reading
- Must Know:
- Gelman, Carlin, Stern, Dunson, Vehtari, Rubin (2013/2025). Bayesian Data Analysis (BDA3), 第 2.4, 2.5, 5.4 节。精读共轭先验、后验预测积分与正态部分池化闭式解。
- Hernán MA, Robins JM (2020). Causal Inference: What If, Part I (Chapters 1–3)。精读潜在结果、条件可交换性、正值性与 SUTVA 假设。
- Should Know:
- Stan Development Team. Stan User's Guide, 当前官方文档的 Hierarchical regression 与 Posterior predictive checks 页面(版本与读取范围见 source_notes)。掌握贝叶斯层级模型的生产级思想。
- scikit-learn 官方文档: Text Feature Extraction 与 Common Pitfalls in Machine Learning。深入掌握文本特征提取中的数据泄漏规避。
- Advanced:
- Hernán & Robins, What If, §6.3 与 §7.3:用已核读的对撞路径和后门准则继续练习识别判断。
- Glasserman, P., & Lin, C. (2023). Assessing Look-Ahead Bias in Stock Return Predictions Generated By GPT Sentiment Analysis。研读大模型预训练语料前瞻泄漏与回测污染的量化前沿。
- Optional:
- SEC EDGAR Application Programming Interfaces 官方开发者指南。了解真实监管申报流水的数据接口。
- OpenAI (2025). Why language models hallucinate。掌握金融场景下大模型幻觉与不可复现性应对。
20. References
BDA3: Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013/2025). Bayesian Data Analysis (Third Edition). CRC Press. Electronic edition:https://users.aalto.fi/~ave/BDA3.pdf. [支持第4、5、6.1、6.2、8.1、8.2节推导与算例]STAN_UG: Stan Development Team. (2026). Stan User's Guide.https://mc-stan.org/docs/stan-users-guide/. [支持第5、6.2、7节层级模型设计]HERNAN_ROBINS_2020: Hernán, M. A., & Robins, J. M. (2020). Causal Inference: What If. Boca Raton: Chapman & Hall/CRC.https://www.hsph.harvard.edu/miguel-hernan/causal-inference-book/. [支持第3、4、5、6.3、7、8.3节因果识别推导与 Simpson 悖论]CH43_SK_TEXT: Scikit-learn Developers. Text feature extraction; Common pitfalls. 当前官方文档(2026-10-11 获取)。https://scikit-learn.org/stable/modules/feature_extraction.html&https://scikit-learn.org/stable/common_pitfalls.html. [支持第5、6.4、9、12节 TF-IDF 管线实现]SEC_EDGAR_API: U.S. Securities and Exchange Commission. (2024-06-06;更新2025-04-08,读取2026-10-11). EDGAR Application Programming Interfaces (APIs).https://www.sec.gov/search-filings/edgar-application-programming-interfaces. [第7、11节通用接口与处理延迟线索;不证明具体文本PIT或许可]LLM_LOOKAHEAD_GLASSERMAN_LIN: Glasserman, P., & Lin, C. (2023). Assessing Look-Ahead Bias in Stock Return Predictions Generated By GPT Sentiment Analysis. arXiv:2309.17322,v1(历史核查仅核读摘要与元数据,本轮继承)。 [支持第5、7、12、13节大模型前瞻偏误机制]OPENAI_HALLUCINATION_2025: OpenAI. (2025). Why language models hallucinate. 官方研究解读,2025-09-05。https://openai.com/index/why-language-models-hallucinate/. [支持第5、12、18节大模型幻觉与事实性审查规范]
历史来源的实际读取范围与本轮继承身份见共享路径 course/zh/chapters/ch43/source_notes.md;BIL20未重新访问这些网页或执行历史协议。