第 37 章/ 45
金融机器学习的基本立场(ML for Finance Philosophy)
主线:预测准确率提高,扣除成本后的投资结果仍可能变差;金融机器学习要把预测、决策、成本和证据放在同一张账上评价。
先修:第7章统计推断、第22章研究方法与多重检验、第31章模型验证、第35章交易成本。完成后你能:用一个可手算的反例说明准确率与净收益为何背离;写出重叠标签、状态切换和多次尝试对证据强度的影响;给出一份把样本外、稳定性、成本、尾部和经济逻辑一起检查的评价清单。
1. 本章目标
读完本章,你应能完成下面六件可核验的事:
对一组日收益和多空仓位,手算方向准确率(directional accuracy)、毛收益、换手(turnover)、成本和净收益,并写出准确率与收益之间的恒等式 ∑ t p t r t = ∑ t ∣ r t ∣ ( 2 c t − 1 ) \sum_t p_t r_t=\sum_t |r_t|(2c_t-1) ∑ t p t r t = ∑ t ∣ r t ∣ ( 2 c t − 1 ) p t = ± 1 p_t=\pm1 p t = ± 1
解释金融预测的四个结构性难点:非平稳(non-stationarity)、低信噪比(low signal-to-noise ratio)、时间依赖(temporal dependence)和状态切换(regime shift),并为每一个给出一个可运行的数值例子。
计算 N N N
把数据泄漏(data leakage)分成目标泄漏、前视特征、预处理泄漏、选择泄漏和重叠标签泄漏五类,各给一个错误写法与修复。
说出金融问题与 Kaggle 类竞赛在数据生成、测试集、评价指标上的差别,并据此选择基准(baseline)。
为后续第38–40章和 Project6 写出评价门槛:样本外、稳定性、成本、尾部和经济逻辑五项同时检查。
完成条件:第15–17节每道题能独立做出,答案与第18节一致;能解释第8节历史缓存的输入、输出与局限。默认读者入口与重新运行的身份差别见第9节;本批不重跑模拟。
2. 为什么 Quant 需要它
假设你在评审一个日频方向预测模型。研究员报告:测试集上涨跌方向准确率从 52% 提高到 55%。这个数字可能让你批准上线,也可能让你亏钱。准确率把每一天看成同样重要,组合收益却按当天收益的大小记账。一个模型在 100 个平静的日子里猜对,在 3 个暴跌日猜错,准确率很高,账户可能亏损。再加上模型每天翻转仓位,交易成本会吃掉剩下的利润。
前面各章已经准备好零件。第7章给出估计量的抽样误差,第22章讲研究方案冻结和多重检验,第31章讲标签区间、purging 与 walk-forward,第35章讲成本。本章把这些零件放到机器学习的语境里,回答一个更根本的问题:在金融里训练预测模型,你到底在优化什么,又凭什么相信结果。
本章不训练复杂模型。第38章搭建按日期划分、训练内拟合的管线,第39章用正则化线性模型做受控比较,第40章才引入树模型。本章的结论会成为它们的验收门槛。
从预测分数走到账户:先固定三张表
读三章时始终拿着三张表:信息表记录“这次拟合与决策当时能读到什么”;预测表记录“在什么日期、对哪些资产预测了什么”;账本记录“什么时候成交、仓位如何变化、付了多少成本”。本章先把后两张表接起来,第38章补齐信息表,第39章在同一管线中比较估计器。
这条路径也决定比较的顺序:先固定时钟与基准,再用训练内验证选模型,最后在冻结测试期报告预测和组合两层结果。看见一个更高的准确率,还不能跳过成交和成本直接读成更高的净收益。
3. 直觉
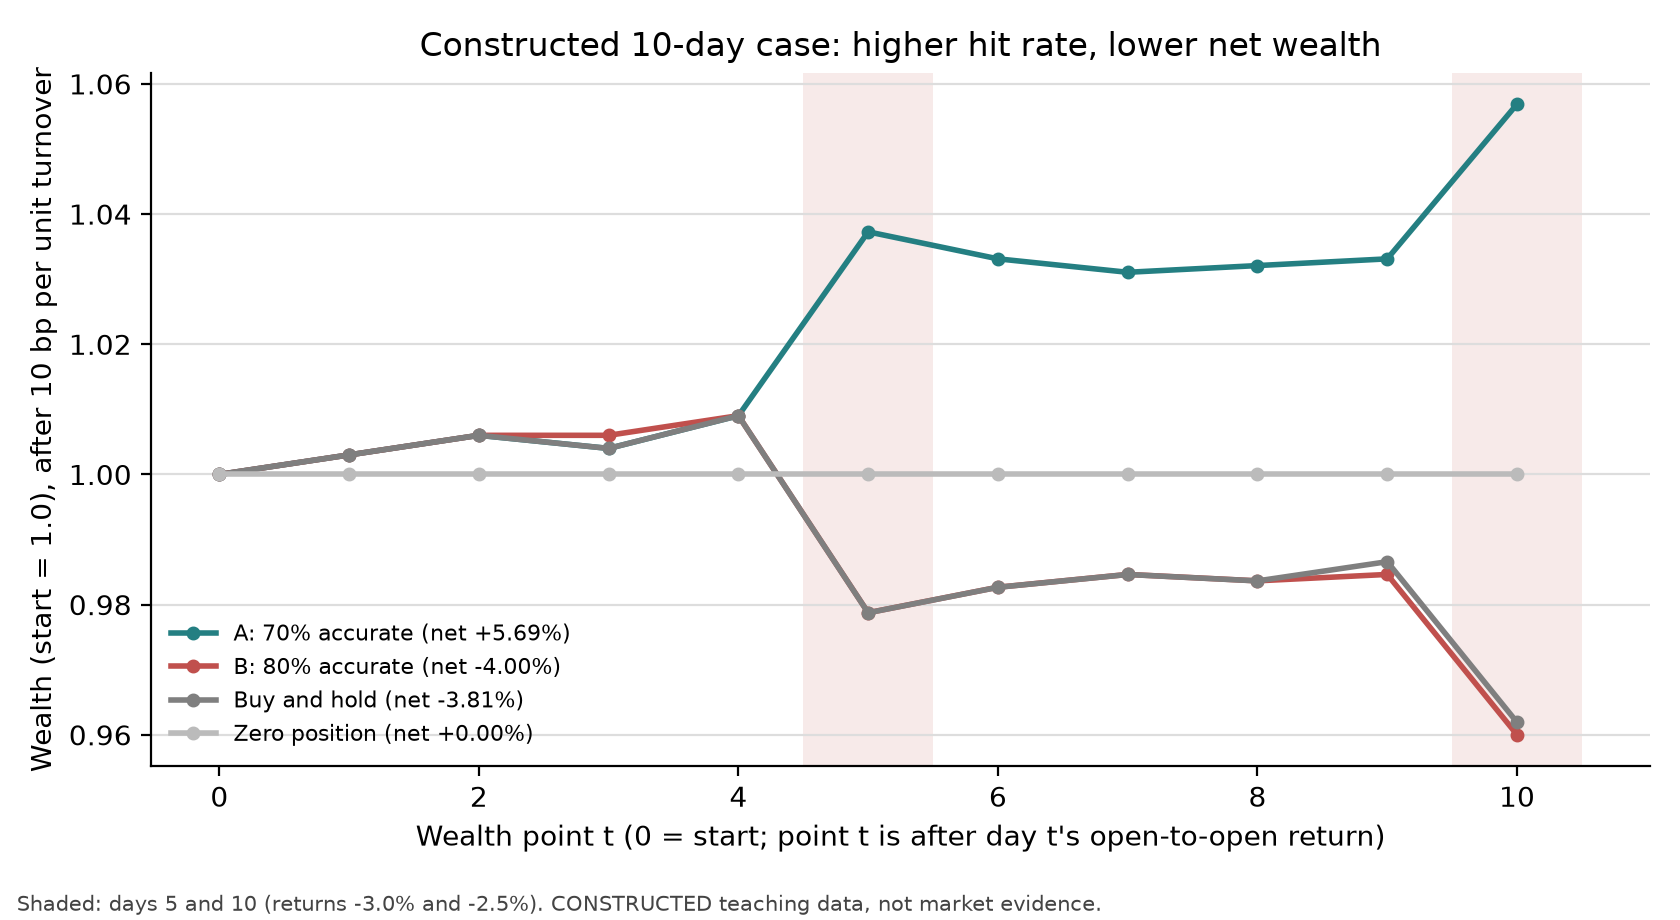
先看一个只有十天的构造例子(教学构造,不是市场数据)。一只资产十天的开盘到开盘收益(%)为
r = ( + 0.4 , + 0.3 , − 0.2 , + 0.5 , − 3.0 , + 0.4 , + 0.2 , − 0.1 , + 0.3 , − 2.5 ) .
r=(+0.4,\;+0.3,\;-0.2,\;+0.5,\;-3.0,\;+0.4,\;+0.2,\;-0.1,\;+0.3,\;-2.5).
r = ( + 0.4 , + 0.3 , − 0.2 , + 0.5 , − 3.0 , + 0.4 , + 0.2 , − 0.1 , + 0.3 , − 2.5 ) . 第5天和第10天是两次大跌,其余八天波动很小。两个模型每天给出方向,你按方向持有一单位多头(+ 1 +1 + 1 − 1 -1 − 1
模型 B 在八个小波动日全部猜对,两次大跌都猜成上涨。准确率 80%。
模型 A 在三个小波动日猜错,两次大跌都猜成下跌。准确率 70%。
只看准确率你会选 B。看账户,B 在两次大跌日各亏一整份跌幅,A 在两次大跌日各赚一整份跌幅。小日子里的对错只值零点几个百分点,大日子里的对错值几个百分点。B 还在第3天、第8天两次反手,换手比 A 多。第8节会算出:扣除每单位换手 0.1% 的成本后,A 的十天复利净收益约 +5.69%,B 约 −4.00%。
这个例子故意很小,它的作用是让你看清机制:准确率与盈利由不同的权重聚合同一串对错。真实数据里,收益的厚尾让少数日子决定大部分盈亏,这个机制只会更强。简化的边界也要说明:这里的仓位只有 ± 1 \pm1 ± 1
4. 数学基础
本章用到的符号如下,频率均为日频,收益为小数(0.004 表示 0.4%)。
符号
含义
单位/维度
t = 1 , … , T t=1,\dots,T t = 1 , … , T 交易日编号
无量纲
r t r_t r t 第 t t t t + 1 t+1 t + 1
小数/日
d ^ t ∈ { − 1 , + 1 } \hat d_t\in\{-1,+1\} d ^ t ∈ { − 1 , + 1 } 模型在第 t − 1 t-1 t − 1
无量纲
p t p_t p t 第 t t t
财富倍数
c t = 1 { sign ( p t ) = sign ( r t ) } c_t=\mathbf 1\{\operatorname{sign}(p_t)=\operatorname{sign}(r_t)\} c t = 1 { sign ( p t ) = sign ( r t )} 第 t t t
0 或 1
κ \kappa κ 每单位仓位变化的成本
小数(财富比例)
τ t = ∣ p t − p t − 1 ∣ \tau_t=\lvert p_t-p_{t-1}\rvert τ t = ∣ p t − p t − 1 ∣ p 0 = 0 p_0=0 p 0 = 0 第 t t t
财富倍数
W t W_t W t 第 t t t W 0 = 1 W_0=1 W 0 = 1
货币单位(归一)
时间约定:信号时点(signal_time)是第 t − 1 t-1 t − 1 t t t t t t t + 1 t+1 t + 1 lag>=1 约定一致。这个十日例用开盘成交,便于手算;第38、39章与 Project6 只有收盘价,改为“信号收盘后的下一交易日收盘成交、标签从成交收盘起算”,两种约定各自自洽,不要混用。
用到的统计工具:样本均值的方差、相关系数与决定系数的关系(第7、8章)、正态分布最大值(第32章;多重检验原则见第22章)。若你对 Var ( x ˉ ) \operatorname{Var}(\bar x) Var ( x ˉ )
5. 正式定义
预测(prediction)与决策(decision)。 预测是一个从信息集到目标变量估计的映射 f : F t − 1 → y ^ t f:\mathcal F_{t-1}\to\hat y_t f : F t − 1 → y ^ t g : ( y ^ t , p t − 1 , 约束 ) → p t g:(\hat y_t,p_{t-1},\text{约束})\to p_t g : ( y ^ t , p t − 1 , 约束 ) → p t p t r t − κ τ t p_t r_t-\kappa\tau_t p t r t − κ τ t g g g f f f f f f g g g f f f f f f g g g
方向准确率(directional accuracy / hit rate)。 在 p t ≠ 0 p_t\neq0 p t = 0 r t ≠ 0 r_t\neq0 r t = 0 A c c = 1 T ′ ∑ t c t \mathrm{Acc}=\frac1{T'}\sum_t c_t Acc = T ′ 1 ∑ t c t
幅度加权准确率(magnitude-weighted accuracy)。 A c c ∣ r ∣ = ∑ t ∣ r t ∣ c t / ∑ t ∣ r t ∣ \mathrm{Acc}_{|r|}=\sum_t |r_t|c_t\big/\sum_t|r_t| Acc ∣ r ∣ = ∑ t ∣ r t ∣ c t / ∑ t ∣ r t ∣ ± 1 \pm1 ± 1
教学代理账本的边界。 本章以目标方向差 ∣ p t − p t − 1 ∣ |p_t-p_{t-1}| ∣ p t − p t − 1 ∣
净收益与财富路径。 第 t t t n t = p t r t − κ τ t n_t=p_tr_t-\kappa\tau_t n t = p t r t − κ τ t W t = W t − 1 ( 1 + n t ) W_t=W_{t-1}(1+n_t) W t = W t − 1 ( 1 + n t ) T T T T + 1 T+1 T + 1 W 0 , … , W T W_0,\dots,W_T W 0 , … , W T κ ∣ p T ∣ \kappa|p_T| κ ∣ p T ∣
非平稳(non-stationarity)。 若 ( x t , y t ) (x_t,y_t) ( x t , y t ) t t t E [ y t ∣ x t ] E[y_t\mid x_t] E [ y t ∣ x t ] b t b_t b t
状态切换(regime shift)。 非平稳的一种:存在日期 t ∗ t^\ast t ∗ b t = b ( 1 ) b_t=b^{(1)} b t = b ( 1 ) t < t ∗ t<t^\ast t < t ∗ b t = b ( 2 ) b_t=b^{(2)} b t = b ( 2 ) t ≥ t ∗ t\ge t^\ast t ≥ t ∗
信噪比(signal-to-noise ratio)。 对 y = b x + ε y=bx+\varepsilon y = b x + ε x x x ε \varepsilon ε S N R = b 2 Var ( x ) / Var ( ε ) \mathrm{SNR}=b^2\operatorname{Var}(x)/\operatorname{Var}(\varepsilon) SNR = b 2 Var ( x ) / Var ( ε ) R 2 = S N R / ( 1 + S N R ) = ρ 2 R^2=\mathrm{SNR}/(1+\mathrm{SNR})=\rho^2 R 2 = SNR / ( 1 + SNR ) = ρ 2 ρ \rho ρ x x x y y y ρ \rho ρ R 2 R^2 R 2
时间依赖(temporal dependence)。 观测之间存在相关;本章的正相关重叠结构减少了均值估计的有效信息,但负自相关下均值的有效样本量也可大于观测数。本章重点是重叠标签(overlapping labels) :每天计算一次未来 h h h h − 1 h-1 h − 1
多重检验(multiple testing)与选择偏差。 尝试 N N N
数据泄漏(data leakage)。 训练或选择模型时用到了在预测时点无法获得的信息。本章按信息进入的路径分五类:目标泄漏(target leakage,特征由标签本身或其未来部分构成)、前视特征(look-ahead feature,特征的可用时点晚于信号时点)、预处理泄漏(preprocessing leakage,标准化、填补、降维用到测试数据)、选择泄漏(selection leakage,用测试集选模型、选特征、选阈值)和重叠泄漏(overlap leakage,训练标签区间与测试标签区间相交)。五类的共同点是:测试表现中混入了部署时拿不到的信息。
基准(baseline)。 与候选模型在同一样本、同一时间约定、同一成本下比较的简单规则。本书默认三条:零预测(不持仓)、训练均值预测、简单规则(如买入持有或第25章动量)。没有基准的样本外数字无法解释。
样本外 R 2 R^2 R 2 R 2 R^2 R 2 对测试样本 y t y_t y t y ^ t \hat y_t y ^ t y ˉ t base \bar y_t^{\text{base}} y ˉ t base R OS 2 = 1 − ∑ t ( y t − y ^ t ) 2 / ∑ t ( y t − y ˉ t base ) 2 R^2_{\text{OS}}=1-\sum_t(y_t-\hat y_t)^2\big/\sum_t(y_t-\bar y_t^{\text{base}})^2 R OS 2 = 1 − ∑ t ( y t − y ^ t ) 2 / ∑ t ( y t − y ˉ t base ) 2
这几个概念的顺序有逻辑:预测与决策的区分告诉你要评价什么;非平稳、低信噪比、时间依赖说明为什么证据弱;多重检验和泄漏说明证据为何会被人为抬高;基准和 R OS 2 R^2_{\text{OS}} R OS 2
6. 推导
6.1 准确率与毛收益的恒等式
假设 :p t ∈ { − 1 , + 1 } p_t\in\{-1,+1\} p t ∈ { − 1 , + 1 } r t ≠ 0 r_t\neq0 r t = 0
第一步,按方向是否正确拆分单日毛收益。若 c t = 1 c_t=1 c t = 1 p t p_t p t r t r_t r t p t r t = ∣ r t ∣ p_tr_t=|r_t| p t r t = ∣ r t ∣ c t = 0 c_t=0 c t = 0 p t r t = − ∣ r t ∣ p_tr_t=-|r_t| p t r t = − ∣ r t ∣
p t r t = ∣ r t ∣ ( 2 c t − 1 ) .
p_tr_t=|r_t|\,(2c_t-1).
p t r t = ∣ r t ∣ ( 2 c t − 1 ) . 第二步,对 t t t
∑ t = 1 T p t r t = ∑ t ∣ r t ∣ ( 2 c t − 1 ) = 2 ∑ t ∣ r t ∣ c t − ∑ t ∣ r t ∣ = ( ∑ t ∣ r t ∣ ) ( 2 A c c ∣ r ∣ − 1 ) .
\sum_{t=1}^T p_tr_t=\sum_t|r_t|(2c_t-1)=2\sum_t|r_t|c_t-\sum_t|r_t|=\Big(\sum_t|r_t|\Big)\big(2\,\mathrm{Acc}_{|r|}-1\big).
t = 1 ∑ T p t r t = t ∑ ∣ r t ∣ ( 2 c t − 1 ) = 2 t ∑ ∣ r t ∣ c t − t ∑ ∣ r t ∣ = ( t ∑ ∣ r t ∣ ) ( 2 Acc ∣ r ∣ − 1 ) . 最后一个等号用了幅度加权准确率的定义。毛收益为正当且仅当 A c c ∣ r ∣ > 1 / 2 \mathrm{Acc}_{|r|}>1/2 Acc ∣ r ∣ > 1/2 ∣ r t ∣ |r_t| ∣ r t ∣ A c c \mathrm{Acc} Acc ( 1 , 2 , 3 , 4 ) (1,2,3,4) ( 1 , 2 , 3 , 4 ) 1 / 2 1/2 1/2 ± 1 \pm1 ± 1
用途 :这条恒等式告诉你分类损失(0-1 损失)与投资损失不是同一个目标。当你用交叉熵或准确率训练方向模型时,模型在大波动日和小波动日犯错的代价被同等对待;投资者的代价按 ∣ r t ∣ |r_t| ∣ r t ∣ ∣ r t ∣ |r_t| ∣ r t ∣ 不能用的情形 :仓位大小随预测置信度变化时,p t ≠ ± 1 p_t\neq\pm1 p t = ± 1 ∑ p t r t \sum p_tr_t ∑ p t r t
6.2 成本把净收益拉开
∑ t n t = ∑ t p t r t − κ ∑ t τ t , τ t = ∣ p t − p t − 1 ∣ ∈ { 0 , 1 , 2 } .
\sum_t n_t=\sum_tp_tr_t-\kappa\sum_t\tau_t,\qquad \tau_t=|p_t-p_{t-1}|\in\{0,1,2\}.
t ∑ n t = t ∑ p t r t − κ t ∑ τ t , τ t = ∣ p t − p t − 1 ∣ ∈ { 0 , 1 , 2 } . ± 1 \pm1 ± 1 τ t = 2 \tau_t=2 τ t = 2 κ = 0.1 % \kappa=0.1\% κ = 0.1% W T = ∏ ( 1 + n t ) W_T=\prod(1+n_t) W T = ∏ ( 1 + n t )
6.3 信噪比与 R 2 R^2 R 2
假设 :y = b x + ε y=bx+\varepsilon y = b x + ε E [ ε ] = 0 E[\varepsilon]=0 E [ ε ] = 0 ε \varepsilon ε x x x Var ( x ) = σ x 2 \operatorname{Var}(x)=\sigma_x^2 Var ( x ) = σ x 2 Var ( ε ) = σ ε 2 \operatorname{Var}(\varepsilon)=\sigma_\varepsilon^2 Var ( ε ) = σ ε 2
Var ( y ) = b 2 σ x 2 + σ ε 2 , R 2 = b 2 σ x 2 b 2 σ x 2 + σ ε 2 = S N R 1 + S N R .
\operatorname{Var}(y)=b^2\sigma_x^2+\sigma_\varepsilon^2,\qquad
R^2=\frac{b^2\sigma_x^2}{b^2\sigma_x^2+\sigma_\varepsilon^2}=\frac{\mathrm{SNR}}{1+\mathrm{SNR}}.
Var ( y ) = b 2 σ x 2 + σ ε 2 , R 2 = b 2 σ x 2 + σ ε 2 b 2 σ x 2 = 1 + SNR SNR . 又 Cov ( x , y ) = b σ x 2 \operatorname{Cov}(x,y)=b\sigma_x^2 Cov ( x , y ) = b σ x 2 ρ = b σ x / b 2 σ x 2 + σ ε 2 \rho=b\sigma_x/\sqrt{b^2\sigma_x^2+\sigma_\varepsilon^2} ρ = b σ x / b 2 σ x 2 + σ ε 2 ρ 2 = R 2 \rho^2=R^2 ρ 2 = R 2 R 2 = 0.0025 R^2=0.0025 R 2 = 0.0025
这个数字不说明信号无用。第23章已经证明:截面上按标准化信号 z i z_i z i w i = z i / N w_i=z_i/N w i = z i / N I C t ⋅ σ y , t \mathrm{IC}_t\cdot\sigma_{y,t} IC t ⋅ σ y , t σ y , t \sigma_{y,t} σ y , t R 2 R^2 R 2 证据量 :你需要很多独立截面和很多期,才能把 0.05 与 0 区分开;同时,任何小的泄漏或过拟合都足以伪造一个 0.05。
6.4 重叠标签的自相关与有效样本量
假设 :日收益 u t u_t u t σ 2 \sigma^2 σ 2 t t t h h h Y t = ∑ j = 1 h u t + j Y_t=\sum_{j=1}^h u_{t+j} Y t = ∑ j = 1 h u t + j
Y t Y_t Y t Y t + k Y_{t+k} Y t + k 0 ≤ k < h 0\le k<h 0 ≤ k < h h − k h-k h − k
Cov ( Y t , Y t + k ) = ( h − k ) σ 2 , Var ( Y t ) = h σ 2 , ρ k = h − k h .
\operatorname{Cov}(Y_t,Y_{t+k})=(h-k)\sigma^2,\qquad \operatorname{Var}(Y_t)=h\sigma^2,\qquad \rho_k=\frac{h-k}{h}.
Cov ( Y t , Y t + k ) = ( h − k ) σ 2 , Var ( Y t ) = h σ 2 , ρ k = h h − k . k ≥ h k\ge h k ≥ h ρ k = 0 \rho_k=0 ρ k = 0 Y ˉ = 1 n ∑ t = 1 n Y t \bar Y=\frac1n\sum_{t=1}^nY_t Y ˉ = n 1 ∑ t = 1 n Y t n ≫ h n\gg h n ≫ h
Var ( Y ˉ ) ≈ Var ( Y t ) n ( 1 + 2 ∑ k = 1 h − 1 ρ k ) = h σ 2 n ( 1 + 2 ∑ k = 1 h − 1 h − k h ) = h σ 2 n ⋅ h .
\operatorname{Var}(\bar Y)\approx\frac{\operatorname{Var}(Y_t)}{n}\Big(1+2\sum_{k=1}^{h-1}\rho_k\Big)
=\frac{h\sigma^2}{n}\Big(1+2\sum_{k=1}^{h-1}\frac{h-k}{h}\Big)=\frac{h\sigma^2}{n}\cdot h.
Var ( Y ˉ ) ≈ n Var ( Y t ) ( 1 + 2 k = 1 ∑ h − 1 ρ k ) = n h σ 2 ( 1 + 2 k = 1 ∑ h − 1 h h − k ) = n h σ 2 ⋅ h . 第二个等号用了 ∑ k = 1 h − 1 ( h − k ) = h ( h − 1 ) / 2 \sum_{k=1}^{h-1}(h-k)=h(h-1)/2 ∑ k = 1 h − 1 ( h − k ) = h ( h − 1 ) /2 1 + ( h − 1 ) = h 1+(h-1)=h 1 + ( h − 1 ) = h h σ 2 / n h\sigma^2/n h σ 2 / n h h h 有效样本量 约为 n / h n/h n / h h = 5 h=5 h = 5 t t t t t t 5 ≈ 2.24 \sqrt5\approx2.24 5 ≈ 2.24 q = h − 1 q=h-1 q = h − 1 1 − k / h 1-k/h 1 − k / h 1 + 2 ∑ k = 1 h − 1 ( 1 − k / h ) ρ k = ( 2 h 2 + 1 ) / ( 3 h ) 1+2\sum_{k=1}^{h-1}(1-k/h)\rho_k=(2h^2+1)/(3h) 1 + 2 ∑ k = 1 h − 1 ( 1 − k / h ) ρ k = ( 2 h 2 + 1 ) / ( 3 h ) h = 5 h=5 h = 5
有限 n ≥ h n\ge h n ≥ h 1 + 2 ∑ k = 1 h − 1 ( 1 − k / n ) ρ k = h − ( h 2 − 1 ) / ( 3 n ) 1+2\sum_{k=1}^{h-1}(1-k/n)\rho_k=h-(h^2-1)/(3n) 1 + 2 ∑ k = 1 h − 1 ( 1 − k / n ) ρ k = h − ( h 2 − 1 ) / ( 3 n ) n n n n n n
适用边界 :日收益本身若有自相关或波动聚集,ρ k \rho_k ρ k ( h − k ) / h (h-k)/h ( h − k ) / h h h h
6.5 多次尝试的最大夏普比率
假设 :N N N T T T S R ^ d \widehat{SR}_d S R d N ( 0 , 1 / T ) N(0,1/T) N ( 0 , 1/ T ) S R ^ = 252 S R ^ d ≈ N ( 0 , 252 / T ) \widehat{SR}=\sqrt{252}\,\widehat{SR}_d\approx N(0,252/T) S R = 252 S R d ≈ N ( 0 , 252/ T )
E [ max 1 ≤ i ≤ N S R ^ i ] ≈ 252 T E [ max 1 ≤ i ≤ N Z i ] , Z i ∼ i i d N ( 0 , 1 ) .
E\Big[\max_{1\le i\le N}\widehat{SR}_i\Big]\approx\sqrt{\frac{252}{T}}\;E\Big[\max_{1\le i\le N}Z_i\Big],\qquad Z_i\overset{iid}{\sim}N(0,1).
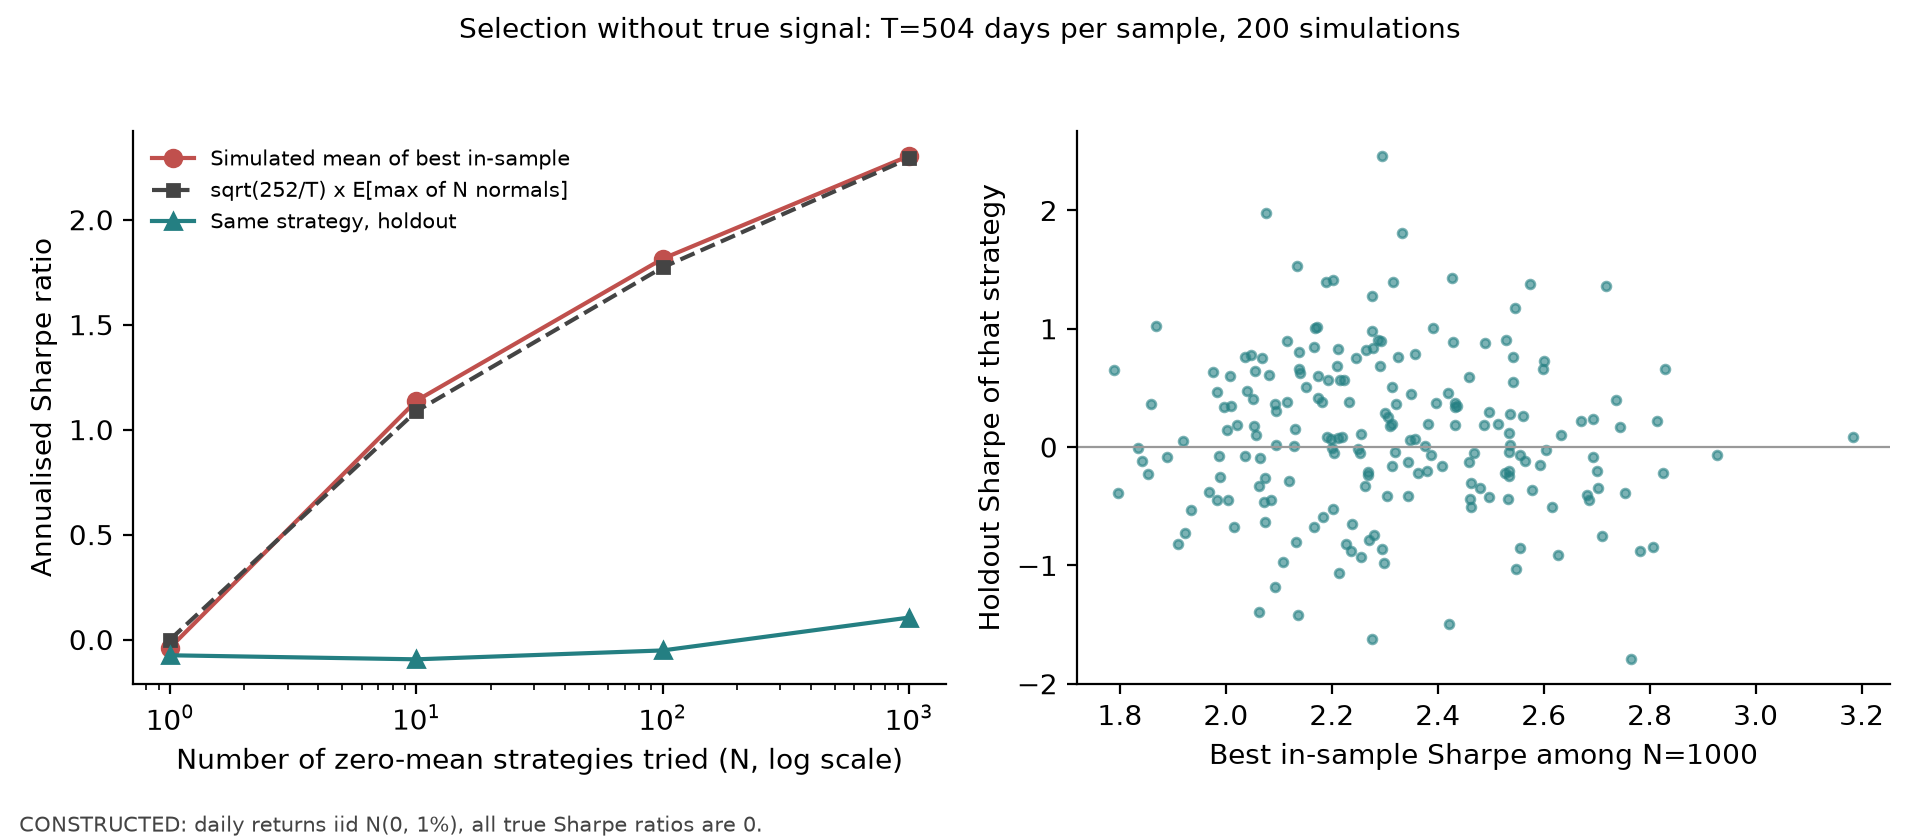
E [ 1 ≤ i ≤ N max S R i ] ≈ T 252 E [ 1 ≤ i ≤ N max Z i ] , Z i ∼ ii d N ( 0 , 1 ) . 第一个约等号来自正态近似;E [ max Z ] E[\max Z] E [ max Z ] research_protocol 模块中的精确积分函数),也可用 Bailey–López de Prado 近似 ( 1 − γ ) Φ − 1 ( 1 − 1 / N ) + γ Φ − 1 ( 1 − 1 / ( N e ) ) (1-\gamma)\Phi^{-1}(1-1/N)+\gamma\Phi^{-1}(1-1/(Ne)) ( 1 − γ ) Φ − 1 ( 1 − 1/ N ) + γ Φ − 1 ( 1 − 1/ ( N e )) γ ≈ 0.5772 \gamma\approx0.5772 γ ≈ 0.5772 T = 504 T=504 T = 504 252 / 504 = 0.707 \sqrt{252/504}=0.707 252/504 = 0.707 N = 100 N=100 N = 100 E [ max Z ] ≈ 2.51 E[\max Z]\approx2.51 E [ max Z ] ≈ 2.51
用途 :当你看到“在 100 个特征组合里挑出的最佳模型年化夏普 1.8”,先把它和 1.77 比较。它与零假设下的期望几乎相同,不构成发现。第32章讨论 Deflated Sharpe Ratio,试验登记与多重检验原则见第22章。期望最大值只是参照,不是精确的选择后 p p p
6.6 状态切换下的样本外 R 2 R^2 R 2
假设 :y t = b t x t + ε t y_t=b_tx_t+\varepsilon_t y t = b t x t + ε t x t , ε t ∼ i i d N ( 0 , 1 ) x_t,\varepsilon_t\overset{iid}{\sim}N(0,1) x t , ε t ∼ ii d N ( 0 , 1 ) + b +b + b − b -b − b b ^ \hat b b ^
E [ ( y − b ^ x ) 2 ] = E [ ( − b x + ε − b ^ x ) 2 ] = ( b + b ^ ) 2 + 1 , E [ y 2 ] = b 2 + 1.
E[(y-\hat bx)^2]=E[(-bx+\varepsilon-\hat bx)^2]=(b+\hat b)^2+1,\qquad E[y^2]=b^2+1.
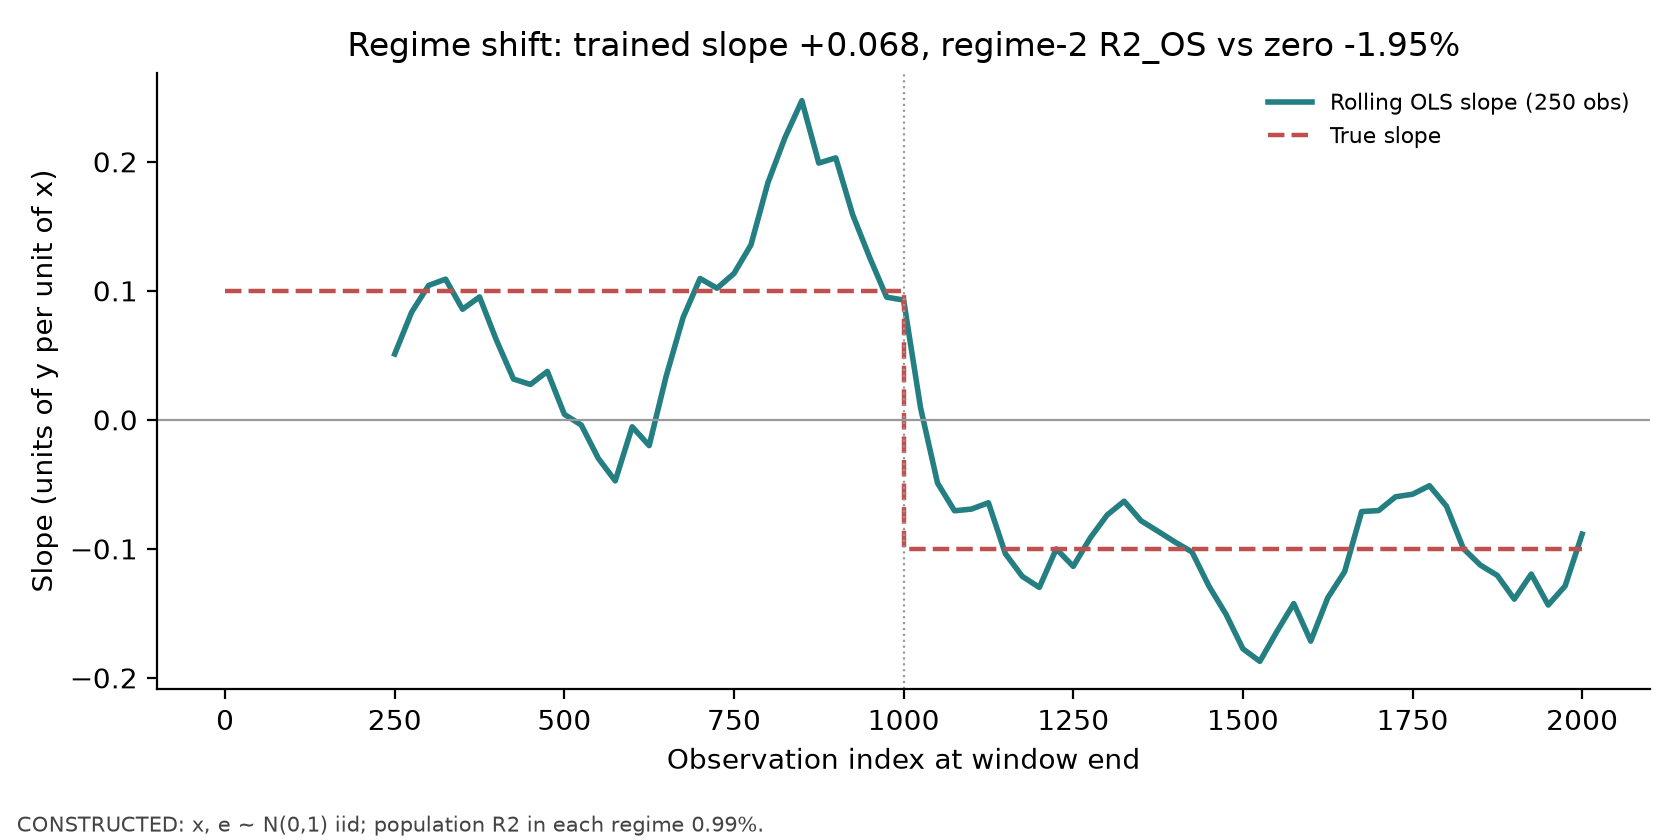
E [( y − b ^ x ) 2 ] = E [( − b x + ε − b ^ x ) 2 ] = ( b + b ^ ) 2 + 1 , E [ y 2 ] = b 2 + 1. 条件于已经拟合的固定 b ^ \hat b b ^ 1 − [ ( b + b ^ ) 2 + 1 ] / ( b 2 + 1 ) 1-[(b+\hat b)^2+1]/(b^2+1) 1 − [( b + b ^ ) 2 + 1 ] / ( b 2 + 1 ) R OS 2 R^2_{\text{OS}} R OS 2 R OS 2 ≈ 1 − ( b + b ^ ) 2 + 1 b 2 + 1 R^2_{\text{OS}}\approx1-\dfrac{(b+\hat b)^2+1}{b^2+1} R OS 2 ≈ 1 − b 2 + 1 ( b + b ^ ) 2 + 1 b ^ ≈ b \hat b\approx b b ^ ≈ b R OS 2 ≈ − 3 b 2 1 + b 2 R^2_{\text{OS}}\approx-\dfrac{3b^2}{1+b^2} R OS 2 ≈ − 1 + b 2 3 b 2 b = 0.1 b=0.1 b = 0.1 − 2.97 % -2.97\% − 2.97% b ^ \hat b b ^ b b b − b -b − b ( b + b ^ ) 2 (b+\hat b)^2 ( b + b ^ ) 2 b ^ < b \hat b<b b ^ < b − b -b − b R 2 R^2 R 2
7. 金融解释
为什么大日子决定盈亏。 日收益厚尾:极少数日子的绝对收益远大于典型日子(第11章、第33章)。∑ t p t r t \sum_tp_tr_t ∑ t p t r t
为什么低信噪比是常态。 若某个公开可得的信号能稳定、大幅地预测收益,交易者会买入被预测上涨的资产直到预期收益被价格吸收。剩下来能被发现的可预测性,要么很小,要么需要承担风险或成本作为补偿(第14章、第24–27章的因子溢价解释)。所以金融里“R 2 R^2 R 2 R 2 R^2 R 2
为什么关系会变。 市场参与者会学习并利用已发表的规律;监管、市场结构、利率体制会改变;资金流入同一策略会压缩其收益。这些都使 E [ y ∣ x ] E[y\mid x] E [ y ∣ x ]
与 Kaggle 类竞赛的差别。 以允许反复公开榜提交、近似同分布的竞赛作为典型简化对照;不同竞赛也可能有时间划分、提交限制和分布漂移。金融里:你只有一条历史路径,测试期只能真正使用一次;分布随时间漂移;评价目标是成本后的风险调整收益,而不是预测指标;你的交易会影响价格和成本(第35、36章)。竞赛中的常用技巧,如随机打乱后做 K 折交叉验证、在公开排行榜上反复调参,在本章重叠标签结构下可能引入重叠泄漏,反复测试调参则引入选择泄漏;随机拆分的具体问题应按信息与标签结构诊断。
可实现性。 一个模型的价值取决于它的预测能否在 trade_time 之前算出、能否以合理成本成交、在容量和借券约束下能否放大。这些不在模型的损失函数里,必须在评价中补上。
8. Numerical Example
8.1 十日案例:输入
(教学构造。)日收益 r r r κ = 0.001 \kappa=0.001 κ = 0.001 p 0 = 0 p_0=0 p 0 = 0 p B p^B p B p A p^A p A p BH p^{\text{BH}} p BH
日 t t t
1
2
3
4
5
6
7
8
9
10
r t r_t r t +0.4
+0.3
−0.2
+0.5
−3.0
+0.4
+0.2
−0.1
+0.3
−2.5
p B p^B p B +1
+1
−1
+1
+1
+1
+1
−1
+1
+1
p A p^A p A +1
+1
+1
+1
−1
−1
−1
−1
+1
−1
p BH p^{\text{BH}} p BH +1
+1
+1
+1
+1
+1
+1
+1
+1
+1
8.2 手算准确率与毛收益
∑ t ∣ r t ∣ = 0.4 + 0.3 + 0.2 + 0.5 + 3.0 + 0.4 + 0.2 + 0.1 + 0.3 + 2.5 = 7.9 \sum_t|r_t|=0.4+0.3+0.2+0.5+3.0+0.4+0.2+0.1+0.3+2.5=7.9 ∑ t ∣ r t ∣ = 0.4 + 0.3 + 0.2 + 0.5 + 3.0 + 0.4 + 0.2 + 0.1 + 0.3 + 2.5 = 7.9
B:错在第5、10日,∑ 错 ∣ r ∣ = 3.0 + 2.5 = 5.5 \sum_{\text{错}}|r|=3.0+2.5=5.5 ∑ 错 ∣ r ∣ = 3.0 + 2.5 = 5.5 A c c = 8 / 10 = 0.80 \mathrm{Acc}=8/10=0.80 Acc = 8/10 = 0.80 = ( 7.9 − 5.5 ) − 5.5 = − 3.1 % =(7.9-5.5)-5.5=-3.1\% = ( 7.9 − 5.5 ) − 5.5 = − 3.1% A c c ∣ r ∣ = 2.4 / 7.9 = 0.304 \mathrm{Acc}_{|r|}=2.4/7.9=0.304 Acc ∣ r ∣ = 2.4/7.9 = 0.304
A:错在第3、6、7日,∑ 错 ∣ r ∣ = 0.2 + 0.4 + 0.2 = 0.8 \sum_{\text{错}}|r|=0.2+0.4+0.2=0.8 ∑ 错 ∣ r ∣ = 0.2 + 0.4 + 0.2 = 0.8 A c c = 0.70 \mathrm{Acc}=0.70 Acc = 0.70 = ( 7.9 − 0.8 ) − 0.8 = + 6.3 % =(7.9-0.8)-0.8=+6.3\% = ( 7.9 − 0.8 ) − 0.8 = + 6.3% A c c ∣ r ∣ = 7.1 / 7.9 = 0.899 \mathrm{Acc}_{|r|}=7.1/7.9=0.899 Acc ∣ r ∣ = 7.1/7.9 = 0.899
买入持有:错在4个下跌日,∑ 错 ∣ r ∣ = 0.2 + 3.0 + 0.1 + 2.5 = 5.8 \sum_{\text{错}}|r|=0.2+3.0+0.1+2.5=5.8 ∑ 错 ∣ r ∣ = 0.2 + 3.0 + 0.1 + 2.5 = 5.8 A c c = 0.60 \mathrm{Acc}=0.60 Acc = 0.60 = 2.1 − 5.8 = − 3.7 % =2.1-5.8=-3.7\% = 2.1 − 5.8 = − 3.7%
用恒等式 ∑ p t r t = ( ∑ ∣ r t ∣ ) ( 2 A c c ∣ r ∣ − 1 ) \sum p_tr_t=(\sum|r_t|)(2\mathrm{Acc}_{|r|}-1) ∑ p t r t = ( ∑ ∣ r t ∣ ) ( 2 Acc ∣ r ∣ − 1 ) 7.9 × ( 2 × 0.899 − 1 ) = 7.9 × 0.797 = 6.30 7.9\times(2\times0.899-1)=7.9\times0.797=6.30 7.9 × ( 2 × 0.899 − 1 ) = 7.9 × 0.797 = 6.30
8.3 换手与成本
B:p 0 = 0 → + 1 p_0=0\to+1 p 0 = 0 → + 1 + 1 → − 1 +1\to-1 + 1 → − 1 − 1 → + 1 -1\to+1 − 1 → + 1 9 × 0.1 % = 0.9 % 9\times0.1\%=0.9\% 9 × 0.1% = 0.9%
A:初始 1,第5日 + 1 → − 1 +1\to-1 + 1 → − 1
买入持有:1,成本 0.1%。
8.4 净收益:近似与精确
Acc
A c c ∣ r ∣ \mathrm{Acc}_{\lvert r\rvert} Acc ∣ r ∣ 毛收益和
换手
成本
累加近似净值
复利精确净收益
A
0.70
0.899
+6.30%
7
0.70%
+5.60%
+5.6879%
B
0.80
0.304
−3.10%
9
0.90%
−4.00%
−3.9980%
买入持有
0.60
0.266
−3.70%
1
0.10%
−3.80%
−3.8072%
零仓位
—
—
0
0
0
0
0
精确列由 W 10 = ∏ t = 1 10 ( 1 + n t ) W_{10}=\prod_{t=1}^{10}(1+n_t) W 10 = ∏ t = 1 10 ( 1 + n t ) n 1 = 0.004 − 0.001 = 0.003 n_1=0.004-0.001=0.003 n 1 = 0.004 − 0.001 = 0.003 W 1 = 1.003 W_1=1.003 W 1 = 1.003 n 3 = ( − 1 ) ( − 0.002 ) − 2 × 0.001 = 0 n_3=(-1)(-0.002)-2\times0.001=0 n 3 = ( − 1 ) ( − 0.002 ) − 2 × 0.001 = 0 W 3 = W 2 = 1.006009 W_3=W_2=1.006009 W 3 = W 2 = 1.006009 course/zh/chapters/ch37/figures/ch37_results.json,共 11 个财富点对应 10 个日收益。准确率最高的 B 输给了“什么都不做”的零仓位,也输给了买入持有。
8.5 一个 R 2 R^2 R 2
若某特征与次日收益的相关系数为 0.03,R 2 = 0.03 2 = 0.0009 R^2=0.03^2=0.0009 R 2 = 0.0 3 2 = 0.0009 ∣ ρ ∣ σ y = 0.0006 = 0.06 % |\rho|\sigma_y=0.0006=0.06\% ∣ ρ ∣ σ y = 0.0006 = 0.06%
9. Python Implementation
脚本:code/ch37_ml_philosophy.py。历史工程脚本可重算构造实验;工作树版本即使指定新 --out 仍可能覆盖原章图,故此处不提供直接覆盖指令。默认接受读者包中的第37章 Notebook会新算十日案例、100000重叠日、三组各200次零信号实验和状态切换,并在唯一运行目录写十日财富图;本批仅解释该行为,未执行。CLI历史先计算 N = 1 N=1 N = 1
输入全部为脚本内的教学构造参数与固定种子(3701 状态切换、3702 多重检验、3703 重叠标签);输出 ch37_results.json(拒绝覆盖已有文件)及三张图。数据频率为日频;十日案例的 signal_time 为前一日收盘、trade_time 为当日开盘、收益区间为开盘到次日开盘。缺失值策略:输入出现 NaN 或 inf 直接报错,不填补。
核心函数:
decision_ledger(returns, positions, cost_per_unit):返回逐日毛收益、换手、净收益与 T + 1 T+1 T + 1 magnitude_identity(returns, positions):核对 6.1 节恒等式。overlap_autocorrelation(h, n_days, seed):重叠标签的样本自相关与理论值 ( h − k ) / h (h-k)/h ( h − k ) / h max_null_sharpe(n_strategies, n_days, n_sims, seed):零真实信号下最佳样本内夏普与同一策略留出期夏普;复用第32章 quant_course.research_protocol.expected_max_standard_normal(_exact)。regime_shift(n_per_regime, slope, seed):状态1训练、状态2评价。
测试:tests/test_ch37_philosophy.py。下面的片段可以单独运行,核对十日案例:
import numpy as np
r = np.array([0.004 , 0.003 , -0.002 , 0.005 , -0.030 , 0.004 , 0.002 , -0.001 , 0.003 , -0.025 ])
models = {
"A" : np.array([1 , 1 , 1 , 1 , -1 , -1 , -1 , -1 , 1 , -1 ]),
"B" : np.array([1 , 1 , -1 , 1 , 1 , 1 , 1 , -1 , 1 , 1 ]),
}
kappa = 0.001
for name, p in models.items():
turnover = np.abs (np.diff(np.concatenate([[0 ], p])))
net = p * r - kappa * turnover
wealth = np.concatenate([[1.0 ], np.cumprod(1 + net)])
acc = np.mean(np.sign(p) == np.sign(r))
assert np.isclose((p * r).sum (), (np.abs (r) * (2 * (np.sign(p) == np.sign(r)) - 1 )).sum ())
print (name, f"acc={acc:.2 f} " , f"turnover={turnover.sum ()} " , f"net={wealth[-1 ] - 1 :+.6 f} " , f"points={wealth.size} " )
预期输出:A acc=0.70 turnover=7 net=+0.056879 points=11,B acc=0.80 turnover=9 net=-0.039980 points=11。
历史冻结运行的其余数字(ch37_results.json):
重叠标签 h = 5 h=5 h = 5 ( 0.802 , 0.604 , 0.403 , 0.203 , 0.004 ) (0.802,0.604,0.403,0.203,0.004) ( 0.802 , 0.604 , 0.403 , 0.203 , 0.004 ) ( 0.8 , 0.6 , 0.4 , 0.2 , 0 ) (0.8,0.6,0.4,0.2,0) ( 0.8 , 0.6 , 0.4 , 0.2 , 0 )
多重检验,T = 504 T=504 T = 504 N = 10 , 100 , 1000 N=10,100,1000 N = 10 , 100 , 1000 − 0.094 -0.094 − 0.094 − 0.052 -0.052 − 0.052 + 0.105 +0.105 + 0.105 N = 1000 N=1000 N = 1000
状态切换,每状态 1,000 个观测、b = 0.1 b=0.1 b = 0.1 + 0.0682 +0.0682 + 0.0682 R OS 2 = − 1.95 % R^2_{\text{OS}}=-1.95\% R OS 2 = − 1.95% R 2 R^2 R 2 0.01 / 1.01 = 0.99 % 0.01/1.01=0.99\% 0.01/1.01 = 0.99% b ^ = 0.0682 \hat b=0.0682 b ^ = 0.0682 1 − [ ( 0.1682 ) 2 + 1 ] / 1.01 ≈ − 1.81 % 1-[(0.1682)^2+1]/1.01\approx-1.81\% 1 − [( 0.1682 ) 2 + 1 ] /1.01 ≈ − 1.81% x x x
10. Visualization
图37-1:横轴为财富点编号(0 为起点,第 t t t t t t
图37-2:横轴为滚动窗口终点的观测编号,纵轴为 250 个观测窗口的 OLS 斜率(y y y x x x R OS 2 R^2_{\text{OS}} R OS 2
图37-3:左图横轴为尝试的零收益策略个数 N N N 252 / T E [ max Z N ] \sqrt{252/T}\,E[\max Z_N] 252/ T E [ max Z N ] N = 1000 N=1000 N = 1000 log N \log N log N
11. Real Market Example
本章不报告真实市场的实测数字。原因:本课程目前没有经许可可用于内部培训的日频个股价格面板(第 Project5 数据决策已记录 Yahoo、Alpha Vantage、Tiingo 等来源的条款限制);Project6 的真实数据状态为 blocked。没有数据时,本节只写清楚一个真实检验应如何做,以及文献里可以引用到哪一步。
应做的检验(数据获得后)。 取一个固定、事前冻结的股票池和样本期;用收盘可得的特征预测下一交易日开盘到开盘的收益;在按日期的 walk-forward 测试中同时报告:方向准确率、幅度加权准确率、IC 与 R OS 2 R^2_{\text{OS}} R OS 2
文献可支持到哪一步。 以下是作者实际读到的原文位置(详见 source_notes.md),它们是别人的样本和口径,不是本书的实测:
Gu, Kelly, Xiu(2020,RFS)对美国个股月度超额收益做大规模机器学习预测。其式(19)(第2249页)把样本外 R 2 R^2 R 2 零预测 、分母不减均值;作者说明对个股而言历史均值预测通常远差于零预测,若改用历史均值作基准,所有方法的月度 R 2 R^2 R 2 − 3.46 % -3.46\% − 3.46% R 2 R^2 R 2 R 2 R^2 R 2
Campbell, Thompson(2008;NBER 工作论文 w11468 版本,式(1),第5页)对市场指数收益把 R OS 2 R^2_{\text{OS}} R OS 2 截至上一期的历史均值 ,并指出即使很小的样本外 R 2 R^2 R 2
两篇文章用了不同的基准:个股截面预测用零,指数择时用历史均值。本书第38、39章与 Project6 同时报告两种基准,并写明各自含义。
12. Common Mistakes
12.1 用准确率挑选交易模型
错误:按测试集准确率排序选 B。原因:准确率对每天等权,交易收益按 ∣ r t ∣ |r_t| ∣ r t ∣
import numpy as np
r = np.array([0.004 , 0.003 , -0.002 , 0.005 , -0.030 , 0.004 , 0.002 , -0.001 , 0.003 , -0.025 ])
A = np.array([1 , 1 , 1 , 1 , -1 , -1 , -1 , -1 , 1 , -1 ]); B = np.array([1 , 1 , -1 , 1 , 1 , 1 , 1 , -1 , 1 , 1 ])
acc = lambda p: np.mean(np.sign(p) == np.sign(r))
wrong_choice = max (("A" , A), ("B" , B), key=lambda kv: acc(kv[1 ]))[0 ]
pnl = lambda p: (p * r).sum () - 0.001 * np.abs (np.diff(np.concatenate([[0 ], p]))).sum ()
right_choice = max (("A" , A), ("B" , B), key=lambda kv: pnl(kv[1 ]))[0 ]
print (wrong_choice, right_choice, round (pnl(A), 4 ), round (pnl(B), 4 ))
修复:用与决策一致的目标评价,至少同时报告准确率、幅度加权准确率和成本后收益。
12.2 不计换手
错误:只报告毛收益。原因:翻转方向的模型换手大,十日案例中 B 的成本 0.9% 超过 A 的 0.7%;若作示意年化,应先把十日累计成本除以10得到日均,再乘252;不能把十日累计差直接乘252。该外推并不保证未来换手频率不变。修复:评价时把换手和成本列入同一张表;成本口径沿用第35章。
12.3 在全样本里挑最好的策略,再在同一样本里报告
错误代码(零真实信号,100 个策略,挑最好的报告其样本内夏普):
import numpy as np
rng = np.random.default_rng(0 )
ins, outs = rng.normal(0 , 0.01 , (504 , 100 )), rng.normal(0 , 0.01 , (504 , 100 ))
sr = lambda x: np.sqrt(252 ) * x.mean(0 ) / x.std(0 , ddof=1 )
k = int (np.argmax(sr(ins)))
print ("reported (in-sample) Sharpe:" , round (float (sr(ins)[k]), 2 ))
print ("same strategy, holdout:" , round (float (sr(outs[:, [k]])[0 ]), 2 ))
本书运行打印 1.92 与 0.83。单次留出期夏普的抽样标准差约 252 / 504 = 0.71 \sqrt{252/504}=0.71 252/504 = 0.71
12.4 把重叠标签当独立样本
错误:每天计算一次 5 日未来收益,对 1,000 个日期直接用 s / 1000 s/\sqrt{1000} s / 1000
import numpy as np
rng = np.random.default_rng(1 )
u = rng.normal(0.0005 , 0.01 , 1005 )
y = np.convolve(u, np.ones(5 ), mode="valid" )[:1000 ]
naive_se = y.std(ddof=1 ) / np.sqrt(len (y))
nonoverlap = y[::5 ]
honest_se = nonoverlap.std(ddof=1 ) / np.sqrt(len (nonoverlap))
print (round (honest_se / naive_se, 2 ))
已知本构造协方差时可直接使用6.4节精确均值方差;第23章 ic_summary(nw_lags=h-1) 是既定Bartlett核诊断,固定 h − 1 h-1 h − 1
12.5 数据泄漏(五类各一例)
类别
错误写法
修复
目标泄漏
特征“过去5日收益”误用 shift(-5) 计算,实际是未来5日收益
每个特征登记 available_at,断言 available_at ≤ 精确决策截点(日期与时刻的区别见第38章)
前视特征
用季报“报告期末日”作为财务数据可用时点
用公告/入库时点(第3、第12章 PIT)
预处理泄漏
先对全样本做标准化,再切训练/测试
标准化器只在训练行上拟合(第38章 Pipeline)
选择泄漏
看了测试结果再改特征、再测
测试只用一次;改设计要换新的留出期并记入试验账本
重叠泄漏
随机打乱后 K 折交叉验证,训练标签区间覆盖测试标签区间
按日期划分,按实际标签区间排除训练行(第31、38章)
第38章给出预处理泄漏和随机 K 折的可运行反例与数值差。
12.6 没有基准
错误:报告“样本外 R 2 = 0.3 % R^2=0.3\% R 2 = 0.3% R OS 2 R^2_{\text{OS}} R OS 2
13. Quant Research Application
把本章变成一份评价协议,第38–40章与 Project6 都按它执行。
假设。 写成可以被证伪的形式:“收盘可得的特征集合 X X X h h h κ \kappa κ
设计(冻结后才看结果)。 资产池、样本期、频率、signal_time/trade_time、标签区间、特征清单、模型族与超参数网格、训练窗口、调仓频率、成本假设、评价指标与通过门槛。冻结前看过哪些结果要登记(第22章 TrialLedger)。
五项同时检查。
样本外:按日期 walk-forward;预测指标(IC、R OS 2 R^2_{\text{OS}} R OS 2
稳定性:逐折、逐年的 IC 与收益;系数或重要性在各折间是否同号;状态切换前后是否反转。
成本:至少两个成本水平;换手;成本前后的差额。
尾部:最大回撤、最差 1% 日、在大波动日的方向准确率。
经济逻辑:信号为什么应该有效,谁在付出这份收益;若无法回答,结果再好也只是候选。
基准。 零预测(空仓)、训练均值(截面上全部相同的预测,排序组合为空仓)、一个简单规则。候选模型必须在同一测试期、同一成本下优于基准才进入下一步。
反证条件(任一成立即不支持假设)。 成本后净收益不大于零;R OS 2 R^2_{\text{OS}} R OS 2 t t t
零与负结果。 保留并报告。第39章与 Project6 的构造实验中,有些模型在成本后输给零仓位,这些结果与正结果同样写入报告。
14. Chapter Summary
准确率、R 2 R^2 R 2 ± 1 \pm1 ± 1 ∑ p t r t = ( ∑ ∣ r t ∣ ) ( 2 A c c ∣ r ∣ − 1 ) \sum p_tr_t=(\sum|r_t|)(2\mathrm{Acc}_{|r|}-1) ∑ p t r t = ( ∑ ∣ r t ∣ ) ( 2 Acc ∣ r ∣ − 1 ) R 2 R^2 R 2 1 / h 1/h 1/ h N N N 252 / T E [ max Z N ] \sqrt{252/T}\,E[\max Z_N] 252/ T E [ max Z N ] R 2 R^2 R 2
15. Exercises
37-E01(手算:准确率与净收益)
日收益(%)r = ( + 1.0 , − 0.2 , + 0.3 , − 4.0 , + 0.2 ) r=(+1.0,\,-0.2,\,+0.3,\,-4.0,\,+0.2) r = ( + 1.0 , − 0.2 , + 0.3 , − 4.0 , + 0.2 ) ( + 1 , − 1 , + 1 , + 1 , + 1 ) (+1,-1,+1,+1,+1) ( + 1 , − 1 , + 1 , + 1 , + 1 ) ( − 1 , − 1 , − 1 , − 1 , + 1 ) (-1,-1,-1,-1,+1) ( − 1 , − 1 , − 1 , − 1 , + 1 ) κ = 0.1 % \kappa=0.1\% κ = 0.1% p 0 = 0 p_0=0 p 0 = 0
37-E02(换手)
证明:± 1 \pm1 ± 1 q q q T T T 1 + 2 q ( T − 1 ) 1+2q(T-1) 1 + 2 q ( T − 1 ) q = 0.5 q=0.5 q = 0.5 T = 252 T=252 T = 252 κ = 0.1 % \kappa=0.1\% κ = 0.1%
37-E03(状态切换)
在 6.6 节模型中,若用状态1 的完美估计 b ^ = b \hat b=b b ^ = b b = 0.2 b=0.2 b = 0.2 R OS 2 R^2_{\text{OS}} R OS 2
37-E04(信噪比)
y = b x + ε y=bx+\varepsilon y = b x + ε σ x = 1 \sigma_x=1 σ x = 1 σ ε = 2 % \sigma_\varepsilon=2\% σ ε = 2% b b b R 2 R^2 R 2
37-E05(重叠标签)
h = 10 h=10 h = 10
37-E06(多重检验)
T = 252 T=252 T = 252 N = 50 N=50 N = 50 E [ max Z 50 ] ≈ 2.25 E[\max Z_{50}]\approx2.25 E [ max Z 50 ] ≈ 2.25
37-E07(泄漏分类)
判断下列各属于哪一类泄漏,并给出修复:(a) 用全样本的特征中位数填补缺失;(b) 用测试期的 IC 决定保留哪 5 个特征;(c) 特征“分析师预测修正”使用的是事后修订后的数据库版本;(d) 用随机 10 折交叉验证评估 20 日收益标签的模型。
37-E08(与竞赛的差别)
列出三条金融预测与典型机器学习竞赛在数据生成或评价上的差别,并为每一条说明它会使哪种常见做法失效。
37-E09(基准)
某模型测试期 ∑ ( y − y ^ ) 2 = 0.981 \sum(y-\hat y)^2=0.981 ∑ ( y − y ^ ) 2 = 0.981 ∑ y 2 = 0.990 \sum y^2=0.990 ∑ y 2 = 0.990 ∑ ( y − y ˉ train ) 2 = 0.985 \sum(y-\bar y_{\text{train}})^2=0.985 ∑ ( y − y ˉ train ) 2 = 0.985 R OS 2 R^2_{\text{OS}} R OS 2
37-T01(新增:从分数到三张表)
研究员报告准确率55%,未说明信息入库、成交时点和成本。按“信息表→预测表→账本”各写一个必须补齐的字段,并说明本章下一开盘例与第38–39章下一收盘例能否直接共用标签。
16. Programming Exercises
37-P01(决策账本)
实现 decision_ledger(returns, positions, cost_per_unit),返回逐日换手、净收益和 T + 1 T+1 T + 1 + 0.056879 +0.056879 + 0.056879 − 0.039980 -0.039980 − 0.039980 10 − 6 10^{-6} 1 0 − 6 ± 1 \pm1 ± 1 ValueError;(5) 某日净收益 ≤ − 100 % \le-100\% ≤ − 100%
37-P02(有效样本量)
写函数,输入 h h h h h h h = 5 h=5 h = 5 N ( 0 , 1 % ) N(0,1\%) N ( 0 , 1% ) ( h − k ) / h (h-k)/h ( h − k ) / h
37-P03(选择偏差)
模拟 N ∈ { 10 , 100 , 1000 } N\in\{10,100,1000\} N ∈ { 10 , 100 , 1000 } T = 504 T=504 T = 504 252 / T E [ max Z N ] \sqrt{252/T}\,E[\max Z_N] 252/ T E [ max Z N ]
17. Challenge Problems
37-C01(窗口长度的权衡)
在 6.6 节模型里,真实斜率在未知时点从 b b b − b -b − b L L L s s s s < L s<L s < L L L L σ x = σ ε = 1 \sigma_x=\sigma_\varepsilon=1 σ x = σ ε = 1 1 / L 1/L 1/ L M M M L L L M M M
37-C02(设计一份评价协议)
为“用 20 个收盘特征预测未来 5 日截面收益”的研究写一页评价协议,覆盖第13节五项检查、三个基准、冻结内容和反证条件。开放题,评分见第18节。
18. Solutions / Solution Hints
37-E01
∣ r ∣ |r| ∣ r ∣ 1.0 + 0.2 + 0.3 + 4.0 + 0.2 = 5.7 1.0+0.2+0.3+4.0+0.2=5.7 1.0 + 0.2 + 0.3 + 4.0 + 0.2 = 5.7 + 1 +1 + 1 − 4.0 -4.0 − 4.0 A c c = 4 / 5 = 0.80 \mathrm{Acc}=4/5=0.80 Acc = 4/5 = 0.80 A c c ∣ r ∣ = 1.7 / 5.7 = 0.298 \mathrm{Acc}_{|r|}=1.7/5.7=0.298 Acc ∣ r ∣ = 1.7/5.7 = 0.298 1.7 − 4.0 = − 2.3 % 1.7-4.0=-2.3\% 1.7 − 4.0 = − 2.3% 0 → + 1 0\to+1 0 → + 1 + 1 → − 1 +1\to-1 + 1 → − 1 − 1 → + 1 -1\to+1 − 1 → + 1 − 2.8 % -2.8\% − 2.8% A c c = 0.60 \mathrm{Acc}=0.60 Acc = 0.60 ∣ r ∣ = 1.3 |r|=1.3 ∣ r ∣ = 1.3 A c c ∣ r ∣ = 4.4 / 5.7 = 0.772 \mathrm{Acc}_{|r|}=4.4/5.7=0.772 Acc ∣ r ∣ = 4.4/5.7 = 0.772 4.4 − 1.3 = + 3.1 % 4.4-1.3=+3.1\% 4.4 − 1.3 = + 3.1% − 1 → + 1 -1\to+1 − 1 → + 1 + 2.8 % +2.8\% + 2.8%
37-E02
第1日从 0 建仓,换手 1。之后每天以概率 q q q = 1 + ∑ t = 2 T 2 q = 1 + 2 q ( T − 1 ) =1+\sum_{t=2}^T2q=1+2q(T-1) = 1 + ∑ t = 2 T 2 q = 1 + 2 q ( T − 1 ) q = 0.5 q=0.5 q = 0.5 T = 252 T=252 T = 252 1 + 251 = 252 1+251=252 1 + 251 = 252 252 × 0.1 % = 25.2 % 252\times0.1\%=25.2\% 252 × 0.1% = 25.2%
37-E03
b ^ = b = 0.2 \hat b=b=0.2 b ^ = b = 0.2 R OS 2 = 1 − [ ( 0.4 ) 2 + 1 ] / ( 0.04 + 1 ) = 1 − 1.16 / 1.04 = − 11.5 % R^2_{\text{OS}}=1-[(0.4)^2+1]/(0.04+1)=1-1.16/1.04=-11.5\% R OS 2 = 1 − [( 0.4 ) 2 + 1 ] / ( 0.04 + 1 ) = 1 − 1.16/1.04 = − 11.5% y = ε y=\varepsilon y = ε E [ ( y − b ^ x ) 2 ] = 1 + b ^ 2 = 1.04 E[(y-\hat bx)^2]=1+\hat b^2=1.04 E [( y − b ^ x ) 2 ] = 1 + b ^ 2 = 1.04 E [ y 2 ] = 1 E[y^2]=1 E [ y 2 ] = 1 R OS 2 = − 4 % R^2_{\text{OS}}=-4\% R OS 2 = − 4%
37-E04
ρ = b σ x / b 2 σ x 2 + σ ε 2 = 0.05 \rho=b\sigma_x/\sqrt{b^2\sigma_x^2+\sigma_\varepsilon^2}=0.05 ρ = b σ x / b 2 σ x 2 + σ ε 2 = 0.05 b 2 = 0.0025 ( b 2 + 0.0004 ) b^2=0.0025(b^2+0.0004) b 2 = 0.0025 ( b 2 + 0.0004 ) b 2 ( 1 − 0.0025 ) = 10 − 6 b^2(1-0.0025)=10^{-6} b 2 ( 1 − 0.0025 ) = 1 0 − 6 b = 0.001001 b=0.001001 b = 0.001001 x x x R 2 = 0.0025 R^2=0.0025 R 2 = 0.0025 S N R = R 2 / ( 1 − R 2 ) = 0.002506 \mathrm{SNR}=R^2/(1-R^2)=0.002506 SNR = R 2 / ( 1 − R 2 ) = 0.002506
37-E05
ρ 1 = 0.9 \rho_1=0.9 ρ 1 = 0.9 ρ 5 = 0.5 \rho_5=0.5 ρ 5 = 0.5 ρ 10 = 0 \rho_{10}=0 ρ 10 = 0 2520 / 10 = 252 2520/10=252 2520/10 = 252
37-E06
252 / 252 × 2.25 = 2.25 \sqrt{252/252}\times2.25=2.25 252/252 × 2.25 = 2.25
37-E07
(a) 预处理泄漏:中位数只用训练行计算,或用每个日期截面中位数(只用当日信息)。(b) 选择泄漏:特征选择放在训练内(内层验证),测试只评价一次。(c) 前视特征:使用 point-in-time 版本,按数据入库时点筛选。(d) 重叠泄漏:20 日标签在随机折之间重叠;改为按日期 walk-forward,并按实际标签区间排除训练行。
37-E08
参考答案(任三条,各需对应失效做法):(1) 分布漂移:典型简化竞赛近似同分布;金融中的时间漂移使随机划分可能把未来状态混入训练,应按实际信息结构判断。(2) 测试集只有一次:部分竞赛允许反复公开榜提交;金融里反复看测试期即选择泄漏。(3) 目标不同:竞赛指标即目标;金融目标是成本后风险调整收益,准确率高可能亏钱。(4) 交易影响价格:竞赛的预测不改变答案;交易规模影响成本与容量。评分:每条差别 1 分,对应失效做法 1 分。
37-E09
相对零:1 − 0.981 / 0.990 = 0.91 % 1-0.981/0.990=0.91\% 1 − 0.981/0.990 = 0.91% 1 − 0.981 / 0.985 = 0.41 % 1-0.981/0.985=0.41\% 1 − 0.981/0.985 = 0.41% 1 − 0.985 / 0.990 = 0.51 % 1-0.985/0.990=0.51\% 1 − 0.985/0.990 = 0.51%
37-P01 参考实现与测试
参考实现即 code/ch37_ml_philosophy.py 的 decision_ledger;测试在 tests/test_ch37_philosophy.py,包括十日案例数值、财富点个数、恒等式、非有限输入和 − 100 % -100\% − 100%
.venv/bin/python -m pytest tests/test_ch37_philosophy.py -q
数值核对:A 的财富路径第 5 点 1.037269、终点 1.056879;B 的终点 0.960020。
37-P02
参考实现 overlap_autocorrelation。本书运行(种子 3703)样本自相关 ( 0.802 , 0.604 , 0.403 , 0.203 , 0.004 ) (0.802,0.604,0.403,0.203,0.004) ( 0.802 , 0.604 , 0.403 , 0.203 , 0.004 ) mode="valid" 并截断到相同长度。
37-P03
参考实现 max_null_sharpe;本书运行(种子 3702)样本内均值 1.138、1.814、2.304,公式值 1.088、1.773、2.292,差都小于 0.06;留出期均值 − 0.094 -0.094 − 0.094 − 0.052 -0.052 − 0.052 + 0.105 +0.105 + 0.105
37-C01 参考论证
(1) 窗口内有 L − s L-s L − s s s s x x x E [ b ^ ] ≈ ( L − s ) b + s ( − b ) L = b ( 1 − 2 s / L ) E[\hat b]\approx\frac{(L-s)b+s(-b)}{L}=b(1-2s/L) E [ b ^ ] ≈ L ( L − s ) b + s ( − b ) = b ( 1 − 2 s / L ) s = L / 2 s=L/2 s = L /2 s = L s=L s = L σ 2 / ( L σ x 2 ) \sigma^2/(L\sigma_x^2) σ 2 / ( L σ x 2 ) 1 / L 1/L 1/ L L L L L / M L/M L / M 1 / L 1/L 1/ L A L / M + B / L A L/M+B/L A L / M + B / L A / M − B / L 2 = 0 A/M-B/L^2=0 A / M − B / L 2 = 0 L ≈ B M / A L\approx\sqrt{BM/A} L ≈ B M / A M M M L L L L L L
37-C02 评分准则
满分 10 分:五项检查各 1 分(须写出具体指标,如“IC 的 Newey–West t 值,滞后 4”);三个基准 1 分;冻结清单包含时间约定与成本 1 分;反证条件可操作 1 分;说明冻结前看过的结果并登记 1 分;指出零与负结果的保留方式 1 分。可接受的结论包括“证据不足”;把构造数据结果当真实证据扣 3 分。
37-T01 完整解答
信息表可补特征available_at、标签label_available_at、fit_time或精确信号截点,并检查当时可读;预测表可补信号日期、资产、预测值或评价日期集;账本可补trade_time、仓位、换手或成本。每张表任一字段且解释作用即可。55%未包含这些契约,不能直接推出净收益。下一开盘与下一收盘对应不同收益起点,不能共用一个未经重定义的标签;第38章会把精确时刻与日期索引分开。
19. Further Reading
Must Know:第22章(研究方案、多重检验)、第32章(DSR与HAC)、第31章(标签区间、purging、walk-forward)。用途:本章 6.4–6.5 节的工具来源。
Must Know:scikit-learn《Common pitfalls and recommended practices》(SK_PITFALLS),数据泄漏与训练内预处理两节。用途:第12.5节泄漏分类的软件侧对照。
Should Know:Bailey, Borwein, López de Prado, Zhu(2017)关于回测过拟合概率(PBO)。用途:把 6.5 节的选择偏差推广到组合级的过拟合概率。
Should Know:第20节列出的机器学习资产定价与回测协议文献,读其样本外 R 2 R^2 R 2
Optional:第35、36章,复习换手成本与执行。
20. References
SK_PITFALLS:scikit-learn, Common pitfalls and recommended practices。支持第5节预处理泄漏定义与第12.5节修复写法。PBO:Bailey, D. H., Borwein, J., López de Prado, M., Zhu, Q. J. (2017). The probability of backtest overfitting. Journal of Computational Finance. 支持第6.5节选择偏差的背景。DSR:Bailey, D. H., López de Prado, M. (2014). The Deflated Sharpe Ratio. 支持第6.5节 E [ max Z ] E[\max Z] E [ max Z ] expected_max_standard_normal 实现)。CH22_HLZ2014:Harvey, Liu, Zhu. …and the Cross-Section of Expected Returns. 支持第5节多重检验在因子研究中的背景。CH37_GKX2020:Gu, S., Kelly, B., Xiu, D. (2020). Empirical Asset Pricing via Machine Learning. Review of Financial Studies 33(5), 2223–2273. 作者核读:§1.8 式(19)第2249页(R OS 2 R^2_{\text{OS}} R OS 2 − 3.46 % -3.46\% − 3.46% R OS 2 R^2_{\text{OS}} R OS 2 CH37_CT2008:Campbell, J. Y., Thompson, S. B. (2008). Predicting Excess Stock Returns Out of Sample: Can Anything Beat the Historical Average? Review of Financial Studies 21(4), 1509–1531;作者读 NBER w11468 版本式(1)第5页。支持第5节历史均值基准定义。CH37_AHM2019:Arnott, R., Harvey, C. R., Markowitz, H. (2019). A Backtesting Protocol in the Era of Machine Learning. Journal of Financial Data Science 1(1), 64–74。来源侦察报告读到全文(引言、交易成本一节);作者未重新打开,仅作第13节评价协议的延伸阅读。泄漏的学术定义(Kaufman 等 2012)与“准确率与经济收益背离”的专题论文(Leung 等 2021)均因访问限制未读到全文,本章不引用其具体结论;对应内容由第6.1节推导与 SK_PITFALLS 支撑。核读记录见 course/zh/chapters/ch37/source_notes.md。