第 28 章/ 45
多因子模型(Multi-Factor Models):预处理、合成与约束
主线:多因子流程有三个互不替代的职责。预处理(preprocessing)只改变单个信号的尺度、离群值与不想要的暴露,而且只用同一天的截面;合成(combination)决定几个信号怎样相加,权重必须在看到评价期收益之前定下;约束(constraints)决定最终组合允许有哪些暴露。三件事混在一起,就会出现“用测试期收益选权重”“用全样本均值做标准化”“用事后顺序做正交化”这些不报错、但让结果不可信的错误。
先修:第24章(价值与时点基本面)、第25章(动量)、第26章(质量)、第27章(套息与低风险)、第23章(截面研究)、第21章(组合构造)。完成后你能:写出同日 z 分数、分位数缩尾(winsorization)、秩与正态分数的定义与 IC 性质;用同日回归做行业与规模中性化,并说明它与对权重做线性约束投影的关系;写出两个相关信号的合成 IC 与正交化顺序对它的影响;写出缺失因子的两种处理及各自的尺度偏差;说明“全样本拟合的标准化”为什么不能用;用已发布的因子收益说明相关系数会随时间变号,并写出多元化后夏普比率的公式。
1. 本章目标
读者应能回答:一个原始信号变成可交易组合之前,要经过哪些步骤、每一步用到哪一天的数据;为什么对信号做中性化可以恢复被行业偏移稀释的 IC;两个相关的因子合成时,谁先谁后为什么会改变结果;一个公司缺了一个因子该怎么办;权重能不能用评价期的表现来选。
区分三层职责:预处理(单个信号、同日截面)、合成(多个信号、权重事前固定)、约束(组合层面的暴露限制),并说明每一层可以用哪些数据。
写出并实现同日的缩尾、z 分数、稳健 z 分数、秩与正态分数;说明哪些变换保持 Spearman IC、哪些改变 Pearson IC。
推导一个信号带有与收益无关的干扰成分(行业偏移、规模载荷、离群值)时 Pearson IC 被衰减的因子 1 / 1 + σ 干扰 2 / σ 真 2 1/\sqrt{1+\sigma_\text{干扰}^2/\sigma_\text{真}^2} 1/ 1 + σ 干扰 2 / σ 真 2
推导同日回归中性化的代数:带全部行业虚拟变量时残差等于组内去均值;带规模控制时是 Frisch–Waugh–Lovell 的两步;残差与控制变量正交;冗余设计(行业虚拟变量加截距)下残差不变;对与信号成正比的权重,线性约束投影与中性化给出同一个向量,对分位数权重不是。
写出两个标准化信号合成的 IC ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) (\rho_1+\rho_2)/\sqrt{2(1+r_{12})} ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) ∝ R − 1 ρ \propto R^{-1}\rho ∝ R − 1 ρ
说明缺失因子的“补零”与“按可得因子重新加权”各自改变了谁的尺度,用方差公式 ( 1 + ( k − 1 ) r ˉ ) / k (1+(k-1)\bar r)/k ( 1 + ( k − 1 ) r ˉ ) / k
说明全样本标准化的前视问题,写出一个只用过去的 expanding 版本,并给出数值反例。
读已发布的 FF5 因子收益:相关矩阵、HML 与 RMW 的相关系数在 1963–1999 与 2000–2026 符号相反、滚动相关的范围;写出等风险平均后夏普比率的公式并核对。
报告三种组合构造(中性化信号的分位数权重、原始合成的分位数权重、原始合成后投影到行业中性)的收益、风险与暴露,并说明这是构造面板上的结果。
完成标准:任何多因子信号都附一张流程表,写明每一步的顺序、用到哪一天、参数(缩尾分位数、z 分数的自由度、最少因子数、权重)是谁在什么时候定的,以及被剔除或补齐的名字所占比例。
2. 为什么 Quant 需要它
第24至27章各自构造了一个因子:价值、动量、质量、套息与低风险。它们的量纲不同(比率、收益、会计比率、beta),截面分布不同(有的重尾),含有与收益无关的成分(行业偏移、规模),彼此相关,覆盖的名字也不同。把它们压成一个可以排序的分数,每一步都有研究者的选择,每个选择都能在评价期收益上看出“好坏”,所以每个选择都是一个自由度。第22章已经说明这些自由度会被计数;本章说明它们各自对应的数学对象,以及哪一步用到哪一天的数据。
本章的三条纪律。第一,预处理只用同一天的截面:行 t t t t t t
逻辑链:先写同日变换(6.1),推导干扰成分对 IC 的衰减(6.2)与中性化的代数(6.3);再写合成的 IC 与顺序依赖(6.4)、权重的选择(6.5)、缺失因子(6.6);然后写时间序列标准化的前视问题(6.7)、因子相关与多元化(6.8)、拥挤的定义(6.9);最后在构造面板(10 节)与已发布的因子收益(11 节)上报告。
3. 直觉
想象三位分析师各给 300 只股票打分。第一位的分数里混进了所属行业的整体乐观程度(每只科技股都高了 2 分),第二位偶尔把一两只股票打成 ±12 分的离群值,第三位的分数与市值有关。直接按分数排序,第一位的排名主要在比行业,第二位的离群值把方差撑大,第三位的多空组合其实在做多小盘。预处理就是在合成之前,把这些与收益无关的成分一步一步拿掉:同一天内把离群值缩回(缩尾),把行业与规模的影响回归掉(中性化),再把尺度统一(z 分数)。
合成是另一件事:三位分析师的分数相加,权重怎么给?如果两位分析师高度相关,他们说的是同一件事,相加不会增加多少信息;如果先让第一位说完,再只听第二位“第一位没说到的部分”(正交化),那么谁先谁后就会改变第二位剩下的内容。如果用“过去哪位表现好就给他更高权重”,而这个“过去”恰好就是评价期,那就是用答案选权重。
约束是最后一步:最终的多空组合,每个行业的净仓位是不是要为零,对市场、对规模的暴露是不是要限制。这一步可以通过对信号做中性化来近似,也可以直接对权重做投影;它们在线性情形是同一个运算。
简化的边界:本章的构造面板里,行业偏移、规模载荷与离群值都是我设定的干扰,所以中性化与缩尾有益;真实数据里,行业偏移本身可能带来收益,那时中性化会拿走真信号,结论相反(本章没有模拟这种情形)。
3.1 从一行数到持仓:每一步交出的对象不同
完整例题:从原始值到合成分数
沿用第8.2节六名截面,行业为 A/A/A/B/B/B,原始值 ( 1 , − 1 , 0 , 11 , 10 , 9 ) (1,-1,0,11,10,9) ( 1 , − 1 , 0 , 11 , 10 , 9 ) e = ( 1 , − 1 , 0 , 1 , 0 , − 1 ) e=(1,-1,0,1,0,-1) e = ( 1 , − 1 , 0 , 1 , 0 , − 1 ) s = 4 / 5 = 0.894427 s=\sqrt{4/5}=0.894427 s = 4/5 = 0.894427 z = e / s z=e/s z = e / s 显式小例配置 ,不是越过P4生产60名门槛的特例。
再给一个同日已标准化的信号 z 2 = ( 1 , 0 , − 1 , 0 , − 1 , 1 ) / s z_2=(1,0,-1,0,-1,1)/s z 2 = ( 1 , 0 , − 1 , 0 , − 1 , 1 ) / s c = ( z + z 2 ) / 2 c=(z+z_2)/2 c = ( z + z 2 ) /2
名字/行业
原始x x x
残差e e e
z z z z 2 z_2 z 2 合成c c c
a/A
1
1
1.1180
1.1180
1.1180
b/A
-1
-1
-1.1180
0
-0.5590
c/A
0
0
0
-1.1180
-0.5590
d/B
11
1
1.1180
0
0.5590
e/B
10
0
0
-1.1180
-0.5590
f/B
9
-1
-1.1180
1.1180
0
原始值保留经济方向,残差解释“相对同业和控制变量”,z是可比尺度,合成是排序分数;它们都还不是美元头寸。若f缺第二项,按可得项重归一给 c f = − 1.1180 c_f=-1.1180 c f = − 1.1180 − 0.5590 -0.5590 − 0.5590
为什么在第24–26章定义字段后,还要这一章?因为比率/收益/会计量无法直接相加;同业残差、尺度、覆盖与权重必须逐层确定。缺失名单、因子相关和持仓交集一起报告,但持仓相似本身不足以推断真实拥挤(第6.9节)。
4. 数学基础
记号。 日期 t t t i = 1 , … , n t i=1,\dots,n_t i = 1 , … , n t x i , t x_{i,t} x i , t y i , t + 1 y_{i,t+1} y i , t + 1 t → t + 1 t\to t+1 t → t + 1 t t t t t t V t \mathcal V_t V t signal_time 是月末;评价期标签是下一个月。
同日 z 分数。 z i , t = ( x i , t − x ˉ t ) / s t z_{i,t}=(x_{i,t}-\bar x_t)/s_t z i , t = ( x i , t − x ˉ t ) / s t x ˉ t \bar x_t x ˉ t s t s_t s t V t \mathcal V_t V t s t = 0 s_t=0 s t = 0 ∣ V t ∣ < 3 |\mathcal V_t|<3 ∣ V t ∣ < 3
同日缩尾。 取该日 V t \mathcal V_t V t q t − , q t + q^-_t,q^+_t q t − , q t +
x ~ i , t = min { max { x i , t , q t − } , q t + } .
\tilde x_{i,t}=\min\{\max\{x_{i,t},q^-_t\},q^+_t\}.
x ~ i , t = min { max { x i , t , q t − } , q t + } . 秩与正态分数。 平均名次 r i , t r_{i,t} r i , t ( r − 1 ) / ( n − 1 ) (r-1)/(n-1) ( r − 1 ) / ( n − 1 ) Φ − 1 ( ( r − 1 2 ) / n ) \Phi^{-1}\bigl((r-\tfrac12)/n\bigr) Φ − 1 ( ( r − 2 1 ) / n )
中性化。 对每个日期 t t t x i , t = ∑ g α g , t 1 { i ∈ g } + γ t c i , t + e i , t x_{i,t}=\sum_g\alpha_{g,t}\mathbf 1\{i\in g\}+\gamma_t\,c_{i,t}+e_{i,t} x i , t = ∑ g α g , t 1 { i ∈ g } + γ t c i , t + e i , t g g g c c c = e i , t =e_{i,t} = e i , t
正交化。 把信号 x ( 2 ) x^{(2)} x ( 2 ) x ( 1 ) x^{(1)} x ( 1 ) e ( 2 ) = x ( 2 ) − a − b x ( 1 ) e^{(2)}=x^{(2)}-a-b\,x^{(1)} e ( 2 ) = x ( 2 ) − a − b x ( 1 )
合成。 标准化信号 z ( k ) z^{(k)} z ( k ) w k w_k w k c i , t = ∑ k w k z i , t ( k ) / ∑ k ∣ w k ∣ c_{i,t}=\sum_kw_kz^{(k)}_{i,t}/\sum_k|w_k| c i , t = ∑ k w k z i , t ( k ) / ∑ k ∣ w k ∣
合成 IC。 设标准化信号方差为 1、相关矩阵 R R R K × K K\times K K × K ρ \rho ρ C o r r ( w ⊤ z , y ) = w ⊤ ρ / w ⊤ R w \mathrm{Corr}(w^\top z,y)=w^\top\rho/\sqrt{w^\top Rw} Corr ( w ⊤ z , y ) = w ⊤ ρ / w ⊤ R w ρ \rho ρ R R R 联合可行 :增广矩阵 ( R ρ ρ ⊤ 1 ) \begin{pmatrix}R&\rho\\\rho^\top&1\end{pmatrix} ( R ρ ⊤ ρ 1 ) R R R ρ ⊤ R − 1 ρ ≤ 1 \rho^\top R^{-1}\rho\le1 ρ ⊤ R − 1 ρ ≤ 1 ∣ ρ i ∣ ≤ 1 |\rho_i|\le1 ∣ ρ i ∣ ≤ 1 R = I 2 , ρ = ( 0.9 , 0.9 ) R=I_2,\rho=(0.9,0.9) R = I 2 , ρ = ( 0.9 , 0.9 ) 0.81 + 0.81 = 1.62 > 1 0.81+0.81=1.62>1 0.81 + 0.81 = 1.62 > 1
因子收益的多元化。 k k k S S S ρ ˉ \bar\rho ρ ˉ S p = S k / 1 + ( k − 1 ) ρ ˉ S_p=S\sqrt k/\sqrt{1+(k-1)\bar\rho} S p = S k / 1 + ( k − 1 ) ρ ˉ
5. 正式定义
同日截面变换(cross-sectional, same-date transform)。 日期 t t t t t t
时间序列标准化(time-series standardization)。 对一个信号的时间序列用其均值与标准差做标准化。全样本拟合 (full-sample fit)用全部日期估计均值与标准差,包含未来;expanding 版本在第 t t t ≤ t \le t ≤ t
缩尾(winsorization)。 把超出分位数区间的值放到区间端点,改变大小,不改变未被缩尾名字之间的顺序。
z 分数(z-score)、稳健 z 分数(MAD-based robust z-score)。 前者用均值与标准差,后者用中位数与 1.4826 × 1.4826\times 1.4826 ×
正态分数(normal scores)。 用名次把任意分布映射为标准正态分位数,丢掉原始幅度,对固定配对集合内不改变名次的极端幅度更稳健;新增离群名字、缺失或并列仍会改变映射,也不使Pearson IC免疫。
中性化(neutralization)。 对一组控制变量(行业虚拟变量、规模等)做同日回归取残差。行业中性(industry-neutral) :每个行业内的残差和为零。
正交化(orthogonalization)。 对已有信号回归取残差;多个信号依次正交化是 Gram–Schmidt 过程,顺序 决定每个信号保留什么。
合成(combining signals)、权重选择(weight choice)。 等权、固定经济权重、与发现期 IC 成比例、IC 最大化的 R − 1 ρ R^{-1}\rho R − 1 ρ
缺失因子(missing factor)。 某名字缺少某个因子的值。处理:补零 (零是 z 分数的均值)、按可得因子重新加权 (权重除以可得因子权重绝对值之和)、剔除 (要求全部可得)、最少因子数 (可得个数不足则 NaN)。
因子相关(factor correlation)。 两种:信号相关 (同日截面上两个信号的相关)与收益相关 (两个因子组合收益的时间序列相关)。前者影响合成 IC,后者影响多元化。
拥挤(crowding)。 本章的操作性定义:许多投资者持有相似的头寸,使得因子被迫去杠杆时收益同时下跌。可以用头寸重叠(同日前五分位集合的重叠比例)与压力期收益相关来描述;本章只有重叠的构造数值,没有真实持仓数据,所以不对真实拥挤下结论。
约束(constraints)。 对组合权重的线性限制 A w = b Aw=b A w = b project_to_constraints(第21章)求满足它的欧氏距离最近的权重。
6. 推导
6.1 同日变换对 IC 的作用
设每日截面上信号 x x x y y y a > 0 a>0 a > 0 b b b C o r r ( a x + b , y ) = C o r r ( x , y ) \mathrm{Corr}(ax+b,y)=\mathrm{Corr}(x,y) Corr ( a x + b , y ) = Corr ( x , y )
6.2 干扰成分对 IC 的衰减
设某日截面上观测信号 x = s + u x=s+u x = s + u s s s σ s 2 \sigma_s^2 σ s 2 u u u σ u 2 \sigma_u^2 σ u 2 u u u y y y C o v ( x , y ) = C o v ( s , y ) \mathrm{Cov}(x,y)=\mathrm{Cov}(s,y) Cov ( x , y ) = Cov ( s , y ) V a r ( x ) = σ s 2 + σ u 2 \mathrm{Var}(x)=\sigma_s^2+\sigma_u^2 Var ( x ) = σ s 2 + σ u 2
C o r r ( x , y ) = C o r r ( s , y ) 1 1 + σ u 2 / σ s 2 .
\mathrm{Corr}(x,y)=\mathrm{Corr}(s,y)\,\frac1{\sqrt{1+\sigma_u^2/\sigma_s^2}} .
Corr ( x , y ) = Corr ( s , y ) 1 + σ u 2 / σ s 2 1 . 干扰方差等于真信号方差时,IC 衰减到 1 / 2 = 0.71 1/\sqrt2=0.71 1/ 2 = 0.71 − 0.5 -0.5 − 0.5 0.3 0.3 0.3 0.25 , 0 , 0.09 0.25,0,0.09 0.25 , 0 , 0.09 0.02 × 64 = 1.28 0.02\times64=1.28 0.02 × 64 = 1.28 1 / 1 + 0.9 + c 2 + 1.28 1/\sqrt{1+0.9+c^2+1.28} 1/ 1 + 0.9 + c 2 + 1.28
缩尾去掉大部分离群值方差;中性化去掉行业偏移与规模载荷。这就是“每一步恢复一部分真实 IC”的算术。
注意前提:干扰与标签无关。若行业偏移本身预测收益,它就不是干扰,中性化会把它拿走。是否中性化取决于研究假设,要写入计划。
6.3 中性化的代数
带全部行业虚拟变量。 设 D D D n × G n\times G n × G G G G min α ∥ x − D α ∥ 2 \min_\alpha\|x-D\alpha\|^2 min α ∥ x − D α ∥ 2 e i = x i − x ˉ g ( i ) e_i=x_i-\bar x_{g(i)} e i = x i − x ˉ g ( i )
带规模控制。 设组内去均值后的信号与规模为 x ~ , c ~ \tilde x,\tilde c x ~ , c ~ x x x D D D c c c D D D x ~ \tilde x x ~ c ~ \tilde c c ~
e = x ~ − γ ^ c ~ , γ ^ = ∑ i x ~ i c ~ i ∑ i c ~ i 2 .
e=\tilde x-\hat\gamma\,\tilde c,\qquad \hat\gamma=\frac{\sum_i\tilde x_i\tilde c_i}{\sum_i\tilde c_i^2}.
e = x ~ − γ ^ c ~ , γ ^ = ∑ i c ~ i 2 ∑ i x ~ i c ~ i . 上式除法要求 ∑ i c ~ i 2 > 0 \sum_i\tilde c_i^2>0 ∑ i c ~ i 2 > 0 x ~ \tilde x x ~
所以 e e e ∑ i e i c i = 0 \sum_ie_ic_i=0 ∑ i e i c i = 0
冗余设计下不变。 若加上一列常数(所有行业虚拟变量之和),设计矩阵秩亏。残差是 x x x lstsq 的最小范数选择。(测试里有常数控制列的残差与无此列的残差相差小于 10 − 10 10^{-10} 1 0 − 10
一个行业只有一只股票。 它的虚拟变量独占一个自由度,残差恒为零。同日有效名字不足(自由度少于 2)的日期,该行为 NaN,不是零。
与对权重做线性约束投影的关系。 设权重取 w = x w=x w = x A w = 0 A w=0 A w = 0 A A A project_to_constraints 求 w − A ⊤ ( A A ⊤ ) − 1 A w w-A^\top(AA^\top)^{-1}Aw w − A ⊤ ( A A ⊤ ) − 1 A w x x x A ⊤ A^\top A ⊤ + 1 / m +1/m + 1/ m − 1 / m -1/m − 1/ m project_to_constraints 要求行线性无关)。
6.4 合成的 IC 与正交化顺序
以下要求 ∣ r 12 ∣ < 1 |r_{12}|<1 ∣ r 12 ∣ < 1 ρ 1 , ρ 2 \rho_1,\rho_2 ρ 1 , ρ 2 r 12 r_{12} r 12 z 1 + z 2 z_1+z_2 z 1 + z 2 C o v = ρ 1 + ρ 2 \mathrm{Cov}=\rho_1+\rho_2 Cov = ρ 1 + ρ 2 V a r = 2 ( 1 + r 12 ) \mathrm{Var}=2(1+r_{12}) Var = 2 ( 1 + r 12 ) = ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) =(\rho_1+\rho_2)/\sqrt{2(1+r_{12})} = ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) r 12 = 0 r_{12}=0 r 12 = 0 ( ρ 1 + ρ 2 ) / 2 (\rho_1+\rho_2)/\sqrt2 ( ρ 1 + ρ 2 ) / 2
依次正交化。 先保留 z 1 z_1 z 1 z 2 z_2 z 2 z 1 z_1 z 1 e 2 = z 2 − r 12 z 1 e_2=z_2-r_{12}z_1 e 2 = z 2 − r 12 z 1 1 − r 12 2 1-r_{12}^2 1 − r 12 2 z 1 z_1 z 1 e 2 e_2 e 2 e ~ 2 = e 2 / 1 − r 12 2 \tilde e_2=e_2/\sqrt{1-r_{12}^2} e ~ 2 = e 2 / 1 − r 12 2 C o v ( e ~ 2 , y ) = ( ρ 2 − r 12 ρ 1 ) / 1 − r 12 2 \mathrm{Cov}(\tilde e_2,y)=(\rho_2-r_{12}\rho_1)/\sqrt{1-r_{12}^2} Cov ( e ~ 2 , y ) = ( ρ 2 − r 12 ρ 1 ) / 1 − r 12 2
I C 1 → 2 = 1 2 [ ρ 1 + ρ 2 − r 12 ρ 1 1 − r 12 2 ] .
\mathrm{IC}_{1\to2}=\frac1{\sqrt2}\Bigl[\rho_1+\frac{\rho_2-r_{12}\rho_1}{\sqrt{1-r_{12}^2}}\Bigr].
IC 1 → 2 = 2 1 [ ρ 1 + 1 − r 12 2 ρ 2 − r 12 ρ 1 ] . 交换顺序得 I C 2 → 1 = 1 2 [ ρ 2 + ( ρ 1 − r 12 ρ 2 ) / 1 − r 12 2 ] \mathrm{IC}_{2\to1}=\frac1{\sqrt2}\bigl[\rho_2+(\rho_1-r_{12}\rho_2)/\sqrt{1-r_{12}^2}\bigr] IC 2 → 1 = 2 1 [ ρ 2 + ( ρ 1 − r 12 ρ 2 ) / 1 − r 12 2 ] ρ 1 = 0.04 , ρ 2 = 0.02 , r 12 = 0.5 \rho_1=0.04,\rho_2=0.02,r_{12}=0.5 ρ 1 = 0.04 , ρ 2 = 0.02 , r 12 = 0.5 I C 1 → 2 = 0.0283 \mathrm{IC}_{1\to2}=0.0283 IC 1 → 2 = 0.0283 I C 2 → 1 = 0.0386 \mathrm{IC}_{2\to1}=0.0386 IC 2 → 1 = 0.0386 0.0346 0.0346 0.0346 0.0400 0.0400 0.0400 ρ 2 = r 12 ρ 1 \rho_2=r_{12}\rho_1 ρ 2 = r 12 ρ 1
K 个信号。 要求相关矩阵正定,故Cholesky各残差方差为正。 用相关矩阵的 Cholesky 分解 P R P ⊤ = L L ⊤ P R P^\top=LL^\top P R P ⊤ = L L ⊤ P P P L − 1 P z L^{-1}Pz L − 1 P z L − 1 P ρ L^{-1}P\rho L − 1 P ρ 1 ⊤ L − 1 P ρ / K \mathbf 1^\top L^{-1}P\rho/\sqrt K 1 ⊤ L − 1 P ρ / K sequential_orthogonal_ic)。
IC 最大化的权重。 最大化 w ⊤ ρ / w ⊤ R w w^\top\rho/\sqrt{w^\top Rw} w ⊤ ρ / w ⊤ R w ρ = λ R w \rho=\lambda Rw ρ = λ R w w ∗ ∝ R − 1 ρ w^*\propto R^{-1}\rho w ∗ ∝ R − 1 ρ = ρ ⊤ R − 1 ρ =\sqrt{\rho^\top R^{-1}\rho} = ρ ⊤ R − 1 ρ R − 1 ρ ∝ ( 0.04 − 0.5 × 0.02 , 0.02 − 0.5 × 0.04 ) = ( 0.03 , 0 ) R^{-1}\rho\propto(0.04-0.5\times0.02,\ 0.02-0.5\times0.04)=(0.03,0) R − 1 ρ ∝ ( 0.04 − 0.5 × 0.02 , 0.02 − 0.5 × 0.04 ) = ( 0.03 , 0 ) = 0.04 = ρ 1 =0.04=\rho_1 = 0.04 = ρ 1 R R R ρ ≠ 0 \rho\ne0 ρ = 0 ρ = 0 \rho=0 ρ = 0
含义。 顺序没有“正确”答案;如果选哪个顺序是看哪个评价期 IC 最高,它就是一个多重比较(第22章)。可行的做法是事前写明“经济上最基础的因子在前”,把顺序变体全部记账。
6.5 权重的选择与调参的乐观性
等权不需要估计。与发现期 IC 成比例的权重 w ^ k ∝ max ( I C ^ k , 0 ) \hat w_k\propto\max(\widehat{\mathrm{IC}}_k,0) w ^ k ∝ max ( IC k , 0 ) T T T n n n 1 / n T 1/\sqrt{nT} 1/ n T 1 / n 1/\sqrt n 1/ n n = 300 , T = 60 n=300,T=60 n = 300 , T = 60 0.0075 0.0075 0.0075 0.014 , 0.049 , 0.033 0.014,0.049,0.033 0.014 , 0.049 , 0.033
6.6 缺失因子:谁的尺度变了
设 K K K k k k r ˉ \bar r r ˉ
按可得因子重新加权 :c = 1 k ∑ j ∈ 可得 z j c=\frac1k\sum_{j\in\text{可得}}z_j c = k 1 ∑ j ∈ 可得 z j 1 k 2 [ k + k ( k − 1 ) r ˉ ] = 1 + ( k − 1 ) r ˉ k \frac1{k^2}\bigl[k+k(k-1)\bar r\bigr]=\frac{1+(k-1)\bar r}{k} k 2 1 [ k + k ( k − 1 ) r ˉ ] = k 1 + ( k − 1 ) r ˉ r ˉ = 0 \bar r=0 r ˉ = 0 1 / k 1/k 1/ k r ˉ < 0 \bar r<0 r ˉ < 0 k = 2 , r ˉ = − 0.5 k=2,\bar r=-0.5 k = 2 , r ˉ = − 0.5 补零 :c = 1 K ∑ j ∈ 可得 z j c=\frac1K\sum_{j\in\text{可得}}z_j c = K 1 ∑ j ∈ 可得 z j k K 2 [ 1 + ( k − 1 ) r ˉ ] \frac{k}{K^2}\bigl[1+(k-1)\bar r\bigr] K 2 k [ 1 + ( k − 1 ) r ˉ ]
构造面板的三个因子 r ˉ = ( − 0.3 − 0.3 + 0.2 ) / 3 = − 0.133 \bar r=(-0.3-0.3+0.2)/3=-0.133 r ˉ = ( − 0.3 − 0.3 + 0.2 ) /3 = − 0.133 ( 1 + 2 × ( − 0.133 ) ) / 3 = 0.244 (1+2\times(-0.133))/3=0.244 ( 1 + 2 × ( − 0.133 )) /3 = 0.244 1 / 9 1/9 1/9
缺失机制。 完全随机缺失(missing completely at random, MCAR)时可沿相应子集矩作上面的尺度比较;缺失与信号相关(如亏损公司没有盈利比率)时条件矩也可能改变,偏差不保证温和或必然更大,本章只模拟随机缺失。建议:设最少因子数(如 2),报告覆盖率,对两种处理做敏感度,把变体进账本。
6.7 时间序列标准化的前视
对每只股票的信号时间序列用全样本均值与标准差做标准化,第 t t t t t t ( 1 , 2 , 3 , 10 ) (1,2,3,10) ( 1 , 2 , 3 , 10 ) t = 3 t=3 t = 3 z = ( 3 − 2 ) / 1 = + 1.0 z=(3-2)/1=+1.0 z = ( 3 − 2 ) /1 = + 1.0 z = ( 3 − 4 ) / 4.08 = − 0.245 z=(3-4)/4.08=-0.245 z = ( 3 − 4 ) /4.08 = − 0.245 t t t ≤ t \le t ≤ t expanding_zscore 有这个测试)。同日截面变换的算法只取当日行,但时点合格还要求该行输入版本与政策在当时已知。
6.8 因子相关、多元化与不稳定的相关
等风险平均的 k k k S = μ / σ S=\mu/\sigma S = μ / σ ρ ˉ \bar\rho ρ ˉ μ \mu μ σ 2 [ 1 + ( k − 1 ) ρ ˉ ] / k \sigma^2[1+(k-1)\bar\rho]/k σ 2 [ 1 + ( k − 1 ) ρ ˉ ] / k
S p = μ σ [ 1 + ( k − 1 ) ρ ˉ ] / k = S k 1 + ( k − 1 ) ρ ˉ .
S_p=\frac{\mu}{\sigma\sqrt{[1+(k-1)\bar\rho]/k}}=\frac{S\sqrt k}{\sqrt{1+(k-1)\bar\rho}} .
S p = σ [ 1 + ( k − 1 ) ρ ˉ ] / k μ = 1 + ( k − 1 ) ρ ˉ S k . ρ ˉ = 1 \bar\rho=1 ρ ˉ = 1 S p = S S_p=S S p = S ρ ˉ = 0 \bar\rho=0 ρ ˉ = 0 S k S\sqrt k S k ρ ˉ \bar\rho ρ ˉ − 1 / ( k − 1 ) -1/(k-1) − 1/ ( k − 1 ) diversified_sharpe 要求严格大于下界)。数值:S = 0.3 , k = 3 S=0.3,k=3 S = 0.3 , k = 3 ρ ˉ = 0 \bar\rho=0 ρ ˉ = 0 ρ ˉ = 0.2 \bar\rho=0.2 ρ ˉ = 0.2 ρ ˉ = 0.8 \bar\rho=0.8 ρ ˉ = 0.8
若等风险但夏普不同,把分子中的 S S S
相关系数是估计量。在独立同分布、近似二元正态及大样本近似下,T T T ρ \rho ρ ( 1 − ρ 2 ) / T (1-\rho^2)/\sqrt T ( 1 − ρ 2 ) / T T = 60 T=60 T = 60 ρ = 0 \rho=0 ρ = 0
6.9 拥挤:定义与能测什么
拥挤要求知道有多少资金在做相似的头寸,这需要持仓、卖空利率、基金资金流等数据。本章的数据没有这些,所以只能做两件事:(i)度量信号层面的头寸重叠:同日两个因子前五分位名字的交集占比,独立时应为 0.20;(ii)度量收益层面的同步性:因子收益的相关系数与滚动相关。前者在构造面板里算(价值与动量 0.10,价值与质量 0.10,动量与质量 0.28);后者在已发布的因子收益上算(11 节)。这两件事都不能证明“拥挤”,只提供它的一个可观测的侧面。
6.10 支持集上的投影:中性成立在谁身上、哪一刻
支持集(support) S t = { i : l i s t e d i , t = T r u e } \mathcal S_t=\{i:\mathrm{listed}_{i,t}=\mathrm{True}\} S t = { i : listed i , t = True } alpha有效集 是合成分数非缺失的子集,二者不等。先在alpha有效集取固定五分位多空 w 0 w^0 w 0 S t \mathcal S_t S t
令 u = w S t 0 u=w^0_{\mathcal S_t} u = w S t 0 A t A_t A t A t A t ⊤ A_tA_t^\top A t A t ⊤
v = arg min A t v = 0 ∥ v − u ∥ 2 = u − A t ⊤ ( A t A t ⊤ ) − 1 A t u .
v=\arg\min_{A_t v=0}\|v-u\|^2
=u-A_t^\top(A_tA_t^\top)^{-1}A_tu.
v = arg A t v = 0 min ∥ v − u ∥ 2 = u − A t ⊤ ( A t A t ⊤ ) − 1 A t u . 把全列权重先投影再对未上市名字置零,通常不等于这个式子:掩码删除了原先抵消行业净额的坐标。单行业只有一个上市名字时,它的约束就是该名字权重为零;这不是全矩阵秩亏,而是这个行业没有非零对冲方向。空支持集、无原始多空组合或数值零投影应明确持现金;分类缺失/轴错位应明确失败,不能把坏输入偷偷补成零。
gross(总绝对风险头寸)与齐次约束。 若 g v = ∑ i ∈ S t ∣ v i ∣ g_v=\sum_{i\in\mathcal S_t}|v_i| g v = ∑ i ∈ S t ∣ v i ∣ k = 2 / g v > 0 k=2/g_v>0 k = 2/ g v > 0 w S t = k v w_{\mathcal S_t}=kv w S t = k v A t ( k v ) = k A t v = 0 A_t(kv)=kA_tv=0 A t ( k v ) = k A t v = 0 g v g_v g v 再缩放的最终结果一般不是原最近点 ;恢复gross改变的是头寸预算,不是重选收益参数。非零目标 A t v = b A_tv=b A t v = b A t ( k v ) = k b A_t(kv)=kb A t ( k v ) = k b k = 1 k=1 k = 1 b = 0 b=0 b = 0
两层门槛。 P4的 min_names_per_date=60 数的是 ∣ S t ∣ |\mathcal S_t| ∣ S t ∣
时钟与残差。 t t t t + 1 t+1 t + 1 t t t
7. 金融解释
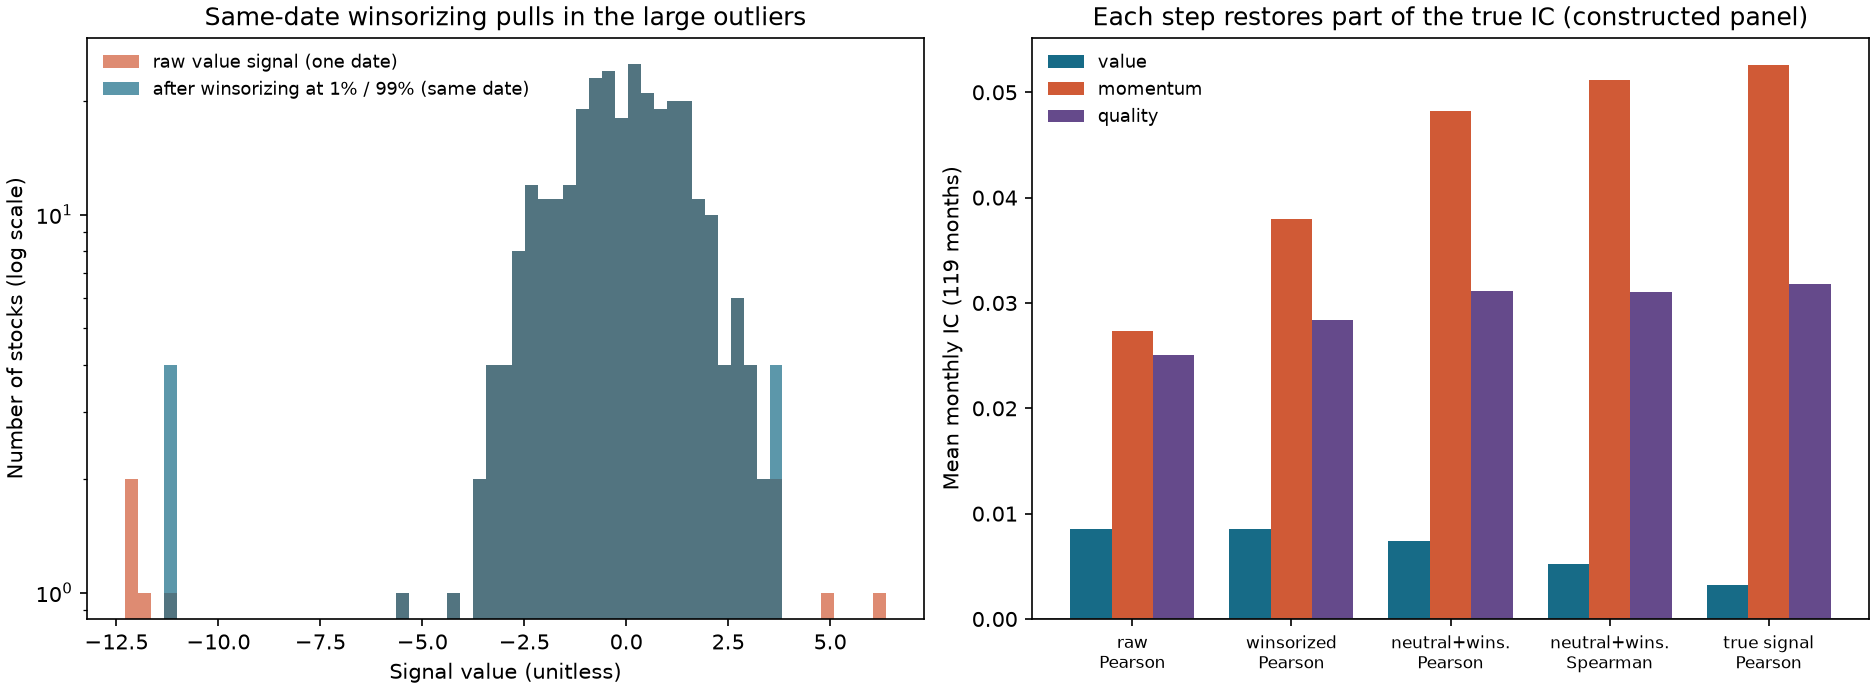
预处理是去掉与收益无关的成分,不是美化信号。 每一步都要问:被去掉的是不是干扰。行业偏移、规模载荷、离群值在构造面板里都是干扰,所以每一步恢复一部分 IC(单世界动量的 Pearson IC:原始 0.027、缩尾后 0.038、中性化后 0.048,真值 0.053)。若某个“干扰”其实带有收益(真实的行业动量、规模效应),预处理就把它扔掉了。
合成的收益来自分散,不是魔法。 两个相关的因子相加,增益受相关系数限制;合成 IC 的公式说明了这一点。一个因子的全部预测力来自它与另一个因子的相关时,它没有增量。
顺序与权重是研究者的自由度。 正交化顺序、权重选择、缺失处理、缩尾分位数,都可以在评价期上看到“更好”或“更差”。这些选择必须事前写下,变体全部记账,调参要在独立的留出期上评价。
中性化与约束的关系。 对线性权重,中性化与投影相同;对分位数权重不同,所以“我做了行业中性”需要写明是哪一种:信号中性化后排序,还是排序后对权重投影。两者的暴露、波动与换手都不同(10 节)。
相关不稳定。 已发布的价值与质量因子,相关系数在不同的 20–30 年里符号相反。依赖估计的相关矩阵来配置权重,等于依赖一个会变号的估计量。多元化的算术(S p S_p S p
8. 数值例题:手算每一步
所有数字由 hand_examples() 产生,并由 历史独立复核脚本 用不同实现复核。股票与信号为教学构造。
8.1 缩尾、z 分数与正态分数
同一天 11 只股票的信号 1 , 2 , … , 10 , 100 1,2,\dots,10,100 1 , 2 , … , 10 , 100
不缩尾的 z 分数 :均值 155 / 11 = 14.09 155/11=14.09 155/11 = 14.09 28.64 28.64 28.64 z = ( 100 − 14.09 ) / 28.64 = 3.00 z=(100-14.09)/28.64=3.00 z = ( 100 − 14.09 ) /28.64 = 3.00 − 0.457 -0.457 − 0.457 − 0.143 -0.143 − 0.143 缩尾(10% 与 90% 分位数,线性插值) :( n − 1 ) q = 10 × 0.1 = 1 (n-1)q=10\times0.1=1 ( n − 1 ) q = 10 × 0.1 = 1 9 9 9 q − = 2 q^-=2 q − = 2 q + = 10 q^+=10 q + = 10 2 , 2 , 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 10 2,2,3,4,5,6,7,8,9,10,10 2 , 2 , 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 10 66 / 11 = 6 66/11=6 66/11 = 6 16 + 16 + 9 + 4 + 1 + 0 + 1 + 4 + 9 + 16 + 16 = 92 16+16+9+4+1+0+1+4+9+16+16=92 16 + 16 + 9 + 4 + 1 + 0 + 1 + 4 + 9 + 16 + 16 = 92 92 / 10 = 9.2 92/10=9.2 92/10 = 9.2 3.033 3.033 3.033 z z z + 1.319 +1.319 + 1.319 z = − 0.330 z=-0.330 z = − 0.330 − 0.317 -0.317 − 0.317 − 1.32 -1.32 − 1.32 + 1.32 +1.32 + 1.32 正态分数 :Φ − 1 ( ( r − 1 / 2 ) / 11 ) \Phi^{-1}((r-1/2)/11) Φ − 1 (( r − 1/2 ) /11 ) Φ − 1 ( 10.5 / 11 ) = 1.691 \Phi^{-1}(10.5/11)=1.691 Φ − 1 ( 10.5/11 ) = 1.691 Φ − 1 ( 9.5 / 11 ) = 1.097 \Phi^{-1}(9.5/11)=1.097 Φ − 1 ( 9.5/11 ) = 1.097
8.2 行业中性化:把符号翻回来
6 只股票,行业 A 为 { a , b , c } \{a,b,c\} { a , b , c } { d , e , f } \{d,e,f\} { d , e , f } x = ( 1 , − 1 , 0 , 11 , 10 , 9 ) x=(1,-1,0,\ 11,10,9) x = ( 1 , − 1 , 0 , 11 , 10 , 9 ) y = ( 5 % , 3 % , 4 % , − 3 % , − 4 % , − 5 % ) y=(5\%,3\%,4\%,\ -3\%,-4\%,-5\%) y = ( 5% , 3% , 4% , − 3% , − 4% , − 5% )
原始 Pearson IC :x ˉ = 30 / 6 = 5 \bar x=30/6=5 x ˉ = 30/6 = 5 x − x ˉ = ( − 4 , − 6 , − 5 , 6 , 5 , 4 ) x-\bar x=(-4,-6,-5,6,5,4) x − x ˉ = ( − 4 , − 6 , − 5 , 6 , 5 , 4 ) ∑ ( x − x ˉ ) y = − 1.16 \sum(x-\bar x)y=-1.16 ∑ ( x − x ˉ ) y = − 1.16 ∑ ( x − x ˉ ) 2 = 154 \sum(x-\bar x)^2=154 ∑ ( x − x ˉ ) 2 = 154 ∑ y 2 = 0.01 \sum y^2=0.01 ∑ y 2 = 0.01 = − 1.16 / 154 × 0.01 = − 0.935 =-1.16/\sqrt{154\times0.01}=-0.935 = − 1.16/ 154 × 0.01 = − 0.935 中性化 :行业均值 0 0 0 10 10 10 e = ( 1 , − 1 , 0 , 1 , 0 , − 1 ) e=(1,-1,0,\ 1,0,-1) e = ( 1 , − 1 , 0 , 1 , 0 , − 1 ) ∑ e y = 0.04 \sum ey=0.04 ∑ ey = 0.04 ∑ e 2 = 4 \sum e^2=4 ∑ e 2 = 4 = 0.04 / 4 × 0.01 = + 0.200 =0.04/\sqrt{4\times0.01}=+0.200 = 0.04/ 4 × 0.01 = + 0.200
行业偏移是与收益(行业内排序)无关、却与行业收益相反的干扰;中性化之前 IC 是 − 0.94 -0.94 − 0.94 + 0.20 +0.20 + 0.20
8.3 线性约束投影与中性化是同一个向量
仍用 8.2 的 x x x w = x w=x w = x A A A A A ⊤ = d i a g ( 3 , 3 ) AA^\top=\mathrm{diag}(3,3) A A ⊤ = diag ( 3 , 3 ) A x = ( 0 , 30 ) Ax=(0,30) A x = ( 0 , 30 ) w − A ⊤ ( A A ⊤ ) − 1 A x = x − ( 0 , 0 , 0 , 10 , 10 , 10 ) = ( 1 , − 1 , 0 , 1 , 0 , − 1 ) w-A^\top(AA^\top)^{-1}Ax=x-(0,0,0,10,10,10)=(1,-1,0,1,0,-1) w − A ⊤ ( A A ⊤ ) − 1 A x = x − ( 0 , 0 , 0 , 10 , 10 , 10 ) = ( 1 , − 1 , 0 , 1 , 0 , − 1 )
8.4 两个相关信号:等权、两种正交化顺序与最优
完整例题:相关信号的四种合成
ρ 1 = 0.04 , ρ 2 = 0.02 , r 12 = 0.5 \rho_1=0.04,\ \rho_2=0.02,\ r_{12}=0.5 ρ 1 = 0.04 , ρ 2 = 0.02 , r 12 = 0.5
合成方式
IC
只用 z 1 z_1 z 1
0.0400 0.0400 0.0400
等权 z 1 + z 2 z_1+z_2 z 1 + z 2
0.06 / 2 × 1.5 = 0.0346 0.06/\sqrt{2\times1.5}=0.0346 0.06/ 2 × 1.5 = 0.0346
先 z 1 z_1 z 1 z 2 z_2 z 2 z 1 z_1 z 1
1 2 [ 0.04 + ( 0.02 − 0.02 ) / 0.866 ] = 0.0283 \frac1{\sqrt2}[0.04+(0.02-0.02)/0.866]=0.0283 2 1 [ 0.04 + ( 0.02 − 0.02 ) /0.866 ] = 0.0283
先 z 2 z_2 z 2 z 1 z_1 z 1 z 2 z_2 z 2
1 2 [ 0.02 + ( 0.04 − 0.01 ) / 0.866 ] = 0.0386 \frac1{\sqrt2}[0.02+(0.04-0.01)/0.866]=0.0386 2 1 [ 0.02 + ( 0.04 − 0.01 ) /0.866 ] = 0.0386
最优权重 ∝ R − 1 ρ = ( 0.04 , 0 ) → ( 1 , 0 ) \propto R^{-1}\rho=(0.04,0)\to(1,0) ∝ R − 1 ρ = ( 0.04 , 0 ) → ( 1 , 0 )
ρ ⊤ R − 1 ρ = 0.0400 \sqrt{\rho^\top R^{-1}\rho}=0.0400 ρ ⊤ R − 1 ρ = 0.0400
顺序把 IC 从 0.0283 改到 0.0386,相差 36%;等权在两者之间;最优等于只用第一个因子,因为 ρ 2 = r 12 ρ 1 \rho_2=r_{12}\rho_1 ρ 2 = r 12 ρ 1
8.5 缺失因子
两个因子,权重 ( 0.5 , 0.5 ) (0.5,0.5) ( 0.5 , 0.5 ) s 1 s_1 s 1 z = ( 2 , 2 ) z=(2,2) z = ( 2 , 2 ) 2.0 2.0 2.0 s 2 s_2 s 2 z = 1 z=1 z = 1
按可得因子重新加权:0.5 × 1 / 0.5 = 1.0 0.5\times1/0.5=1.0 0.5 × 1/0.5 = 1.0 z z z
补零:0.5 × 1 / 1.0 = 0.5 0.5\times1/1.0=0.5 0.5 × 1/1.0 = 0.5
6.6 节:三个相关均值为 − 0.133 -0.133 − 0.133
8.6 标准化的前视
某只股票的信号序列 ( 1 , 2 , 3 , 10 ) (1,2,3,10) ( 1 , 2 , 3 , 10 ) { 1 , 2 , 3 } \{1,2,3\} { 1 , 2 , 3 } z = + 1.0 z=+1.0 z = + 1.0 4.082 4.082 4.082 z = ( 3 − 4 ) / 4.082 = − 0.245 z=(3-4)/4.082=-0.245 z = ( 3 − 4 ) /4.082 = − 0.245
8.7 多元化
三个因子,各自夏普比率 0.3:平均相关 0:0.3 3 = 0.520 0.3\sqrt3=0.520 0.3 3 = 0.520 0.520 / 1.4 = 0.439 0.520/\sqrt{1.4}=0.439 0.520/ 1.4 = 0.439 0.520 / 2.6 = 0.322 0.520/\sqrt{2.6}=0.322 0.520/ 2.6 = 0.322 ( 1 0.2 0.4 0.2 1 0 0.4 0 1 ) \begin{pmatrix}1&0.2&0.4\\0.2&1&0\\0.4&0&1\end{pmatrix} 1 0.2 0.4 0.2 1 0 0.4 0 1 ( 0.2 + 0.4 + 0 ) / 3 = 0.2 (0.2+0.4+0)/3=0.2 ( 0.2 + 0.4 + 0 ) /3 = 0.2
8.8 四名宇宙中的三坐标支持集:先投影再掩码反例
四名a,b,c,d,行业A为a,b,B为c,d。已全列中性的权重 w = ( 0.4 , − 0.4 , 0.3 , − 0.3 ) w=(0.4,-0.4,0.3,-0.3) w = ( 0.4 , − 0.4 , 0.3 , − 0.3 ) ( 0 , − 0.4 , 0.3 , − 0.3 ) (0,-0.4,0.3,-0.3) ( 0 , − 0.4 , 0.3 , − 0.3 ) − 0.4 -0.4 − 0.4 − 0.4 -0.4 − 0.4
正确支持集为 ( b , c , d ) (b,c,d) ( b , c , d ) u = ( − 0.4 , 0.3 , − 0.3 ) u=(-0.4,0.3,-0.3) u = ( − 0.4 , 0.3 , − 0.3 )
A t = ( 1 0 0 0 1 1 ) , A t A t ⊤ = diag ( 1 , 2 ) , A t u = ( − 0.4 , 0 ) .
A_t=\begin{pmatrix}1&0&0\\0&1&1\end{pmatrix},\quad
A_tA_t^\top=\operatorname{diag}(1,2),\quad A_tu=(-0.4,0).
A t = ( 1 0 0 1 0 1 ) , A t A t ⊤ = diag ( 1 , 2 ) , A t u = ( − 0.4 , 0 ) . 投影逐项减行业均值,v = ( 0 , 0.3 , − 0.3 ) v=(0,0.3,-0.3) v = ( 0 , 0.3 , − 0.3 ) 2 / 0.6 = 10 / 3 2/0.6=10/3 2/0.6 = 10/3 ( 0 , 0 , 1 , − 1 ) (0,0,1,-1) ( 0 , 0 , 1 , − 1 )
再看缺失alpha的对冲坐标:四名都上市,只有a、c有分数,原多空 ( 1 , 0 , − 1 , 0 ) (1,0,-1,0) ( 1 , 0 , − 1 , 0 ) 0.5 , − 0.5 0.5,-0.5 0.5 , − 0.5 v = ( 0.5 , − 0.5 , − 0.5 , 0.5 ) v=(0.5,-0.5,-0.5,0.5) v = ( 0.5 , − 0.5 , − 0.5 , 0.5 )
非零目标的对照:行业A只一个坐标,要求 v a = 0.2 v_a=0.2 v a = 0.2
9. Python实现
函数在新模块 factor_preprocessing.pyfactor_research.pyproject_to_constraints
函数
输入
输出与边界
winsorize_cross_section信号面板、下上分位数、最少名字数
每行缩到该行分位数区间;有效名字少于最少数则整行 NaN;分位数须满足 0 ≤ 0\le 0 ≤ < < < ≤ 1 \le1 ≤ 1
zscore_cross_section面板、自由度(0 或 1)、最少名字数
每行 ( x − x ˉ ) / s (x-\bar x)/s ( x − x ˉ ) / s
mad_zscore_cross_section面板
( x − 中位数 ) / ( 1.4826 M A D ) (x-\text{中位数})/(1.4826\,\mathrm{MAD}) ( x − 中位数 ) / ( 1.4826 MAD )
normal_scores面板
Φ − 1 ( ( r − 1 / 2 ) / n ) \Phi^{-1}((r-1/2)/n) Φ − 1 (( r − 1/2 ) / n )
neutralize信号、行业(静态表或日期表)、控制变量字典
同日 OLS 残差;缺任一项的名字为 NaN;同一signal/全部controls/group有效配对集合上计算;n − rank ( X ) < 2 n-\operatorname{rank}(X)<2 n − rank ( X ) < 2
orthogonalize信号、对其回归的面板列表
对截距与这些面板的同日残差
combine_signals信号字典、权重字典、最少因子数、missing='reweight' 或 'zero'
合成面板与每个名字的非零权重可得因子数(min_factors只计这些项);权重须为有限实数且不全为零
expanding_zscore面板、最少期数
第 t t t ≤ t \le t ≤ t
composite_ic与标签的相关向量、相关矩阵、权重
w ⊤ ρ / w ⊤ R w w^\top\rho/\sqrt{w^\top Rw} w ⊤ ρ / w ⊤ R w R R R ρ ⊤ R − 1 ρ ≤ 1 \rho^\top R^{-1}\rho\le1 ρ ⊤ R − 1 ρ ≤ 1
optimal_composite_weights同上
R − 1 ρ R^{-1}\rho R − 1 ρ ρ \rho ρ
sequential_orthogonal_ic同上、顺序
依次正交化后等权合成的 IC
diversified_sharpe、average_pairwise_correlation夏普、个数、平均相关;相关矩阵
S k / 1 + ( k − 1 ) ρ ˉ S\sqrt k/\sqrt{1+(k-1)\bar\rho} S k / 1 + ( k − 1 ) ρ ˉ 1 + ( k − 1 ) ρ ˉ 1+(k-1)\bar\rho 1 + ( k − 1 ) ρ ˉ
默认离线阅读入口是已接受读者包的 notebooks/ch28_multifactor.ipynb:RUN_FRENCH=False,构造300名×120月(seed 20261121),调参sweep默认60世界。只创建新的RUN_DIR;不输出历史图/CSV/JSON。下文French与本章四图属于既有历史证据,不由默认路径重跑。 runner另存execution副本和状态。代码块保留完整供学习;下列是原工程源中的历史CLI/测试入口,非读者默认步骤,独立包未捆绑这些工程入口时不要运行:
.venv/bin/python code/ch28_multifactor.py
.venv/bin/python -m pytest tests/test_ch28_preprocessing.py tests/test_ch28_workflow.py -q
频率:月;signal_time 是月末;所有同日变换的第 t t t t t t expanding_zscore 的第 t t t ≤ t \le t ≤ t
代码段一:缩尾、z 分数、正态分数(8.1 节)。
import numpy as np
import pandas as pd
from quant_course.factor_preprocessing import normal_scores, winsorize_cross_section, zscore_cross_section
x = pd.DataFrame([[1.0 , 2 , 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 100 ]], index=pd.period_range("2026-06" , periods=1 , freq="M" ))
w = winsorize_cross_section(x, lower=0.1 , upper=0.9 , min_names=10 )
assert w.iloc[0 ].tolist() == [2 , 2 , 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 10 ]
assert abs (w.iloc[0 ].mean() - 6.0 ) < 1e-12 and abs (w.iloc[0 ].std(ddof=1 ) - np.sqrt(9.2 )) < 1e-12
z_raw, z_win = zscore_cross_section(x), zscore_cross_section(w)
assert abs (z_raw.iloc[0 , 10 ] - 3.0 ) < 0.001 and z_raw.iloc[0 , :10 ].between(-0.46 , -0.14 ).all ()
assert abs (z_win.iloc[0 , 9 ] - 4 / np.sqrt(9.2 )) < 1e-12 and abs (z_win.iloc[0 , 9 ] - z_win.iloc[0 , 10 ]) < 1e-12
ns = normal_scores(x)
assert abs (ns.iloc[0 , 10 ] - 1.6906 ) < 1e-4 and abs (ns.iloc[0 , 9 ] - 1.0968 ) < 1e-4
代码段二:行业中性化与线性约束投影(8.2、8.3 节)。
import numpy as np
import pandas as pd
from quant_course.factor_preprocessing import neutralize
from quant_course.portfolio_construction import project_to_constraints
cols = list ("abcdef" )
sig = pd.DataFrame([[1.0 , -1.0 , 0.0 , 11.0 , 10.0 , 9.0 ]], index=pd.period_range("2026-06" , periods=1 , freq="M" ), columns=cols)
ret = np.array([0.05 , 0.03 , 0.04 , -0.03 , -0.04 , -0.05 ])
groups = pd.Series(list ("AAABBB" ), index=cols)
res = neutralize(sig, groups=groups)
assert np.allclose(res.iloc[0 ], [1 , -1 , 0 , 1 , 0 , -1 ], atol=1e-12 )
assert abs (np.corrcoef(sig.iloc[0 ], ret)[0 , 1 ] + 0.93475 ) < 1e-5 and abs (np.corrcoef(res.iloc[0 ], ret)[0 , 1 ] - 0.2 ) < 1e-12
A = np.array([[1 , 1 , 1 , 0 , 0 , 0 ], [0 , 0 , 0 , 1 , 1 , 1 ]], dtype=float )
proj = project_to_constraints(sig.iloc[0 ].to_numpy(), A)
assert np.allclose(proj, res.iloc[0 ], atol=1e-12 ) and abs (proj.sum ()) < 1e-12 and np.allclose(A @ proj, 0 )
代码段三:两个相关信号的合成与顺序(8.4 节)。
import numpy as np
from quant_course.factor_preprocessing import composite_ic, optimal_composite_weights, sequential_orthogonal_ic
R = np.array([[1.0 , 0.5 ], [0.5 , 1.0 ]])
rho = [0.04 , 0.02 ]
assert abs (composite_ic(rho, R) - 0.06 / np.sqrt(3 )) < 1e-12
a, b = sequential_orthogonal_ic(rho, R, [0 , 1 ]), sequential_orthogonal_ic(rho, R, [1 , 0 ])
assert abs (a - 0.04 / np.sqrt(2 )) < 1e-12 and abs (b - (0.02 + 0.03 / np.sqrt(0.75 )) / np.sqrt(2 )) < 1e-12 and b > a
w, best = optimal_composite_weights(rho, R)
assert np.allclose(w, [1.0 , 0.0 ]) and abs (best - 0.04 ) < 1e-12 and abs (composite_ic(rho, R, w) - 0.04 ) < 1e-12
assert best > b > composite_ic(rho, R) > a
代码段四:缺失因子的尺度(8.5、6.6 节)。
import numpy as np
import pandas as pd
from quant_course.factor_preprocessing import combine_signals
idx = pd.period_range("2026-06" , periods=1 , freq="M" )
z = {"f1" : pd.DataFrame([[2.0 , np.nan]], index=idx, columns=["s1" , "s2" ]), "f2" : pd.DataFrame([[2.0 , 1.0 ]], index=idx, columns=["s1" , "s2" ])}
rw, count = combine_signals(z, {"f1" : 0.5 , "f2" : 0.5 }, missing="reweight" )
zero, _ = combine_signals(z, {"f1" : 0.5 , "f2" : 0.5 }, missing="zero" )
assert rw.iloc[0 ].tolist() == [2.0 , 1.0 ] and zero.iloc[0 ].tolist() == [2.0 , 0.5 ] and count.iloc[0 ].tolist() == [2 , 1 ]
rng = np.random.default_rng(0 )
R = np.array([[1.0 , -0.3 , -0.3 ], [-0.3 , 1.0 , 0.2 ], [-0.3 , 0.2 , 1.0 ]])
full = rng.multivariate_normal(np.zeros(3 ), R, size=300_000 )
var3 = full.mean(axis=1 ).var()
assert abs (var3 - (1 + 2 * (-0.1333 )) / 3 ) < 0.005
reweighted_one, zero_filled_one = full[:, 0 ], full[:, 0 ] / 3
assert abs (reweighted_one.var() / var3 - 1 / 0.2444 ) < 0.15 and abs (zero_filled_one.var() / var3 - (1 / 9 ) / 0.2444 ) < 0.02
代码段五:标准化的前视(8.6 节)。
import pandas as pd
from quant_course.factor_preprocessing import expanding_zscore
x = pd.DataFrame({"x" : [1.0 , 2.0 , 3.0 , 10.0 ]}, index=pd.period_range("2026-01" , periods=4 , freq="M" ))
past = expanding_zscore(x, min_periods=3 )
full = (x["x" ] - x["x" ].mean()) / x["x" ].std(ddof=1 )
assert abs (past["x" ].iloc[2 ] - 1.0 ) < 1e-12 and abs (full.iloc[2 ] + 0.244949 ) < 1e-6
changed = x.copy(); changed.iloc[3 , 0 ] = -100.0
assert expanding_zscore(changed, min_periods=3 )["x" ].iloc[:3 ].equals(past["x" ].iloc[:3 ])
代码段六:多元化(8.7 节)。
import numpy as np
from quant_course.factor_preprocessing import average_pairwise_correlation, diversified_sharpe
assert abs (diversified_sharpe(0.3 , 3 , 0.0 ) - 0.3 * np.sqrt(3 )) < 1e-12
assert abs (diversified_sharpe(0.3 , 3 , 0.2 ) - 0.43916 ) < 1e-5 and abs (diversified_sharpe(0.3 , 3 , 0.8 ) - 0.32225 ) < 1e-5
assert abs (average_pairwise_correlation(np.array([[1 , 0.2 , 0.4 ], [0.2 , 1 , 0.0 ], [0.4 , 0.0 , 1 ]])) - 0.2 ) < 1e-12
assert abs (diversified_sharpe(0.3 , 3 , 1.0 ) - 0.3 ) < 1e-12
10. 图形解读
构造面板。 300 只股票、120 个月(119 个有标签的月份),种子 20261121。三个真信号(价值、动量、质量),同日相关 − 0.3 , − 0.3 , 0.2 -0.3,-0.3,0.2 − 0.3 , − 0.3 , 0.2 ( 0.0030 , 0.0040 , 0.0025 ) (0.0030,0.0040,0.0025) ( 0.0030 , 0.0040 , 0.0025 ) − 0.5 , 0 , 0.3 -0.5,0,0.3 − 0.5 , 0 , 0.3
图 28-1:缩尾与逐步恢复 IC。 左图:某一天价值信号的直方图(对数纵轴),橙色是原始值(尾部有 − 12 -12 − 12 + 6 +6 + 6
60 个新世界的平均 Pearson IC 与衰减因子(原始、缩尾后、中性化加缩尾后相对真信号)。
因子
真信号 IC
原始 / 真
缩尾后 / 真
中性化加缩尾后 / 真
6.2 节预测的原始 / 真
价值
0.0159
0.553
0.629
0.878
0.540
动量
0.0496
0.592
0.692
0.881
0.561
质量
0.0327
0.576
0.676
0.859
0.553
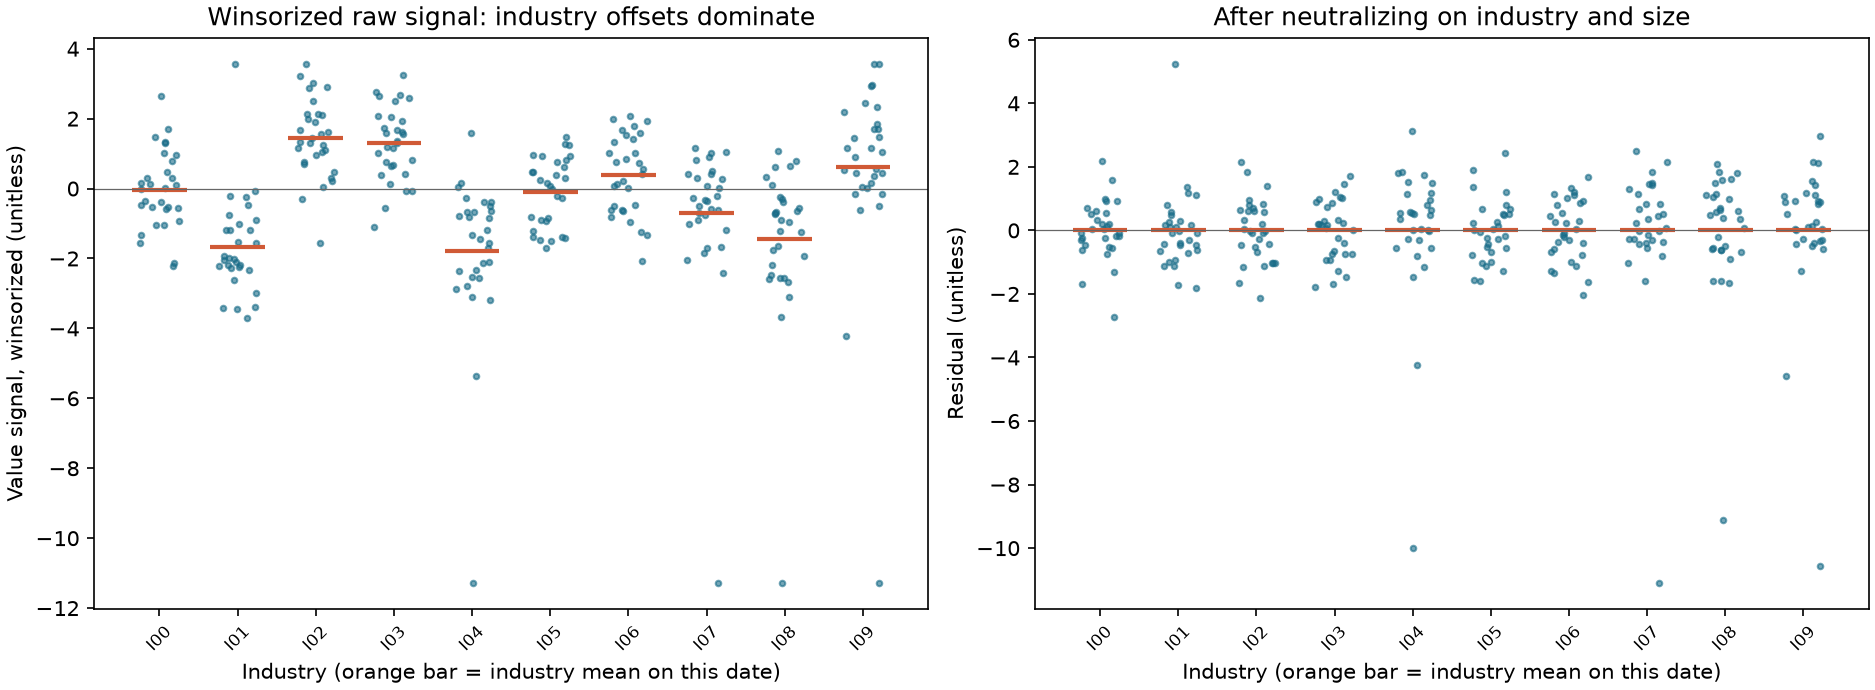
图 28-2:中性化前后的截面。 同一天价值信号(已缩尾)按行业画的散点(左)与对行业与规模中性化后的残差(右);橙色横线是该行业该日的均值。读法:左图行业均值明显分开(行业偏移占信号的大部分差异),右图每个行业的均值都落在 0(一个日期上最大的行业均值绝对值 1.9 × 10 − 15 1.9\times10^{-15} 1.9 × 1 0 − 15 − 1.0 × 10 − 17 -1.0\times10^{-17} − 1.0 × 1 0 − 17 − 9 -9 − 9 − 11 -11 − 11 − 11.3 -11.3 − 11.3
合成(Pearson IC,119 个月;括号内是解析值,用真信号与真相关矩阵)。
合成方式
实测 Pearson IC
实测 Spearman IC
解析 IC
等权
0.0562
0.0519
0.0651
真载荷权重(事后的“上帝视角”)
0.0582
0.0548
0.0665
依次正交化 价值→动量→质量
0.0500
0.0467
0.0595
依次正交化 质量→动量→价值
0.0577
0.0532
0.0661
依次正交化 动量→价值→质量
0.0553
0.0511
0.0649
依次正交化 动量→质量→价值
0.0563
0.0518
0.0639
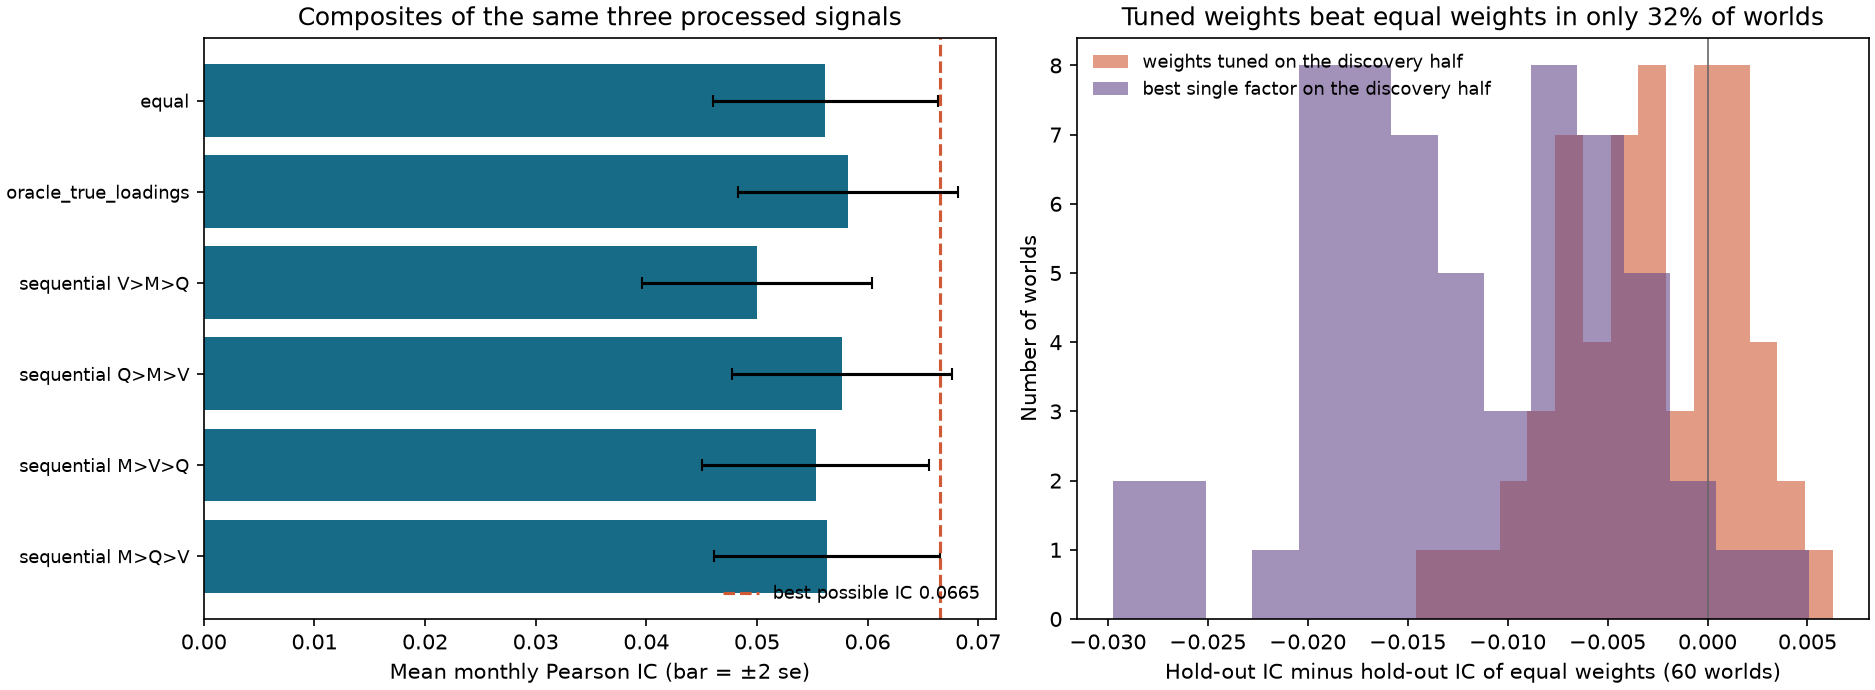
最佳单一因子的解析 IC 是 0.0493。读法:顺序从最低到最高改变 IC(解析值 0.0595 到 0.0661,实测同方向);实测 Pearson 值比解析值低 0.008–0.010。其中约 0.006 来自这个世界的抽样:用真信号本身做等权合成,实测 Pearson IC 是 0.0590(t = 11.7 t=11.7 t = 11.7
图 28-3:合成与调参。 左图:同样的三个已处理信号的各种合成的平均 Pearson IC(横条是 ± 2 \pm2 ± 2
红线是给定总体DGP真矩下的oracle最优IC,不是每一次有限样本实测IC的硬上界。图28-1的“逐步恢复”也指所设干扰机制与所报平均,不保证价值因子在单世界中每一步都单调增加。
60 个新世界的发现期与留出期平均 Spearman IC。
权重
发现期
留出期
发现期减留出期
等权
0.0578
0.0565
0.0013
与发现期 IC 成比例
0.0569
0.0537
0.0032
发现期最佳单因子
0.0459
0.0445
0.0014
缺失因子(每个已处理因子随机去掉 15%,一个世界,119 个月)。
处理
平均 Spearman IC
覆盖率
单因子名字占前五分位的比例
补零(最少 1 个因子)
0.0467
99.6%
3.5%(占有效名字 5.7%)
按可得因子重新加权(最少 2 个)
0.0468
94.0%
—
按可得因子重新加权(最少 1 个)
0.0458
99.6%
8.8%(占有效名字 5.7%)
剔除(三个都要有)
0.0511
61.3%
—
读法:IC 的差别很小(随机缺失,且剔除时用的是不同的名字集合,不能直接比较);尺度偏差在“谁出现在前五分位”里看得清:重新加权使只有一个因子的名字多出现 1.55 倍(8.8% 对 5.7%),补零使它们少出现到 0.62 倍。
约束(一个世界,119 个月,毛收益,不含成本)。
组合
月均收益(%)
t t t 月标准差(%)
行业净仓位平均最大绝对值
平均 |规模暴露|
中性化信号,五分位权重
1.188
9.29
1.395
0.053
0.084
原始合成(缩尾与 z 分数,未中性化),五分位权重
0.992
6.15
1.758
0.361
0.258
同上,权重投影到行业中性
0.870
10.19
0.931
5 × 10 − 17 5\times10^{-17} 5 × 1 0 − 17 0.230
读法:投影后的行业净仓位恰为零,波动最低(0.93%)所以 t t t + 1 / m +1/m + 1/ m − 1 / m -1/m − 1/ m
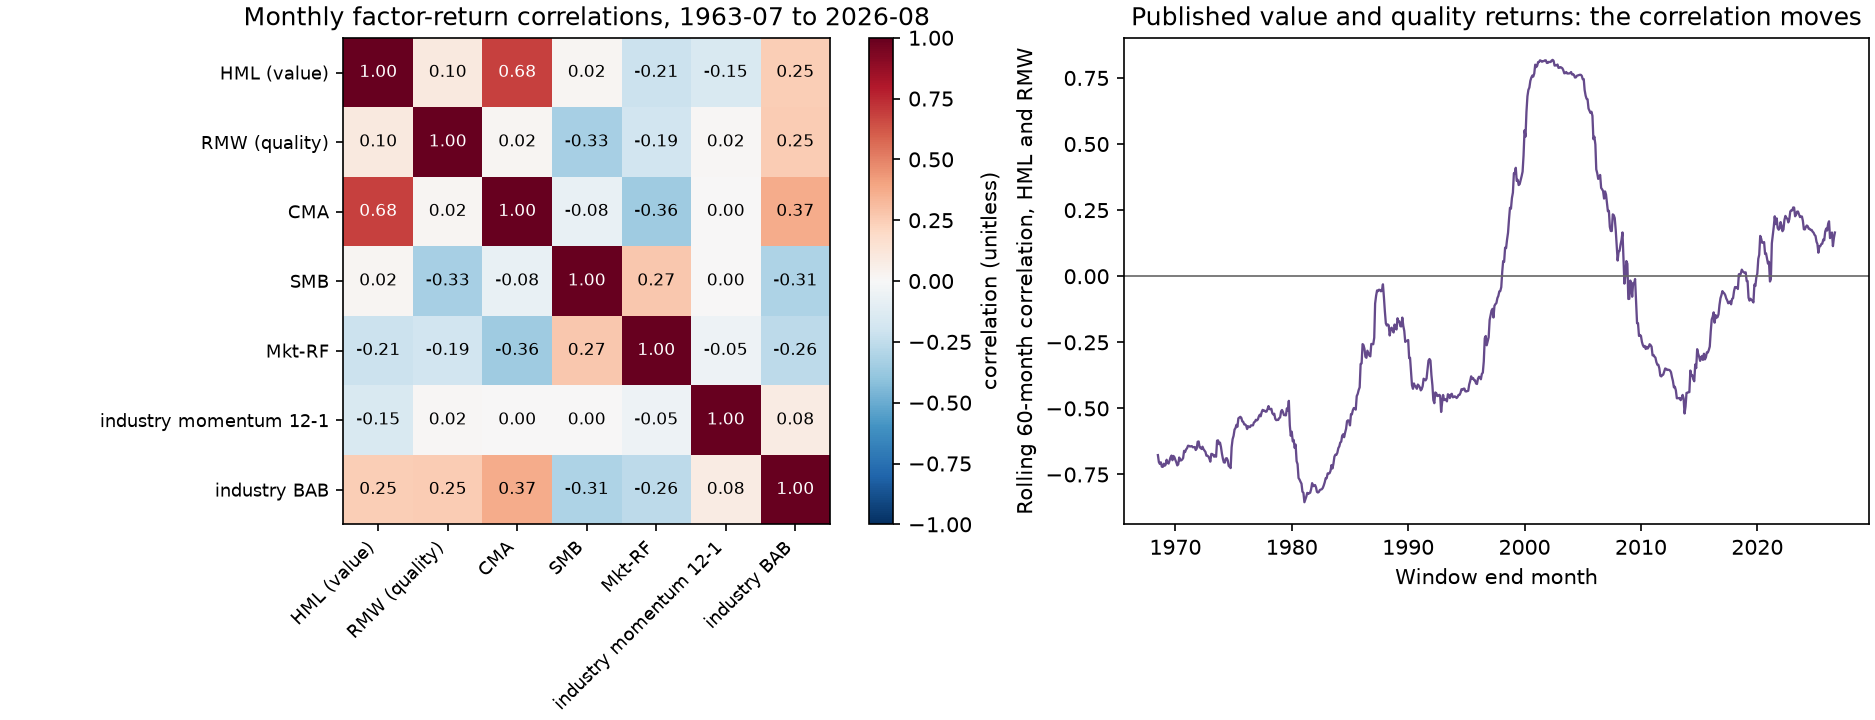
图 28-4:已发布因子收益的相关。 左图:FF5 的五个因子与两个由 10 个行业构造的策略(横截面动量 12–1 与 BAB)的月度收益相关矩阵(1963-07 至 2026-08,共 758 个月);右图:HML 与 RMW 的滚动 60 个月相关系数。读法:右图相关从 − 0.85 -0.85 − 0.85 + 0.82 +0.82 + 0.82 − 0.15 -0.15 − 0.15
11. 真实市场案例
数据与限制。 使用 2026-10-05 冻结的 French 五因子(2×3)月度数据(处理后 CSV SHA-256 833bd925b49651428781c789c13a6ac7454d4676449e6d119782050046a57eea,758 个月,1963-07 至 2026-08),以及第25、27章使用的 French 10 行业与 FF3 快照(处理后哈希见第25章)。因子的构造见 French 数据库五因子说明页:HML = 1 2 =\tfrac12 = 2 1 − 1 2 -\tfrac12 − 2 1 K = 1 K=1 K = 1
相关矩阵(758 个月)。
HML
RMW
CMA
SMB
Mkt-RF
行业动量
行业 BAB
HML(价值)
1.00
0.10
0.68
0.02
− 0.21 -0.21 − 0.21 − 0.15 -0.15 − 0.15 0.25
RMW(质量)
0.10
1.00
0.02
− 0.33 -0.33 − 0.33 − 0.19 -0.19 − 0.19 0.02
0.25
CMA
0.68
0.02
1.00
− 0.08 -0.08 − 0.08 − 0.36 -0.36 − 0.36 0.00
0.37
SMB
0.02
− 0.33 -0.33 − 0.33 − 0.08 -0.08 − 0.08 1.00
0.27
0.00
− 0.31 -0.31 − 0.31
Mkt-RF
− 0.21 -0.21 − 0.21 − 0.19 -0.19 − 0.19 − 0.36 -0.36 − 0.36 0.27
1.00
− 0.05 -0.05 − 0.05 − 0.26 -0.26 − 0.26
行业动量 12–1
− 0.15 -0.15 − 0.15 0.02
0.00
0.00
− 0.05 -0.05 − 0.05 1.00
0.08
行业 BAB
0.25
0.25
0.37
− 0.31 -0.31 − 0.31 − 0.26 -0.26 − 0.26 0.08
1.00
相关不稳定。 HML 与 RMW 的相关系数:全样本 0.095;1963-07 至 1999-12 为 − 0.335 -0.335 − 0.335 + 0.337 +0.337 + 0.337 − 0.855 -0.855 − 0.855 + 0.818 +0.818 + 0.818
等风险平均。 取 HML、RMW 与行业动量三条月度收益序列,每条除以它自己截至上个月的 expanding 标准差(至少 60 个月,用 ≤ t − 1 \le t-1 ≤ t − 1 − 0.035 -0.035 − 0.035 S 3 / 1 + 2 ρ ˉ S\sqrt3/\sqrt{1+2\bar\rho} S 3 / 1 + 2 ρ ˉ signal_time 不可得,所以不是可用的方法,数值接近只是这组数据的巧合。
能说什么,不能说什么。 可以说:已发布的价值与质量因子在 1963–2026 的相关系数在不同时期符号相反,该样本说明短窗口估计与跨期漂移风险,不能推出每个60月矩阵都必然不稳定;三个低相关的风险溢价序列等风险平均后的样本内夏普比率,与简化公式近似接近。不能说:(1)该组合在样本外也有 0.6 的夏普比率;3 个成分、698 个月的样本内数值,并且 HML 与 RMW 是已发布的修订历史,行业动量只是 10 个行业;(2)价值与质量因子“拥挤”:本章没有持仓、卖空利率或资金流数据;(3)逐股的多因子组合表现:本章的逐股实验只有构造面板;(4)任何成本、容量与可交易性。
12. 常见错误
错误 1:用全样本拟合的标准化。 对每只股票的信号时间序列用全样本均值与标准差,第 t t t + 1.0 +1.0 + 1.0 − 0.245 -0.245 − 0.245
错误 2:用整个面板的分位数缩尾。 把全部日期放在一起算 1% 与 99% 分位数,等于用了其他日期的分布(含未来)。修复:每个日期只用该日的截面分位数(winsorize_cross_section)。
错误 3:缩尾或 z 分数的参数按评价期 IC 来挑。 缩尾分位数(1%/99% 还是 5%/95%)、自由度、是否二次缩尾,都能在评价期上看到差别。修复:事前写入计划,变体进账本(第22章)。
错误 4:中性化用了事后的行业标签。 行业分类会被修订;在 signal_time 不可得的标签会让中性化用到未来。修复:行业标签用当时已知的版本(日期表形式的 groups),并报告标签缺失的比例。
错误 5:中性化拿走了真信号。 若行业偏移本身带来收益(真实的行业动量或价值),中性化把它扔掉。修复:把“是否中性化”写成研究假设,报告中性化前后的 IC;不要把构造世界里“有益”的结论搬到真实数据上。
错误 6:控制变量太多。 每多一个控制变量就多一个自由度;一个只有 8 只股票的日期用 10 个行业虚拟变量,残差恒为零。修复:自由度不足的日期输出 NaN(neutralize 的规则),报告被丢弃的日期数。
错误 7:把中性化信号与线性约束投影混为一谈。 对与信号成正比的权重它们相同(8.3),对分位数权重不同(10 节的约束表:行业净仓位平均最大 0.053 对 5 × 10 − 17 5\times10^{-17} 5 × 1 0 − 17
错误 8:事后选正交化顺序。 顺序可以把 IC 改变 36%(8.4)。修复:事前写明“基础因子在前”的规则,把所有顺序进账本。
错误 9:用评价期的表现选合成权重。 发现期 IC 成比例的权重在留出期只有 31.7% 的世界好于等权(10 节);最佳单因子 3.3%。修复:权重事前固定;或在发现期估计、在独立留出期评价,并记账。
错误 10:补零或重新加权后不报告覆盖与尺度。 本构造随机缺失样本中,重新加权使单因子名字在前五分位的占比相对其基准比例为1.55倍,补零使它们挤在中间(0.62 倍)。修复:设最少因子数,报告覆盖率与单因子名字的比例,对两种处理做敏感度。
错误 11:用一个 60 个月的相关矩阵配置权重。 HML 与 RMW 的相关系数在 1963–1999 为 − 0.34 -0.34 − 0.34 + 0.34 +0.34 + 0.34 − 0.86 -0.86 − 0.86 + 0.82 +0.82 + 0.82
错误 12:把信号层面的相关与收益层面的相关混淆。 信号相关(同日截面)决定合成 IC,收益相关(因子收益时间序列)决定多元化。两者可以符号不同(构造面板:信号相关 − 0.3 -0.3 − 0.3
错误 13:把头寸重叠当成拥挤的证明。 前五分位交集占比只是一个侧面;拥挤需要持仓、卖空与资金流数据(6.9)。
13. 量化研究应用
多因子流程契约(Project 4 信号层)。
步骤
变换
用到哪一天
谁在什么时候定参数
1
时点取版(第24–26章 latest_available_values)
信号月之前已可得
计划(可得规则)
2
同日缩尾(P4为1%/99%,字段至少30值)
当日截面
计划,看收益之前
3
同日中性化(行业与对数市值)
当日截面,行业标签为当时版本
计划
4
同日 z 分数(P4自由度1,最少10个;手算基础例最少3个)
当日截面
计划
5
合成(等权,最少 2 个因子,按可得因子重新加权)
当日
计划;权重变体进账本
6
分位数权重或与信号成正比的权重;线性约束(第21章投影)
当日
计划
7
评价:IC、分位数收益、换手、暴露
下月标签;留出期独立
发现期与留出期的划分写入计划
研究流程(构造面板,已知数据生成过程)。 冻结计划:假设“三个已处理因子的等权合成同日对下月收益有正的 Rank IC,且比任何单因子的 IC 更高”,主指标合成的平均 Rank IC 及其 t t t t = 10.5 t=10.5 t = 10.5
账本里的变体(本章的计数)。 缩尾(有/无)× 中性化(有/无)× 合成方式(等权、真载荷、四种顺序)× 缺失处理(4 种)× 约束(3 种),不是全部组合都评价了,但每个被评价的变体都要记账;评价的任一指标的 t t t
对 Project 4 的约束。 (1) 所有变换只用 ≤ \le ≤
13.1 C13的协议纠错与历史结果怎样一起读
第9–11节的原构造面板、图和French聚合诊断继续按各自输入解释,不把它们改写成新P4运行。旧A5/A6 P4是在全240列投影后再按上市状态过滤,保留的历史记录含1,842个名月被清零、过滤后最大行业净额0.0280748663。这暴露了协议与实现的不一致;不能用“已做行业投影”跳过支持集检查。
C13按原配置语义纠错:宇宙60名门槛在预处理/组合入口执行,可选行业投影只用信号listed支持集,齐次投影后恢复配置gross=2,退化现金显式记录,A6分别报告target与实际持仓残差。原始七字段、排序/合成公式、数据生成/seed和两份冻结配置不改。新的源SHA、旧新样本/权重/收益/成本差异和检查见已接受纠正的 P4协议对齐说明 。
此修复是在已经看过旧结果之后作的规范性对齐,不是新的盲预注册、独立市场检验或选参策略。收益变好或变差都要保留;配置gross和中性被恢复并不能证明alpha、借券可得性或容量。第29章继续负责执行账本与现金/费用对账,执行日状态不反向影响信号。
14. 本章小结
多因子流程分三层:预处理(同日截面变换,只改变尺度、离群值与不想要的暴露)、合成(权重事前固定)、约束(组合层面暴露)。信号含有与收益无关的干扰时,Pearson IC 按 1 / 1 + σ u 2 / σ s 2 1/\sqrt{1+\sigma_u^2/\sigma_s^2} 1/ 1 + σ u 2 / σ s 2 ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) (\rho_1+\rho_2)/\sqrt{2(1+r_{12})} ( ρ 1 + ρ 2 ) / 2 ( 1 + r 12 ) ∝ R − 1 ρ \propto R^{-1}\rho ∝ R − 1 ρ S k / 1 + ( k − 1 ) ρ ˉ S\sqrt k/\sqrt{1+(k-1)\bar\rho} S k / 1 + ( k − 1 ) ρ ˉ
15. 练习
28-E01(手算) 同一天 11 只股票的信号为 ( 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 11 , 12 , − 50 ) (3,4,5,6,7,8,9,10,11,12,-50) ( 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 11 , 12 , − 50 ) − 50 -50 − 50 − 50 -50 − 50
28-E02(手算) 8 只股票,行业 A 为前四只、行业 B 为后四只;信号 ( 2 , 0 , 1 , 3 , 10 , 8 , 12 , 6 ) (2,0,1,3,\ 10,8,12,6) ( 2 , 0 , 1 , 3 , 10 , 8 , 12 , 6 ) ( 6 , 2 , 4 , 8 , − 1 , − 3 , 1 , − 5 ) % (6,2,4,8,\ -1,-3,1,-5)\% ( 6 , 2 , 4 , 8 , − 1 , − 3 , 1 , − 5 ) %
28-E03(手算) 用 28-E02 的信号作权重 w w w A A A w − A ⊤ ( A A ⊤ ) − 1 A w w-A^\top(AA^\top)^{-1}Aw w − A ⊤ ( A A ⊤ ) − 1 A w + 1 / 2 +1/2 + 1/2 − 1 / 2 -1/2 − 1/2
28-E04(手算) 两个标准化信号,ρ 1 = 0.05 , ρ 2 = 0.03 , r 12 = 0.4 \rho_1=0.05,\rho_2=0.03,r_{12}=0.4 ρ 1 = 0.05 , ρ 2 = 0.03 , r 12 = 0.4
28-E05(手算) 四个因子等权,每个因子均值为0、方差为1,且任意两个不同因子的相关系数都为0.25。假设完全随机缺失(MCAR),使任意可得子集在给定缺失掩码后仍保持上述条件矩;仅给四因子总体平均相关0.25并不足够。一个名字有 k = 1 , 2 , 4 k=1,2,4 k = 1 , 2 , 4
28-E06(计算) 一只股票的信号序列 ( 4 , 6 , 8 , 20 ) (4,6,8,20) ( 4 , 6 , 8 , 20 ) signal_time 使用。
28-E07(计算) 四个因子,每个夏普比率 0.4,平均相关 0.25,等风险平均。求组合夏普比率;要使它达到 0.6,平均相关应是多少?平均相关的下界是多少?
28-E08(概念) 判断下列做法在 signal_time 是否可用,并说明理由:(a)每个日期对截面做 z 分数;(b)对每只股票的信号时间序列用全样本均值与标准差做 z 分数;(c)用整个面板(所有日期)的 1% 与 99% 分位数缩尾;(d)用信号月已知的行业标签做同日中性化;(e)用评价期 IC 最大的顺序做正交化;(f)用截至上个月的 expanding 标准差缩放因子收益。
28-N01(支持集、预算与因果时钟) 用第8.8节四名权重和行业标签:(a)a未上市时,列先全列投影再掩码的行业/net/gross,以及只在b,c,d上投影再恢复gross=2的权重与残差。(b)四名都上市,原分位权重 ( 1 , 0 , − 1 , 0 ) (1,0,-1,0) ( 1 , 0 , − 1 , 0 ) A = ( 1 , 1 ) , b = 1 , v = ( 0.5 , 0.5 ) A=(1,1),b=1,v=(0.5,0.5) A = ( 1 , 1 ) , b = 1 , v = ( 0.5 , 0.5 )
16. 编程练习
28-P01 用 neutralize 复现 28-E02:断言残差,断言原始与中性化后的 IC;再加一个规模控制列,断言残差与规模正交、行业内和为零。验收:四条断言通过。
28-P02 模拟两个相关系数为 0.5 的标准化信号与一个标签(ρ 1 = 0.04 , ρ 2 = 0.02 \rho_1=0.04,\rho_2=0.02 ρ 1 = 0.04 , ρ 2 = 0.02 sequential_orthogonal_ic 比较。验收:两个顺序的 IC 与公式相差小于 0.006,并且后一个顺序的 IC 比前一个大 0.006 以上。
28-P03 模拟 100 个世界:每个世界 300 只股票、120 个月,三个相互独立的标准正态信号对标签的贡献相同;用前 60 个月估计每个因子的平均 IC,权重取其正部(归一化),在后 60 个月比较调权与等权的平均 IC。验收:等权的平均留出期 IC 大于调权的,调权好于等权的世界不到 40%。
17. 挑战题
28-C01(推导) 对两个标准化信号,证明依次正交化后的 IC 满足
I C 1 → 2 − I C 2 → 1 = ρ 1 − ρ 2 2 [ 1 − 1 + r 12 1 − r 12 ] ,
\mathrm{IC}_{1\to2}-\mathrm{IC}_{2\to1}=\frac{\rho_1-\rho_2}{\sqrt2}\Bigl[1-\sqrt{\tfrac{1+r_{12}}{1-r_{12}}}\Bigr],
IC 1 → 2 − IC 2 → 1 = 2 ρ 1 − ρ 2 [ 1 − 1 − r 12 1 + r 12 ] , 并讨论:r 12 > 0 r_{12}>0 r 12 > 0 r 12 = 0 r_{12}=0 r 12 = 0
28-C02(开放) 为 Project 4 写多因子流程的冻结计划与数据缺口表:列出每一步(取版、缩尾、中性化、z 分数、合成、约束、评价)用到哪一天的数据、每个参数谁在什么时候定、需要哪些字段(含行业标签的历史版本与市值)、被记账的变体个数;说明在没有这些数据时哪些结论不能写;给出合成前必须先检验的三件事(相关、覆盖、时点)。评分:流程表 30,缺口表 30,不能写的结论 20,合成前检验 20。
18. 完整答案与解题说明
28-E01 升序:− 50 , 3 , 4 , … , 12 -50,3,4,\dots,12 − 50 , 3 , 4 , … , 12 ( n − 1 ) q = 10 × 0.1 = 1 (n-1)q=10\times0.1=1 ( n − 1 ) q = 10 × 0.1 = 1 9 9 9 q − = 3 q^-=3 q − = 3 q + = 11 q^+=11 q + = 11 − 50 → 3 -50\to3 − 50 → 3 12 → 11 12\to11 12 → 11 ( 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 11 , 11 , 3 ) (3,4,5,6,7,8,9,10,11,11,3) ( 3 , 4 , 5 , 6 , 7 , 8 , 9 , 10 , 11 , 11 , 3 ) 77 / 11 = 7 77/11=7 77/11 = 7 16 + 9 + 4 + 1 + 0 + 1 + 4 + 9 + 16 + 16 + 16 = 92 16+9+4+1+0+1+4+9+16+16+16=92 16 + 9 + 4 + 1 + 0 + 1 + 4 + 9 + 16 + 16 + 16 = 92 9.2 9.2 9.2 3.033 3.033 3.033 z = ( 11 − 7 ) / 3.033 = 1.319 z=(11-7)/3.033=1.319 z = ( 11 − 7 ) /3.033 = 1.319 25 / 11 = 2.27 25/11=2.27 25/11 = 2.27 17.57 17.57 17.57 − 50 -50 − 50 z = ( − 50 − 2.27 ) / 17.57 = − 2.975 z=(-50-2.27)/17.57=-2.975 z = ( − 50 − 2.27 ) /17.57 = − 2.975 + 0.04 +0.04 + 0.04 + 0.55 +0.55 + 0.55 − 50 -50 − 50 Φ − 1 ( 0.5 / 11 ) = − 1.691 \Phi^{-1}(0.5/11)=-1.691 Φ − 1 ( 0.5/11 ) = − 1.691
28-E02 行业 A 均值 1.5 1.5 1.5 ( 0.5 , − 1.5 , − 0.5 , 1.5 ) (0.5,-1.5,-0.5,1.5) ( 0.5 , − 1.5 , − 0.5 , 1.5 ) 9 9 9 ( 1 , − 1 , 3 , − 3 ) (1,-1,3,-3) ( 1 , − 1 , 3 , − 3 ) ∑ ( x − x ˉ ) y = − 0.75 \sum(x-\bar x)y=-0.75 ∑ ( x − x ˉ ) y = − 0.75 ∑ ( x − x ˉ ) 2 = 137.5 \sum(x-\bar x)^2=137.5 ∑ ( x − x ˉ ) 2 = 137.5 ∑ ( y − y ˉ ) 2 = 0.0138 \sum(y-\bar y)^2=0.0138 ∑ ( y − y ˉ ) 2 = 0.0138 y ˉ = 0.015 \bar y=0.015 y ˉ = 0.015 = − 0.75 / 137.5 × 0.0138 = − 0.544 =-0.75/\sqrt{137.5\times0.0138}=-0.544 = − 0.75/ 137.5 × 0.0138 = − 0.544 ∑ e y = 0.3 \sum ey=0.3 ∑ ey = 0.3 ∑ e ( y − y ˉ ) \sum e(y-\bar y) ∑ e ( y − y ˉ ) ∑ e 2 = 25 \sum e^2=25 ∑ e 2 = 25 = 0.3 / 25 × 0.0138 = + 0.511 =0.3/\sqrt{25\times0.0138}=+0.511 = 0.3/ 25 × 0.0138 = + 0.511
28-E03 A A ⊤ = d i a g ( 4 , 4 ) AA^\top=\mathrm{diag}(4,4) A A ⊤ = diag ( 4 , 4 ) A w = ( 6 , 36 ) Aw=(6,36) A w = ( 6 , 36 ) A ⊤ ( 1.5 , 9 ) A^\top(1.5,9) A ⊤ ( 1.5 , 9 ) w − ( 1.5 , 1.5 , 1.5 , 1.5 , 9 , 9 , 9 , 9 ) = ( 0.5 , − 1.5 , − 0.5 , 1.5 , 1 , − 1 , 3 , − 3 ) w-(1.5,1.5,1.5,1.5,9,9,9,9)=(0.5,-1.5,-0.5,1.5,1,-1,3,-3) w − ( 1.5 , 1.5 , 1.5 , 1.5 , 9 , 9 , 9 , 9 ) = ( 0.5 , − 1.5 , − 0.5 , 1.5 , 1 , − 1 , 3 , − 3 ) + 1 2 +\tfrac12 + 2 1 − 1 2 -\tfrac12 − 2 1 − 1 -1 − 1 + 1 +1 + 1 A w = ( − 1 , + 1 ) Aw=(-1,+1) A w = ( − 1 , + 1 ) A A ⊤ = d i a g ( 4 , 4 ) AA^\top=\mathrm{diag}(4,4) A A ⊤ = diag ( 4 , 4 ) − 0.25 -0.25 − 0.25 + 0.25 +0.25 + 0.25 ± 0.25 \pm0.25 ± 0.25 ( 0.25 , − 0.25 , − 0.25 , 0.25 ) (0.25,-0.25,-0.25,0.25) ( 0.25 , − 0.25 , − 0.25 , 0.25 ) ( 0.25 , − 0.25 , 0.25 , − 0.25 ) (0.25,-0.25,0.25,-0.25) ( 0.25 , − 0.25 , 0.25 , − 0.25 )
28-E04 等权:( 0.05 + 0.03 ) / 2 × 1.4 = 0.0478 (0.05+0.03)/\sqrt{2\times1.4}=0.0478 ( 0.05 + 0.03 ) / 2 × 1.4 = 0.0478 1 → 2 1\to2 1 → 2 1 2 [ 0.05 + ( 0.03 − 0.4 × 0.05 ) / 0.84 ] = 1 2 [ 0.05 + 0.0109 ] = 0.0431 \frac1{\sqrt2}[0.05+(0.03-0.4\times0.05)/\sqrt{0.84}]=\frac1{\sqrt2}[0.05+0.0109]=0.0431 2 1 [ 0.05 + ( 0.03 − 0.4 × 0.05 ) / 0.84 ] = 2 1 [ 0.05 + 0.0109 ] = 0.0431 2 → 1 2\to1 2 → 1 1 2 [ 0.03 + ( 0.05 − 0.4 × 0.03 ) / 0.84 ] = 1 2 [ 0.03 + 0.0415 ] = 0.0505 \frac1{\sqrt2}[0.03+(0.05-0.4\times0.03)/\sqrt{0.84}]=\frac1{\sqrt2}[0.03+0.0415]=0.0505 2 1 [ 0.03 + ( 0.05 − 0.4 × 0.03 ) / 0.84 ] = 2 1 [ 0.03 + 0.0415 ] = 0.0505 R − 1 ρ ∝ ( 0.05 − 0.4 × 0.03 , 0.03 − 0.4 × 0.05 ) = ( 0.038 , 0.010 ) R^{-1}\rho\propto(0.05-0.4\times0.03,\ 0.03-0.4\times0.05)=(0.038,0.010) R − 1 ρ ∝ ( 0.05 − 0.4 × 0.03 , 0.03 − 0.4 × 0.05 ) = ( 0.038 , 0.010 ) ( 0.792 , 0.208 ) (0.792,0.208) ( 0.792 , 0.208 ) = ρ ⊤ R − 1 ρ = 0.0512 =\sqrt{\rho^\top R^{-1}\rho}=0.0512 = ρ ⊤ R − 1 ρ = 0.0512 2 → 1 2\to1 2 → 1 0.0505 0.0505 0.0505 0.0512 0.0512 0.0512 ( ρ 1 − ρ 2 ) / 2 × [ 1 − 1.4 / 0.6 ] = 0.01414 × ( 1 − 1.5275 ) = − 0.00746 (\rho_1-\rho_2)/\sqrt2\times[1-\sqrt{1.4/0.6}]=0.01414\times(1-1.5275)=-0.00746 ( ρ 1 − ρ 2 ) / 2 × [ 1 − 1.4/0.6 ] = 0.01414 × ( 1 − 1.5275 ) = − 0.00746 I C 1 → 2 − I C 2 → 1 = 0.0431 − 0.0505 = − 0.0075 \mathrm{IC}_{1\to2}-\mathrm{IC}_{2\to1}=0.0431-0.0505=-0.0075 IC 1 → 2 − IC 2 → 1 = 0.0431 − 0.0505 = − 0.0075
28-E05 按题设等相关与MCAR,给定任意可得子集,因子仍为零均值、单位方差,子集内每对相关均为 r ˉ = 0.25 \bar r=0.25 r ˉ = 0.25 k k k ( 1 + ( k − 1 ) × 0.25 ) / k (1+(k-1)\times0.25)/k ( 1 + ( k − 1 ) × 0.25 ) / k k = 1 k=1 k = 1 k = 2 k=2 k = 2 k = 4 k=4 k = 4 k ( 1 + ( k − 1 ) × 0.25 ) / 16 k(1+(k-1)\times0.25)/16 k ( 1 + ( k − 1 ) × 0.25 ) /16 k = 1 k=1 k = 1 k = 2 k=2 k = 2 k = 4 k=4 k = 4 1 / 0.4375 = 2.29 1/0.4375=2.29 1/0.4375 = 2.29 0.0625 / 0.4375 = 0.143 0.0625/0.4375=0.143 0.0625/0.4375 = 0.143
28-E06 前三个观测 ( 4 , 6 , 8 ) (4,6,8) ( 4 , 6 , 8 ) z = ( 8 − 6 ) / 2 = + 1.0 z=(8-6)/2=+1.0 z = ( 8 − 6 ) /2 = + 1.0 ( 4 , 6 , 8 , 20 ) (4,6,8,20) ( 4 , 6 , 8 , 20 ) z = ( 8 − 9.5 ) / 7.19 = − 0.209 z=(8-9.5)/7.19=-0.209 z = ( 8 − 9.5 ) /7.19 = − 0.209 signal_time 它还不存在。
28-E07 S p = 0.4 × 2 / 1 + 3 × 0.25 = 0.8 / 1.3229 = 0.605 S_p=0.4\times2/\sqrt{1+3\times0.25}=0.8/1.3229=0.605 S p = 0.4 × 2/ 1 + 3 × 0.25 = 0.8/1.3229 = 0.605 S p = 0.6 S_p=0.6 S p = 0.6 1 + 3 ρ ˉ = 0.8 / 0.6 = 1.333 \sqrt{1+3\bar\rho}=0.8/0.6=1.333 1 + 3 ρ ˉ = 0.8/0.6 = 1.333 1 + 3 ρ ˉ = 1.778 1+3\bar\rho=1.778 1 + 3 ρ ˉ = 1.778 ρ ˉ = 0.259 \bar\rho=0.259 ρ ˉ = 0.259 − 1 / ( k − 1 ) = − 1 / 3 -1/(k-1)=-1/3 − 1/ ( k − 1 ) = − 1/3 S p S_p S p
28-E08 (a)有条件可用:当日字段/行业标签版本、参数政策均在 signal_time 已知,且只用该截面;同一行并不自动保证PIT。(b)不可用:全样本均值与标准差含未来。(c)不可用:用了其他日期(含未来)的分布;应逐日用截面分位数。(d)可用:条件是行业标签是 signal_time 已知的版本。(e)不可用:用评价期结果选顺序,是调参到测试集;顺序应事前定并全部记账。(f)可用:expanding 标准差只用截至上个月的数据,不含未来。
28-P01
import numpy as np
import pandas as pd
from quant_course.factor_preprocessing import neutralize
cols = list ("abcdefgh" )
sig = pd.DataFrame([[2 , 0 , 1 , 3 , 10 , 8 , 12 , 6.0 ]], index=pd.period_range("2026-06" , periods=1 , freq="M" ), columns=cols)
y = np.array([0.06 , 0.02 , 0.04 , 0.08 , -0.01 , -0.03 , 0.01 , -0.05 ])
groups = pd.Series(list ("AAAABBBB" ), index=cols)
res = neutralize(sig, groups=groups)
assert np.allclose(res.iloc[0 ], [0.5 , -1.5 , -0.5 , 1.5 , 1.0 , -1.0 , 3.0 , -3.0 ])
raw_ic, neutral_ic = np.corrcoef(sig.iloc[0 ], y)[0 , 1 ], np.corrcoef(res.iloc[0 ], y)[0 , 1 ]
assert abs (raw_ic + 0.5445 ) < 1e-4 and abs (neutral_ic - 0.5108 ) < 1e-4
size = pd.DataFrame([[1.0 , 2.0 , 0.5 , 3.0 , 2.5 , 1.5 , 0.2 , 4.0 ]], index=sig.index, columns=cols)
res2 = neutralize(sig, groups=groups, controls={"size" : size})
assert abs (np.dot(res2.iloc[0 ], size.iloc[0 ])) < 1e-10 and abs (res2.iloc[0 ].groupby(groups).sum ()).max () < 1e-10
28-P02
import numpy as np
from quant_course.factor_preprocessing import sequential_orthogonal_ic
rng = np.random.default_rng(1 )
n = 400_000
z = rng.multivariate_normal([0.0 , 0.0 ], [[1.0 , 0.5 ], [0.5 , 1.0 ]], size=n)
y = 0.04 * z[:, 0 ] + np.sqrt(1 - 0.04 ** 2 ) * rng.normal(size=n)
def sequential (first: int , second: int ) -> float :
e = z[:, second] - np.polyval(np.polyfit(z[:, first], z[:, second], 1 ), z[:, first])
return float (np.corrcoef(z[:, first] + e / e.std(), y)[0 , 1 ])
a, b = sequential(0 , 1 ), sequential(1 , 0 )
assert abs (a - 0.0283 ) < 0.006 and abs (b - 0.0386 ) < 0.006 and b - a > 0.006
assert abs (a - sequential_orthogonal_ic([0.04 , 0.02 ], [[1 , 0.5 ], [0.5 , 1 ]], [0 , 1 ])) < 0.006
28-P03
import numpy as np
rng = np.random.default_rng(5 )
worlds, n, months = 100 , 300 , 120
def mean_ic (sig: np.ndarray, lab: np.ndarray ) -> np.ndarray:
s = (sig - sig.mean(axis=1 , keepdims=True )) / sig.std(axis=1 , keepdims=True )
l = (lab - lab.mean(axis=1 , keepdims=True )) / lab.std(axis=1 , keepdims=True )
return (s * l).mean(axis=1 )
hold_eq, hold_tuned = [], []
for _ in range (worlds):
z = rng.normal(size=(months, n, 3 ))
label = 0.05 * z.sum (axis=2 ) + rng.normal(size=(months, n))
half = months // 2
disc = np.array([mean_ic(z[:half, :, k], label[:half]).mean() for k in range (3 )])
w = np.maximum(disc, 0.0 )
w = w / w.sum () if w.sum () > 0 else np.ones(3 ) / 3
hold_eq.append(mean_ic(z[half:].sum (axis=2 ), label[half:]).mean())
hold_tuned.append(mean_ic(z[half:] @ w, label[half:]).mean())
hold_eq, hold_tuned = np.array(hold_eq), np.array(hold_tuned)
assert hold_eq.mean() > hold_tuned.mean() and (hold_tuned > hold_eq).mean() < 0.4
28-C01 I C 1 → 2 = 1 2 [ ρ 1 + ρ 2 − r ρ 1 1 − r 2 ] \mathrm{IC}_{1\to2}=\frac1{\sqrt2}\bigl[\rho_1+\frac{\rho_2-r\rho_1}{\sqrt{1-r^2}}\bigr] IC 1 → 2 = 2 1 [ ρ 1 + 1 − r 2 ρ 2 − r ρ 1 ] I C 2 → 1 = 1 2 [ ρ 2 + ρ 1 − r ρ 2 1 − r 2 ] \mathrm{IC}_{2\to1}=\frac1{\sqrt2}\bigl[\rho_2+\frac{\rho_1-r\rho_2}{\sqrt{1-r^2}}\bigr] IC 2 → 1 = 2 1 [ ρ 2 + 1 − r 2 ρ 1 − r ρ 2 ] r = r 12 r=r_{12} r = r 12 1 2 [ ( ρ 1 − ρ 2 ) + ( ρ 2 − r ρ 1 ) − ( ρ 1 − r ρ 2 ) 1 − r 2 ] \frac1{\sqrt2}\bigl[(\rho_1-\rho_2)+\frac{(\rho_2-r\rho_1)-(\rho_1-r\rho_2)}{\sqrt{1-r^2}}\bigr] 2 1 [ ( ρ 1 − ρ 2 ) + 1 − r 2 ( ρ 2 − r ρ 1 ) − ( ρ 1 − r ρ 2 ) ] ( ρ 2 − r ρ 1 ) − ( ρ 1 − r ρ 2 ) = ( ρ 2 − ρ 1 ) ( 1 + r ) (\rho_2-r\rho_1)-(\rho_1-r\rho_2)=(\rho_2-\rho_1)(1+r) ( ρ 2 − r ρ 1 ) − ( ρ 1 − r ρ 2 ) = ( ρ 2 − ρ 1 ) ( 1 + r ) = ρ 1 − ρ 2 2 [ 1 − 1 + r 1 − r 2 ] =\frac{\rho_1-\rho_2}{\sqrt2}\bigl[1-\frac{1+r}{\sqrt{1-r^2}}\bigr] = 2 ρ 1 − ρ 2 [ 1 − 1 − r 2 1 + r ] 1 + r ( 1 − r ) ( 1 + r ) = 1 + r 1 − r \frac{1+r}{\sqrt{(1-r)(1+r)}}=\sqrt{\frac{1+r}{1-r}} ( 1 − r ) ( 1 + r ) 1 + r = 1 − r 1 + r r > 0 r>0 r > 0 ( 1 + r ) / ( 1 − r ) > 1 \sqrt{(1+r)/(1-r)}>1 ( 1 + r ) / ( 1 − r ) > 1 ρ 1 > ρ 2 \rho_1>\rho_2 ρ 1 > ρ 2 I C 1 → 2 < I C 2 → 1 \mathrm{IC}_{1\to2}<\mathrm{IC}_{2\to1} IC 1 → 2 < IC 2 → 1 r < 0 r<0 r < 0 r = 0 r=0 r = 0 w w w I C = w ⊤ ρ / w ⊤ R w ≤ max w = ρ ⊤ R − 1 ρ \mathrm{IC}=w^\top\rho/\sqrt{w^\top Rw}\le\max_w=\sqrt{\rho^\top R^{-1}\rho} IC = w ⊤ ρ / w ⊤ R w ≤ max w = ρ ⊤ R − 1 ρ v = R 1 / 2 w v=R^{1/2}w v = R 1/2 w w ⊤ ρ = v ⊤ R − 1 / 2 ρ ≤ ∥ v ∥ ∥ R − 1 / 2 ρ ∥ = w ⊤ R w ρ ⊤ R − 1 ρ w^\top\rho=v^\top R^{-1/2}\rho\le\|v\|\,\|R^{-1/2}\rho\|=\sqrt{w^\top Rw}\sqrt{\rho^\top R^{-1}\rho} w ⊤ ρ = v ⊤ R − 1/2 ρ ≤ ∥ v ∥ ∥ R − 1/2 ρ ∥ = w ⊤ R w ρ ⊤ R − 1 ρ z z z w ⊤ z w^\top z w ⊤ z
28-C02(评分依据与参考) 本课程现有数据里:有 French 五因子与 10 个行业月收益、构造面板;没有逐股的行业标签历史版本、市值与基本面的时点版本。流程表每行写:变换、用到哪一天、参数、谁在什么时候定;缺口表每行写:字段(行业标签、对数市值、各因子的原始字段)、需要的真实来源、时间字段、缺失规则。不能写:任何逐股多因子组合的收益、容量与成本;任何“拥挤”结论;任何把构造面板的 IC 数值当作真实 IC 的说法。合成前三件事:(1)相关:同日信号相关与因子收益相关,及它们在不同时期的值;(2)覆盖:每个因子的覆盖率与缺失是否与信号相关;(3)时点:每个字段的 available_at、行业标签版本,以及每个变换用到哪一天。
28-N01完整答案。 (a)掩码结果 ( 0 , − 0.4 , 0.3 , − 0.3 ) (0,-0.4,0.3,-0.3) ( 0 , − 0.4 , 0.3 , − 0.3 ) − 0.4 -0.4 − 0.4 − 0.4 -0.4 − 0.4 ( 0 , 0 , 0.3 , − 0.3 ) (0,0,0.3,-0.3) ( 0 , 0 , 0.3 , − 0.3 ) 10 / 3 10/3 10/3 ( 0 , 0 , 1 , − 1 ) (0,0,1,-1) ( 0 , 0 , 1 , − 1 ) ( 0.5 , − 0.5 , − 0.5 , 0.5 ) (0.5,-0.5,-0.5,0.5) ( 0.5 , − 0.5 , − 0.5 , 0.5 ) ( 0 , 0 , 0.8 , − 0.6 ) (0,0,0.8,-0.6) ( 0 , 0 , 0.8 , − 0.6 ) A v = 1 Av=1 A v = 1 2 v = ( 1 , 1 ) 2v=(1,1) 2 v = ( 1 , 1 ) A ( 2 v ) = 2 ≠ 1 A(2v)=2\ne1 A ( 2 v ) = 2 = 1 b = 0 b=0 b = 0
19. 进一步阅读
Must Know:Ken French 数据库五因子说明页,读 HML、RMW、CMA、SMB 的构造与样本条件。
Must Know:本课程第22章的试验账本与多重检验(Bonferroni、Holm、Benjamini–Hochberg),多因子流程里的每个自由度都进账本。
Should Know:Gelman 与 Loken 关于数据依赖的分析路径(第22章来源笔记,工作稿),读“分析路径随数据而定”的论述。
Should Know:本课程第21章的 project_to_constraints 与暴露报告,读线性约束投影的推导。
Advanced:Asness、Moskowitz 与 Pedersen 关于价值与动量在多资产类中的组合;Fama 与 French(2015)关于五因子对价值因子冗余的讨论;本章未读它们关于因子相关与组合的结果。
Optional:任何一份公开的基金持仓披露,练习度量两个因子前五分位名字的重叠;本课程没有持仓数据。
20. 参考文献
引用键与读取范围见 source_notes.md 。
CH28_FF5_PAGE:Kenneth R. French Data Library,“Description of Fama/French 5 Factors (2x3)”(HML、RMW、CMA、SMB 与市场的构造与样本条件)。
CH22_GELMANLOKEN2013:Gelman, A., Loken, E. (2013),未发表工作稿(见第22章来源笔记)。
CH25_FRENCH_IND:French 10 行业与 FF3 快照(第25章来源笔记),及其构造的 12–1 动量与 BAB 策略(第25、27章)。
FRENCH:French 五因子冻结快照(data/manifests/french_factors_2026-10-05.json)。