第 24 章/ 45
价值因子(Value Factors)
主线:把“价格相对基本面便宜”写成方向统一、分子分母口径一致、在
signal_time已经可得的信号,并说明为什么每一步的疏忽都会制造看起来像价值效应的假象。 先修:第12章(财务报表)、第13章(估值)、第23章(截面研究)。完成后你能:给出账面市值比(Book-to-Market, B/M)、盈利收益率(Earnings Yield, E/P)、自由现金流收益率(FCF Yield)、企业价值倍数(EV/EBITDA)的分子分母、方向与适用行业;处理负分母;用同日行业内百分位消除行业水平;按available_at与ingested_at选择时点版本并识别前视;解释价值陷阱;读懂已发布的 HML 价值因子收益,并说明它不能检验逐股价值信号。
1. 本章目标
读者应能回答:同一家公司在某个月末,“便宜”到底是怎么算出来的、那一刻谁已经知道了这些数。
- 对每个价值比率写出分子、分母、单位和方向(比率越大越便宜还是越小越便宜),并区分收益率形式(yield)与倍数形式(multiple)。
- 对负盈利、负账面权益、零或负的企业价值(Enterprise Value, EV)、非正的 EBITDA 给出明确的缺失规则,说明每条规则的偏差来源。
- 说明金融业(银行、保险)为什么不适用 EV 与 EBITDA,为什么用同日行业内百分位而不是全市场排序。
- 用
latest_available_values从含重述的财报版本表得到每个月末的时点基本面,并写出区别于“报告期末”与“当前重述值”的三个反例。 - 用构造数据复现三件事:行业水平稀释 IC;前视账面值的日历信号月 IC 诊断;价值陷阱拥挤在最便宜的十分位。
- 读取已发布的 HML 月收益,报告均值、
、分期与最大回撤,并说明它描述聚合因子收益,不构成对任何逐股价值信号的检验。
完成标准:任何一个价值信号都能附一张字段表(来源、period_end、available_at、ingested_at、单位),并能说明每个数字在哪个信号月可用。
2. 为什么 Quant 需要它
第23章给了截面工具:只要有一列在 signal_time 已知的信号,就能算逐期 IC 与分位组合。价值因子是第一个需要先造出这一列的因子,而这一步的错误几乎不会报错:分母为负的比率照样能算,报告期末的数字照样能对齐到月末,银行与软件公司的账面市值比照样能放在一起排序。每个错误都会产生一个看起来合理的数字,有的会让信号看起来更有效。
本章的逻辑链是:先定义比率与方向(4–5 节),再处理边界与口径(6.1–6.3),再回答“这个数什么时候可知”(6.4),再用构造面板量化三类错误对 IC 的影响(10–13 节),最后看已发布的价值因子收益(11 节)。第25–28章会反复使用这里的结论:第26章的质量指标面对同样的分母与可得时间问题,第28章把行业内变换放进预处理。
3. 直觉
“便宜”是一句相对的话:同样每年赚 5 元,一家公司卖 50 元,另一家卖 80 元,前者便宜。把这句话变成信号有四个动作:选一个衡量“赚多少”的会计量(账面权益、盈利、现金流);选一个衡量“花多少”的价格量(市值或企业价值);把比率换成统一方向(越大越便宜);在同日、同行业内排序。
每个动作都有陷阱。会计量若为负,在 B/M、E/P 等收益率形式中通常位于分子;在 P/E 等倍数形式中则可能位于分母。比率因此可能为负,但它并不意味着“更便宜”,只意味着公司亏损或资不抵债。价格量与会计量必须对应同一类索取权:给股东的现金流除以股权市值,给全体资本提供者的现金流除以企业价值。会计数字来自财报,财报在财年结束后几个星期甚至几个月才发布,还可能被重述;在年报发布前,市场并不知道那些数字,所以信号也不能知道。行业之间资本结构与会计习惯不同,银行的账面市值比结构性偏高,拿它与软件公司在同一个榜单上排序,排出来的是行业,不是个股。
简化的边界:本章用一个只有两种行业的构造面板演示这些机制。真实市场有几十个行业、几千只股票、季度财报与更多会计差异;构造数据只能说明机制和量级,不能替代对真实数据的研究。
3.1 先算一家公司的资本索取权账
4. 数学基础
记号。 月末 signal_time,资产
企业价值桥。 第13章的定义:
排序与单调变换。 对正数
同日行业内百分位。 对同一日期、同一行业内有有效值的
时点版本(Point-in-Time, PIT)。 每条财报版本 period_end(报告期末)、available_at(外部可得时刻)、ingested_at(本地入库时刻)。给定截止时刻
频率约定:月频;signal_time 是月末;价格与市值取月末;会计量按财年;信号对应下一个月的收益。
5. 正式定义
账面市值比(Book-to-Market ratio, B/M)。
盈利收益率(Earnings Yield, E/P)。
自由现金流收益率(FCF Yield)。 股东口径:自由现金流归股权持有者(Free Cash Flow to Equity, FCFE),除以市值;公司口径:自由现金流归全体资本提供者(Free Cash Flow to the Firm, FCFF),除以企业价值。两种口径必须匹配(6.2 节)。
EV/EBITDA。 倍数形式,越小越便宜。EBITDA 为息税折旧摊销前利润(Earnings Before Interest, Taxes, Depreciation and Amortization);EBITDA 不为正时倍数没有意义,给出 NaN。
行业内相对价值(industry-relative value)。 把信号换成同日、同行业的百分位,使比较只发生在会计结构相似的公司之间。
价值陷阱(value trap)。 在比率上看起来便宜、实际预期收益并不高甚至为负的资产,往往因为基本面正在恶化(盈利下滑、负债上升)而价格已经下跌。它不是一个新的比率,而是“便宜”这个信号在一部分样本里不成立。
点时版本、报告期与重述。 period_end 是财务数字所属期间的结束日,不是可得日;available_at 是外部能获得该版本的最早时刻;重述(restatement)是对同一期间发布的更新版本,晚于原始版本;一个信号月只能使用该月之前已发布的版本,之后的重述不能回填。第3章与第13章已给出 pit_asof_join 和 select_pit_vintage;本章的 latest_available_values 做另一件事:为每个月末选“最新的已知报告期里的最新版本”。
价值因子收益(HML)。 已发布的高减低(High Minus Low)因子:
特征与因子收益的区别。 B/M 是一个特征(characteristic),属于第
6. 推导
6.1 比率方向、负值与缺失规则
方向。 收益率形式(B/M、E/P、FCF/EV)越大越便宜;倍数形式(EV/EBITDA、P/E)越小越便宜。对分母和分子均为正的比率,倍数升序与其倒数收益率降序的名次对应(4 节),但数值、z 分数及合成不等价。因此组合信号前先统一排序方向:cheapness_percentile(kind="multiple") 对倍数的相反数
非正会计基准。 若
负盈利。 yield_ratio 保留符号,ev_to_ebitda 要求 EBITDA 与 EV 均为正。
零或负的市值与企业价值。 市值非正说明数据错误;企业价值为负(现金大于市值加债务)意味着桥项的会计口径值得核查,倍数无意义。
6.2 分子与分母的口径匹配:FCFF 与 FCFE
股权持有者的现金流等于公司现金流扣除对债权人的净支付:
恒等式对正、负FCFF都成立,但
在
6.3 为什么要行业内排序:行业水平稀释 IC
设每家公司的对数账面市值比
其中用到
6.4 时点选择规则与因果性
对安全标识
即在已知版本中取最新的报告期,再取该报告期里最晚的发布,再取入库最晚者。性质:(1) 因果性:加入 available_at 或 ingested_at 晚于 period_end 更大,available_at 但数值不同的两行是歧义,函数拒绝,不去猜。
三个会引起前视的常见替代方案:以 period_end 为可得日(财年末 12 月 31 日的数字被拿来做 1 月的信号,而年报 3 月才发布);用全部历史里最后一版(当前重述值)回填;用抓取时间或文件创建时间代替 available_at。第 8.4 节与第 12 节给出数值例。
6.5 前视的日历信号月 IC 诊断
给定构造把财年账面新息
因此本章报告的“前视IC较高”是指定生成机制、参数和样本的已观察方向,不是一般不等式,也不保证每个有限样本重复都同向。真实审计应直接比较同一配对样本的PIT与前视信号,不能仅凭更大的协方差判断相关。
图24-2横轴是信号月,标签是下月收益;在本例财年末12月31日后60–110天披露(晚2月/3月至4月),两种信号在1–3月的已观察IC不同,4月后相同。须按信号月与标签月的真实对齐解释,不能把横轴月份直接叫公告月份。其他前视方式可能提高、降低或不改变IC;更好的历史表现也应接受可得时间审计。
6.6 价值陷阱的混合均值
设最便宜的十分位里有比例
6.7 HML 的组合算术
HML 是四个价值加权组合收益的算术组合:两个“价值”组合(小盘价值、大盘价值)的平均,减两个“成长”组合(小盘成长、大盘成长)的平均。这样的平均使 HML 在小/大盘桶权重上配平:价值端与成长端各含一半小盘与一半大盘。这不保证两端实际市值或规模因子 beta 精确相等。若某月四个组合收益分别为
7. 金融解释
价值信号测的是价格与基本面的距离,不是公司质量。 一家公司的 B/M 高,意味着市场给它每一元账面权益的价格低。原因可能是市场对它的现金流预期低,也可能是它被暂时低估。两种情形在比率上无法区分。在误定价解释下,后续价格修复要求市场此前确有过度悲观;这不是所有价值溢价的必要条件,风险补偿与代理测量也可能产生正关联。价值陷阱则提示低价可能合理地反映持续恶化的基本面。
价值溢价是否存在、是否稳定,不由本章判决。 已发布的 HML 在 1926–2026 平均每月 0.35%(
风险解释与行为解释存在争论,本章不裁决。 一种观点把价值溢价看作对某种风险的补偿,另一种观点把它看作价格对信息反应不足;原始文献本章没有读(来源笔记),正文不转述任何一方的论证。对 Quant 的要求是:无论哪一种,信号必须在 signal_time 可构造,成本必须扣除,失效情形(价值陷阱、行业集中、因子拥挤)必须被讨论。
行业口径是经济问题,不只是技术处理。 银行的“债务”是经营原料,利息是成本,EV 与 EBITDA 对它们没有意义;银行的账面权益受监管资本约束,B/M 的水平与软件公司不可比。用行业内百分位的做法回答的是“它在同类里便宜吗”,而不是“它在全市场里便宜吗”。代价是丢掉了行业之间的价值信息:若整个银行业都便宜,行业内排序看不见。第28章用行业中性化与行业暴露约束把这件事写成显式选择。
比较时点比比较公式更重要。 两家研究者用同一个 B/M 公式,若一方在年报发布前用了新账面值,在本章指定构造中,年报公开前形成的部分信号,对应的下月收益 IC 偏高;两者的公式相同,数据时点不同。可复现的价值研究必须同时公布公式与时点规则。
7.1 从“便宜”到可检验的经济假说
比率描述价格与某个会计锚的关系;收益方向还需要一个假说。风险补偿假说说:便宜组可能承担更严重的经营衰退或融资压力,所以投资者要求更高回报;它预测的不只是平均收益,也包括坏状态下的损失。误定价假说说:市场可能对坏消息外推过度,后来现金流没有预想的差,价格修复;它要求事前区分预期与后来的信息,而不是事后给赢家贴“低估”标签。代理测量假说说:高 B/M 可能只是重资产行业、杠杆或会计无形资产处理的代理,所谓价值效果来自这些差异。
这些是待检验的机制,不是本章已核原文的文献结论。可以在第22章冻结三个问题:便宜组合的收益是否集中于坏状态的补偿;收益是否随可观测现金流预期误差变化;在行业与规模控制后关联还剩多少。控制变量也可能切掉真正的经济通道,故“残差信号更纯”不能凭名称下结论。第23章的 IC 只回答给定样本中排名与下一标签的关联;正 IC 或正毛价差均不能单独判定机制或成本后 Alpha(相对明确风险模型的截距)。
价值陷阱把这条链具体化:价格下跌会机械提高 B/M;若基本面继续恶化,低价格可能是合理预期。质量指标能提供盈利、现金流和杠杆的另一组事前观测,却不能保证筛掉所有陷阱。第26章讨论这些观测如何形成,第28章才讨论如何合成。
8. 数值例题:手算每一步
所有数字由 hand_examples() 产生,并在 qa/a5/claude/recompute/ch24_recompute.py 里用不同实现复核。公司为教学构造(Orion 与 Lyra 取自第13章,其余为本章构造),不是真实公司。
8.1 同一行业两家公司的四种口径(Orion 与 Lyra)
单位百万美元。Orion:价格 60,股数 10,市值 600;债务 100,现金 50,企业价值
| 口径 | Orion | Lyra | 更便宜 |
|---|---|---|---|
| B/M | 180/600 = 0.300 | 120/480 = 0.250 | Orion |
| E/P | 30/600 = 5.00% | 20/480 = 4.17% | Orion |
| FCFE/市值 | 28/600 = 4.67% | 18/480 = 3.75% | Orion |
| FCFF/EV | 40/650 = 6.15% | 40/750 = 5.33% | Orion |
| EV/EBITDA | 650/75 = 8.67 | 750/75 = 10.00 | Orion |
五种口径一致认为 Orion 更便宜。注意两家公司 EBITDA 与 FCFF 完全相同(75 与 40),区别全在企业价值:Lyra 的杠杆使它在 EV 口径下更贵,在市值口径下不一定。
8.2 两个行业七家公司:全市场排序与行业内排序
制造类 4 家:Orion、Lyra、Forge(价格 20,股数 30,市值 600,账面权益 480)、Gear(价格 50,股数 8,市值 400,账面权益 200);银行 3 家:Harbor(价格 30,股数 20,市值 600,账面权益 540)、Summit(价格 45,股数 10,市值 450,账面权益 360)、Delta(价格 12,股数 40,市值 480,账面权益 336)。
| 公司 | 行业 | B/M | 全市场平均名次 | 全市场百分位 | 行业内百分位 |
|---|---|---|---|---|---|
| Orion | 制造 | 0.300 | 2 | 0.167 | 0.333 |
| Lyra | 制造 | 0.250 | 1 | 0.000 | 0.000 |
| Forge | 制造 | 0.800 | 5.5 | 0.750 | 1.000 |
| Gear | 制造 | 0.500 | 3 | 0.333 | 0.667 |
| Harbor | 银行 | 0.900 | 7 | 1.000 | 1.000 |
| Summit | 银行 | 0.800 | 5.5 | 0.750 | 0.500 |
| Delta | 银行 | 0.700 | 4 | 0.500 | 0.000 |
计算:全市场
8.3 负分母与缺失规则
五家公司(单位同上):
| 公司 | 净利润 |
账面权益 |
市值 |
企业价值 |
EBITDA | E/P | B/M | EV/EBITDA |
|---|---|---|---|---|---|---|---|---|
| 正常 | 30 | 180 | 600 | 650 | 75 | 0.050 | 0.300 | 8.67 |
| 亏损 | 40 | 100 | 150 | 20 | 0.400 | 7.50 | ||
| 负账面 | 8 | 200 | 260 | 30 | 0.040 | NaN | 8.67 | |
| 零市值(数据错误) | 5 | 50 | 0 | 10 | 5 | NaN | NaN | 2.00 |
| 负 EBITDA | 12 | 70 | 300 | 320 | 0.040 | 0.233 | NaN |
规则:E/P 与 EV/EBITDA 的分母必须为正,B/M 要求账面权益与市值均为正;yield_ratio 保留分子符号(亏损公司
接近零的正分母。 分母严格为正并不等于安全:EV=100、EBITDA=0.01 时倍数是 10,000 倍,EBITDA=-0.01 时则为 NaN,两家几乎相同的公司被分到两端。规则是:先在研究计划里预先写明下限或处理方式(本章不设下限,只要求分母为正),报告被剔除/缺失的覆盖率,并在加入下限(例如 EBITDA 占 EV 的比例低于某阈值置 NaN)后做敏感性检验。名次变换会限制极端倍数对量级的影响,但不改变这家公司被排在最“昂贵”一端这一判断本身,所以它不能替代这条政策。
8.4 时点选择:一家公司的四条版本
证券 S1 的版本表:
| 报告期 | 数值(账面权益) | available_at |
ingested_at |
|---|---|---|---|
| FY2021 | 80 | 2022-03-15 16:05 | 2022-03-15 16:12 |
| FY2022 | 100 | 2023-03-15 16:05 | 2023-03-15 16:12 |
| FY2022 重述 | 90 | 2023-11-20 16:05 | 2023-11-20 16:12 |
| FY2023 | 120 | 2024-03-12 16:05 | 2024-03-12 16:12 |
各月末信号使用的账面权益:2023-02 末:FY2022 尚未发布(3 月 15 日才发布),取 FY2021,值 80。2023-03 末:FY2022 已发布,值 100。2023-10 末:仍是 100,重述尚未发布。2023-11 末:重述已发布(11 月 20 日),取该期最晚发布,值 90。2024-02 末:仍是 90。2024-03 末:FY2023 已发布,期间更新,取 FY2023,值 120。三个反例:以 period_end 为可得日,2023-01 末就会用到 FY2022 的 100;用“全部历史最后一版”回填,2023-03 末会用到 90,而当时市场只知道 100;若 2023-03-15 那条的 ingested_at 是 2023-04-02(本地入库晚了),2023-03 末本地系统只知道 80,下个月才知道 100。测试 test_pit_late_ingestion_and_month_end_boundary 覆盖了后一情形与月末恰好一秒的边界。
8.5 FCFF 除以市值的杠杆放大
Lyra:
8.6 HML 的组合算术
某月四个价值加权组合收益:小盘价值 1.4%,大盘价值 0.8%,小盘成长 0.4%,大盘成长 0.6%:
8.7 行业水平对 IC 的稀释
9. Python 实现
核心在 factor_signals.py(价值比率与时点选择)、factor_research.py(group_percentile)。第13章 valuation.py 的 Amount、enterprise_value、FinancialVintage、select_pit_vintage 保持不变,本章复用其企业价值桥。
| 函数 | 输入 | 输出与边界 |
|---|---|---|
positive_denominator_ratio |
两张同标签的日期×资产表 | 分子/分母;分母非正或任一缺失为 NaN;可要求分子为正;标签不一致、布尔、无穷报错 |
book_to_market |
账面权益、市值 | B/M;默认账面权益非正为 NaN |
yield_ratio |
现金流或盈利、对应索取权价值 | 保留分子符号;分母须为正 |
ev_to_ebitda |
企业价值、EBITDA | 倍数;EV 与 EBITDA 均须为正 |
cheapness_percentile |
比率表、kind="yield"或"multiple" |
同日百分位,1 最便宜;倍数对负值排名而非取倒数 |
group_percentile |
信号表、行业标签(静态或带日期)、最小组大小 | 同日行业内百分位;组内有效资产不足为 NaN;标签缺失为 NaN |
latest_available_values |
版本长表、月度 PeriodIndex、取值列 |
每个月末每个证券最新已知的报告期的最晚版本;要求时区;歧义行报错;月末最后一刻为截止 |
默认离线入口(从 I3 阅读包根目录运行):
.venv/bin/python run_notebook.py notebooks/ch24_value_factors.ipynb
默认 RUN_FRENCH=False。展示手算比率、缺失政策、行业排名和PIT版本,并用300家公司×108个月、种子20261031的构造面板演示;只创建章节 RUN_DIR,不写CSV/PNG/JSON或生成历史图库。 runner另写 runs/execution_<stem>_<uuid>/ 的执行副本与状态。Notebook英语语言层及整包路径在BIL23装配;下列为历史完整CLI与测试参考,并非默认离线命令:
.venv/bin/python code/ch24_value_factors.py
.venv/bin/python -m pytest tests/test_ch24_value.py tests/test_ch24_workflow.py -q
CLI 种子 20261031(构造面板)。数据频率月;signal_time 是月末的最后一刻(UTC);信号对应下一个月收益;French HML 是已发布的聚合月度价差,经哈希核对读取,修订历史。
代码段一:五种口径、EV 桥与负分母规则(8.1、8.3 节)。
import numpy as np
import pandas as pd

from quant_course.factor_signals import book_to_market, ev_to_ebitda, yield_ratio
from quant_course.valuation import Amount, enterprise_value

unit = "USD millions"
lyra_cap = Amount(24.0 * 20.0, "USD", unit)
lyra_ev = enterprise_value(lyra_cap, Amount(260, "USD", unit), Amount(30, "USD", unit),
                           noncontrolling_interest=Amount(40, "USD", unit), preferred_equity=Amount(20, "USD", unit),
                           nonoperating_assets=Amount(20, "USD", unit))
assert lyra_ev.value == 750.0
assert abs(40 / lyra_ev.value - 0.053333) < 1e-6 and abs(40 / lyra_cap.value - 0.083333) < 1e-6   # FCFF/EV vs the mismatched FCFF/market cap

idx = pd.period_range("2026-06", periods=1, freq="M")
cols = ["normal", "loss", "neg_book", "zero_cap", "neg_ebitda"]
earn = pd.DataFrame([[30.0, -10.0, 8.0, 5.0, 12.0]], index=idx, columns=cols)
book = pd.DataFrame([[180.0, 40.0, -25.0, 50.0, 70.0]], index=idx, columns=cols)
cap = pd.DataFrame([[600.0, 100.0, 200.0, 0.0, 300.0]], index=idx, columns=cols)
ev = pd.DataFrame([[650.0, 150.0, 260.0, 10.0, 320.0]], index=idx, columns=cols)
ebitda = pd.DataFrame([[75.0, 20.0, 30.0, 5.0, -4.0]], index=idx, columns=cols)
ep, bm, mult = yield_ratio(earn, cap).iloc[0], book_to_market(book, cap).iloc[0], ev_to_ebitda(ev, ebitda).iloc[0]
assert abs(ep["loss"] + 0.10) < 1e-12 and np.isnan(ep["zero_cap"])                      # sign of the flow kept; zero market cap -> NaN
assert np.isnan(bm["neg_book"]) and abs(bm["neg_ebitda"] - 70 / 300) < 1e-12
assert abs(mult["zero_cap"] - 2.0) < 1e-12 and np.isnan(mult["neg_ebitda"])
print(pd.DataFrame({"E/P": ep, "B/M": bm, "EV/EBITDA": mult}).round(4))
代码段二:全市场排序与行业内百分位(8.2 节)。
import numpy as np
import pandas as pd

from quant_course.factor_research import factor_rank, group_percentile

firms = ["Orion", "Lyra", "Forge", "Gear", "Harbor", "Summit", "Delta"]
industry = pd.Series(["Mfg"] * 4 + ["Bank"] * 3, index=firms)
bm = pd.DataFrame([[0.30, 0.25, 0.80, 0.50, 0.90, 0.80, 0.70]], index=pd.period_range("2026-06", periods=1, freq="M"), columns=firms)
raw = factor_rank(bm).iloc[0]
inside = group_percentile(bm, industry).iloc[0]
np.testing.assert_allclose(raw.to_numpy(), [1 / 6, 0, 0.75, 1 / 3, 1, 0.75, 0.5])
np.testing.assert_allclose(inside.to_numpy(), [1 / 3, 0, 1, 2 / 3, 1, 0.5, 0])
assert raw["Forge"] == raw["Summit"] and inside["Forge"] > inside["Summit"]                  # tied overall, ordered inside the industry
print(pd.DataFrame({"raw": raw, "within_industry": inside}).round(3))
代码段三:时点版本选择,含重述、晚入库、月末边界(8.4 节)。
import numpy as np
import pandas as pd

from quant_course.factor_signals import latest_available_values

versions = pd.DataFrame({
    "security_id": ["S1"] * 4,
    "period_end": pd.to_datetime(["2021-12-31", "2022-12-31", "2022-12-31", "2023-12-31"]),
    "available_at": pd.to_datetime(["2022-03-15 16:05", "2023-03-15 16:05", "2023-11-20 16:05", "2024-03-12 16:05"], utc=True),
    "ingested_at": pd.to_datetime(["2022-03-15 16:12", "2023-03-15 16:12", "2023-11-20 16:12", "2024-03-12 16:12"], utc=True),
    "book_equity": [80.0, 100.0, 90.0, 120.0]})
months = pd.period_range("2023-02", "2024-03", freq="M")
pit = latest_available_values(versions, months, ["book_equity"])["book_equity"]["S1"]
assert [pit[pd.Period(m)] for m in ("2023-02", "2023-03", "2023-10", "2023-11", "2024-02", "2024-03")] == [80, 100, 100, 90, 90, 120]

late = versions.copy()                                                    # filed Mar 15 but entered the local database on Apr 2
late.loc[1, "ingested_at"] = pd.Timestamp("2023-04-02 09:00", tz="UTC")
pit_late = latest_available_values(late, months, ["book_equity"])["book_equity"]["S1"]
assert pit_late[pd.Period("2023-03")] == 80 and pit_late[pd.Period("2023-04")] == 100

future = pd.concat([versions, versions.iloc[[3]].assign(book_equity=999.0, available_at=pd.Timestamp("2025-01-01", tz="UTC"),
                                                         ingested_at=pd.Timestamp("2025-01-01", tz="UTC"),
                                                         period_end=pd.Timestamp("2024-12-31"))], ignore_index=True)
changed = latest_available_values(future, months, ["book_equity"])["book_equity"]["S1"]
pd.testing.assert_series_equal(pit, changed)                              # a version published after the last signal changes nothing
print(pit.to_dict())
代码段四:前视的日历月诊断(6.5、12 节)。
import numpy as np
import pandas as pd

from quant_course.factor_research import group_percentile, ic_series, lead_return
from quant_course.factor_signals import book_to_market

rng = np.random.default_rng(5)
months, firms = 72, 200
idx = pd.period_range("2015-01", periods=months, freq="M")
cols = [f"F{i:03d}" for i in range(firms)]
cap = pd.DataFrame(np.exp(rng.standard_normal((months, firms))), index=idx, columns=cols)
book_old = pd.DataFrame(np.exp(rng.standard_normal((months, firms))), index=idx, columns=cols)
returns = pd.DataFrame(0.07 * rng.standard_normal((months, firms)), index=idx, columns=cols)
book_new = book_old.copy()
for year in sorted({p.year for p in idx}):
    news = rng.standard_normal(firms)                                     # book-value news filed in March of this year
    march, early = pd.Period(f"{year}-03", "M"), [pd.Period(f"{year}-01", "M"), pd.Period(f"{year}-02", "M")]
    if march in idx:
        returns.loc[march] += 0.05 * news                                 # the price reacts to the news in the filing month
    for p in early:
        if p in idx:
            book_new.loc[p] = book_old.loc[p] * np.exp(0.8 * news)        # look-ahead: the new book value is used before it is public
groups = pd.Series(["A"] * 100 + ["B"] * 100, index=cols)
label = lead_return(returns, 1)
ic_pit = ic_series(group_percentile(book_to_market(book_old, cap), groups), label)["ic"].dropna()
ic_look = ic_series(group_percentile(book_to_market(book_new, cap), groups), label)["ic"].dropna()
by_month = lambda s: s.groupby([p.month for p in s.index]).mean()
gap = by_month(ic_look) - by_month(ic_pit)
assert gap[2] > 0.15 and gap[2] == gap.max()                              # Feb signals predict the March filing reaction
assert np.allclose(gap.drop([1, 2]), 0.0)                                 # months with identical books give identical IC
print(gap.round(3).to_dict())
代码段五:用 positive_denominator_ratio 检验方向与输入校验。
import numpy as np
import pandas as pd
import pytest

from quant_course.factor_signals import cheapness_percentile, positive_denominator_ratio

idx = pd.period_range("2026-06", periods=1, freq="M")
yields = pd.DataFrame([[0.05, 0.08, 0.02, np.nan]], index=idx, columns=list("abcd"))
multiples = pd.DataFrame([[10.0, 6.0, 20.0, np.nan]], index=idx, columns=list("abcd"))
np.testing.assert_allclose(cheapness_percentile(yields, kind="yield").iloc[0, :3], [0.5, 1.0, 0.0])
np.testing.assert_allclose(cheapness_percentile(multiples, kind="multiple").iloc[0, :3], [0.5, 1.0, 0.0])
with pytest.raises(ValueError):
    positive_denominator_ratio(yields, yields.rename(columns={"d": "z"}))               # labels must match
with pytest.raises(ValueError):
    positive_denominator_ratio(yields.where(yields < 1, np.inf), yields)                # infinity is rejected, NaN is the only missing marker
print("ok")
10. 图形解读
图 24-1:行业水平与 IC 的稀释。 构造面板 300 家公司(制造与银行各 150)、108 个月,固定种子 20261031。左图是 2015-01 月末每家公司的
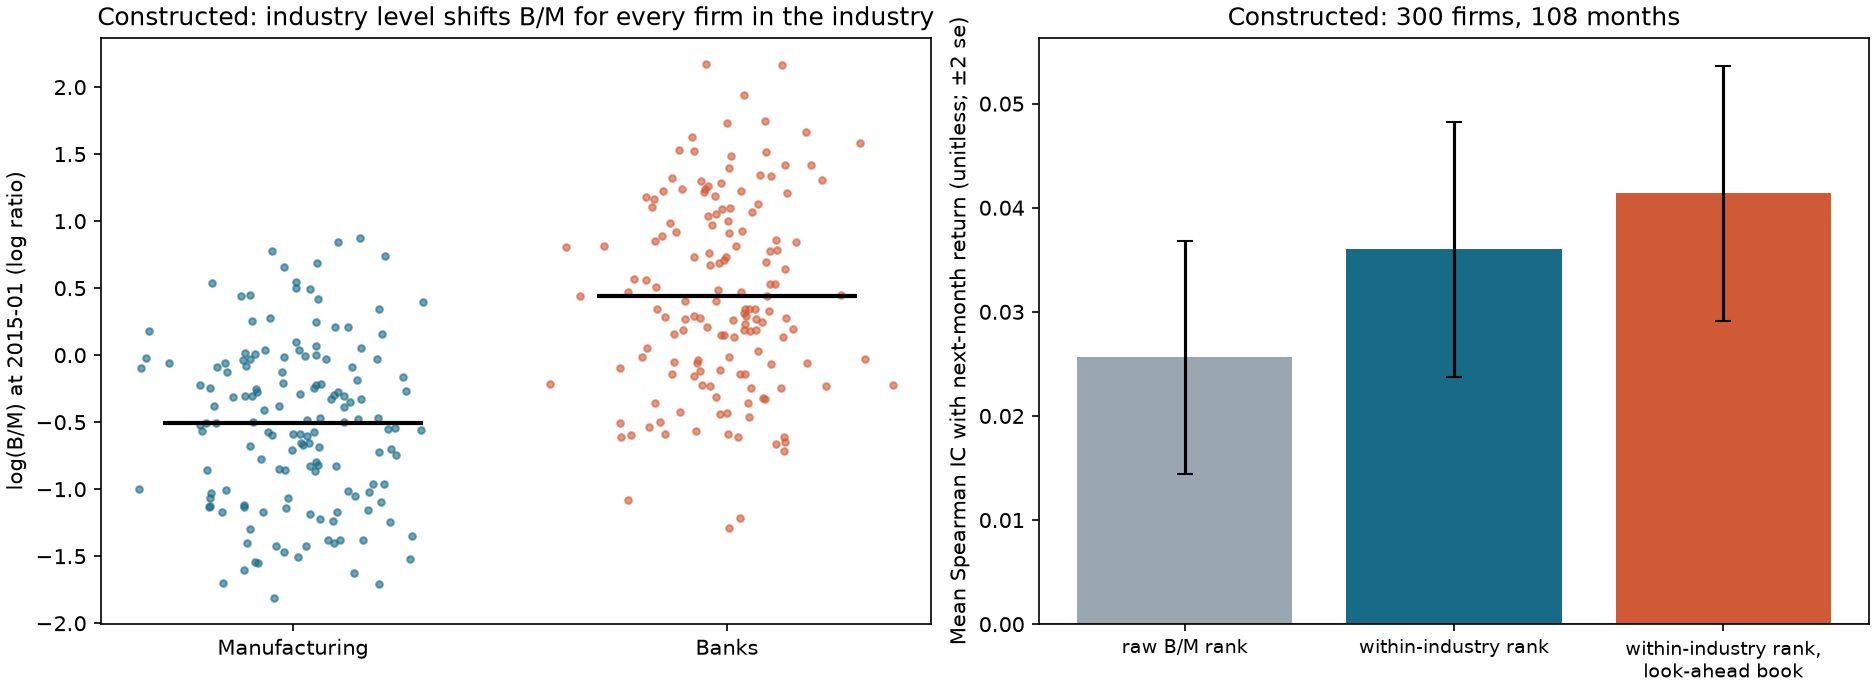
图 24-2:前视的日历信号月 IC 诊断。 横轴是信号月的日历月(1 月至 12 月),纵轴是该日历月全部信号的平均 IC。蓝色是时点账面值,橙色是前视账面值。两者只在 1、2、3 月不同(构造里备案落在 2 月底至 4 月下旬):2 月 0.0186 对 0.0557,3 月 0.0533 对 0.0729;4 月起完全重合。读法:前视不是对所有月份均匀地加一点,而集中在“财年已结束、年报未发布”的月份,所以按日历月拆分 IC 是识别可得时间问题的低成本检验。
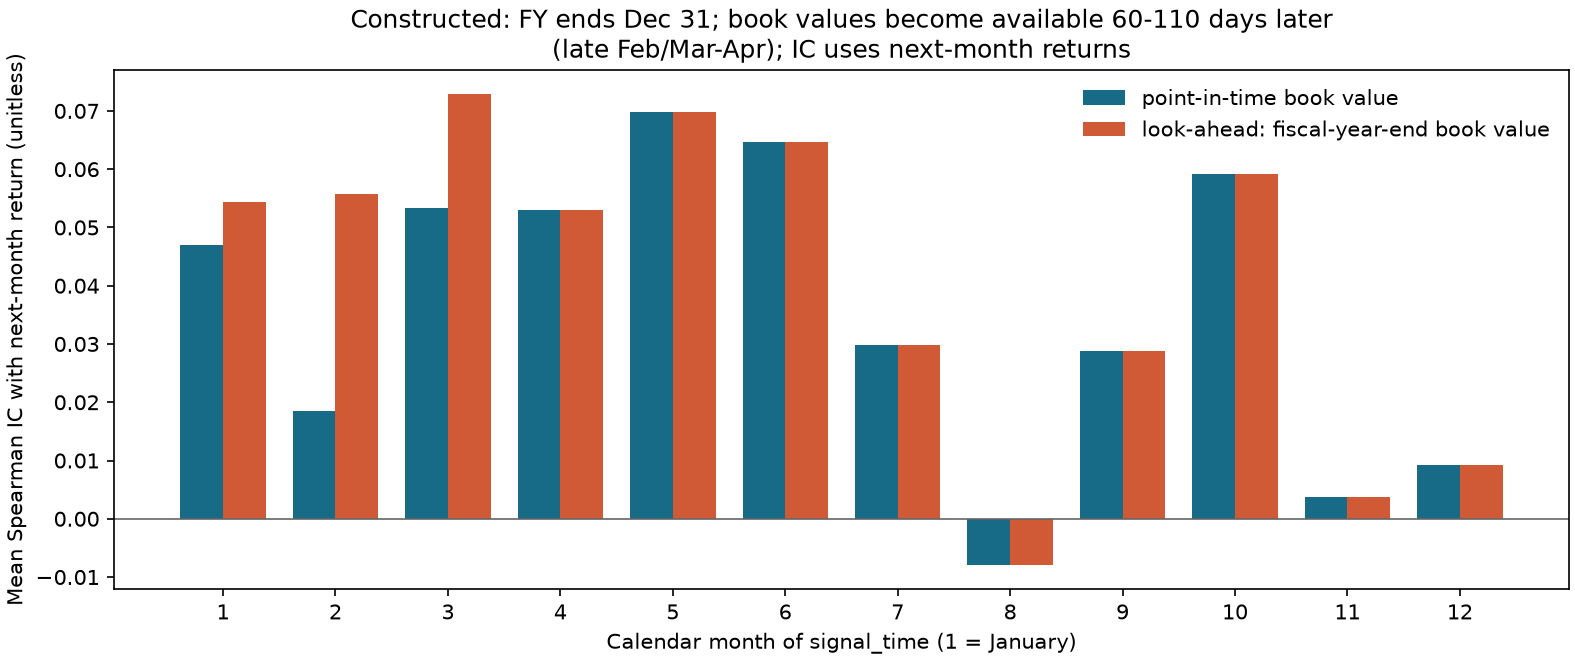
图 24-3:十分位收益与价值陷阱。 左图是行业内百分位十分位的等权下月平均收益(% 每月,10 为最便宜):总体上升,从 0.089 到 1.058(第 3 桶 0.514 低于第 2 桶 0.583,第 5、6 桶略低于第 4 桶,不是严格单调)。右图是每个十分位里陷阱公司的占比:最便宜的十分位里 44.7% 是陷阱(总体占比 9.7%,虚线),最贵的七个十分位几乎没有。读法:陷阱因价格已下跌而 B/M 高,会聚集在“最便宜”的一端,拉低该桶的平均收益。构造数据。
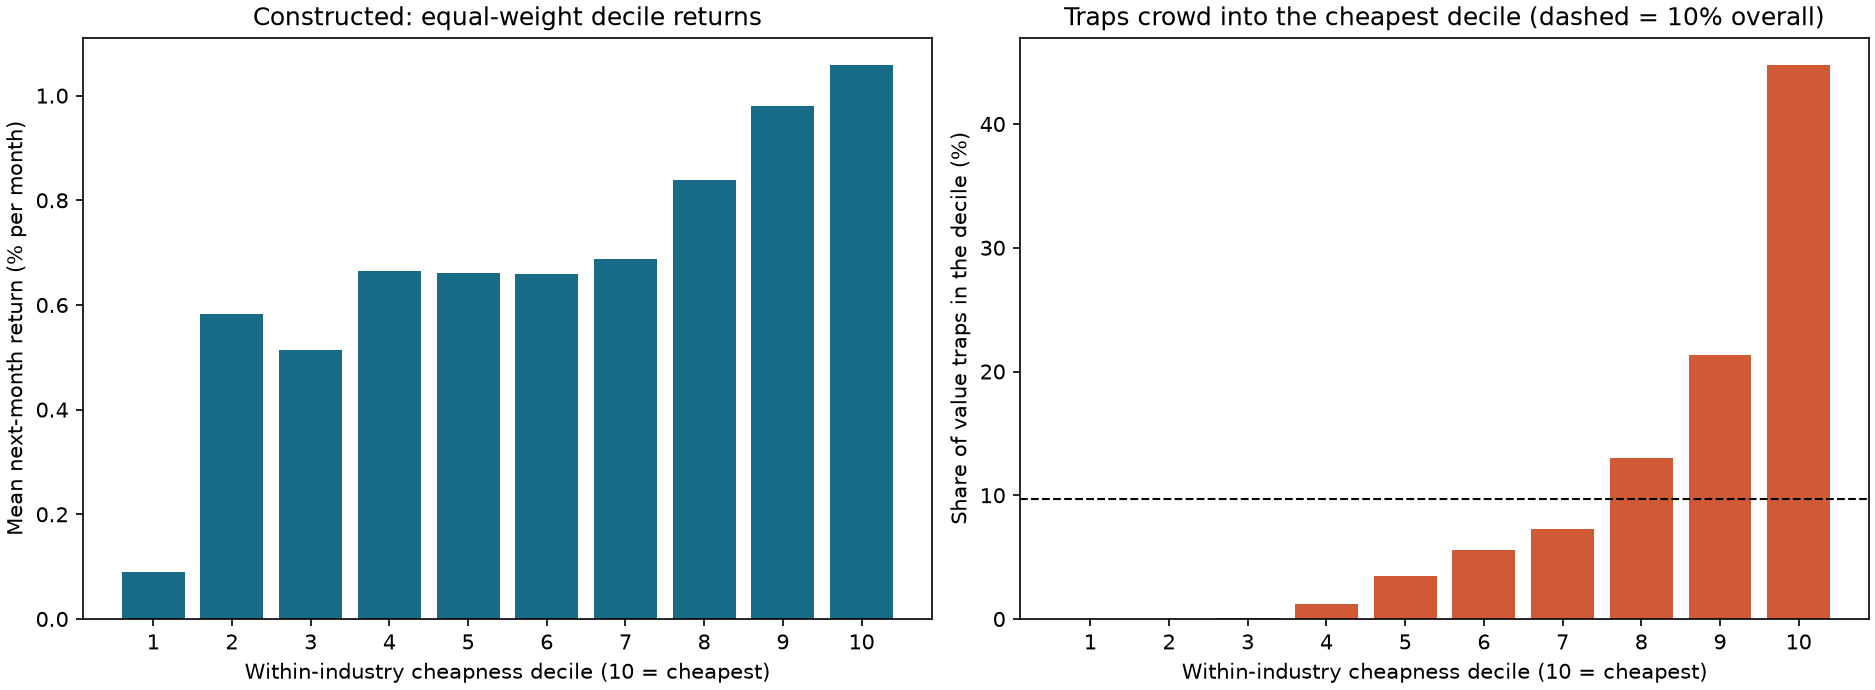
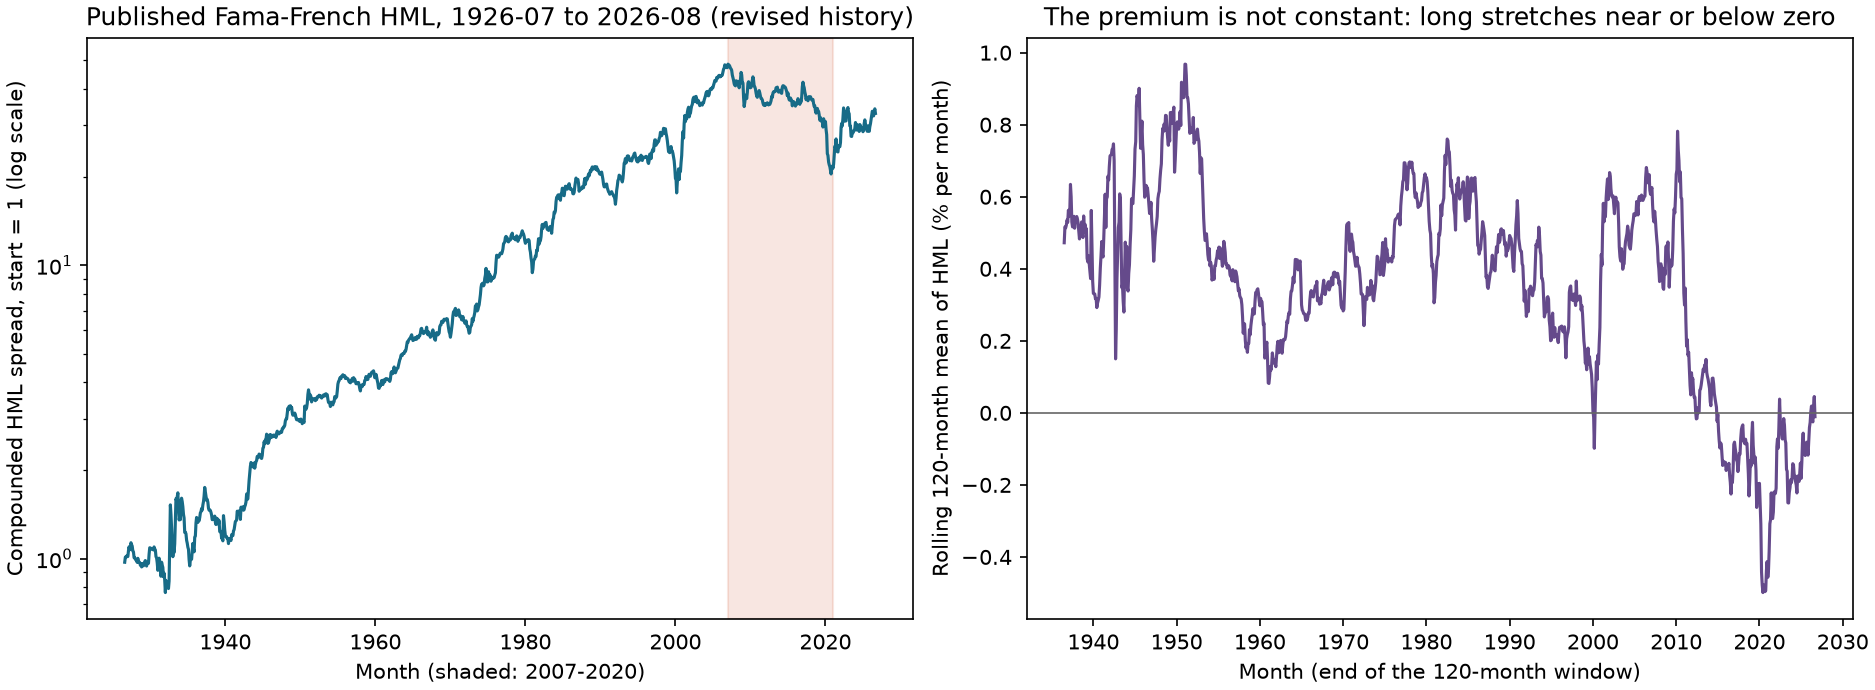
图 24-4:已发布的 HML。 左图是 HML 月度价差复利后的累计值(对数纵轴,起点为 1,样本 1926-07 至 2026-08),阴影是 2007–2020。右图是滚动 120 个月平均 HML(% 每月)。读法:长期向上,但在 2007 年之后出现约 14 年的下行,滚动均值一度约
11. 历史市场案例
数据与限制。 使用 2026-10-05 冻结的 French 三因子月度数据:Ken French 数据库 F-F Research Data Factors,处理后 CSV SHA-256 c19770a19a0ac47ad1c29074f57234570aeaa9725212cb4fa8146a2846c52814,1,202 个月(1926-07 至 2026-08),单位小数月度价差收益,数据库 2026-08 之前的内容随 CRSP 更新而修订;公开可下载不等于可任意再分发。HML 的构造见 6.7 节与来源笔记:按 t−1 财年账面权益、t−1 年 12 月市值、7 月形成并持有至次年 6 月,只含账面权益为正的公司。它是已发布的聚合收益,不是逐股 B/M 信号,不是时点版本,不是可交易成交。
描述性结果。 全样本 1,202 个月:HML 平均 0.352% 每月(标准差 3.55%,
| 期间 | 月数 | 平均(% 每月) | 标准差(% 每月) | |
|---|---|---|---|---|
| 1926-07 至 1963-06 | 444 | 0.450 | 2.17 | 4.37 |
| 1963-07 至 1999-12 | 438 | 0.349 | 2.83 | 2.58 |
| 2000-01 至 2026-08 | 320 | 0.218 | 1.14 | 3.43 |
| 2007-01 至 2020-12 | 168 | 2.88 |
复利累计后最大回撤 57.8%,发生在 2020-09。与市场超额收益的相关系数 0.22,与 SMB 的相关系数 0.13。
能说什么,不能说什么。 可以说:已发布的价值价差在 1926–2026 的均值显著为正,在 2007–2020 为负,分期的均值与波动都变化很大。不能说:(1)逐股 B/M 信号在这些年有效或失效,HML 是 6 个价值加权组合的算术组合,不是任何单一 B/M 排序的收益;(2)某只公司因 B/M 高而会涨;(3)Fama–French(2015)关于 HML 在五因子模型里多余的结论适用于 1926–1963 或国际数据,原文限定为美国 1963–2013。
逐股价值研究需要的数据,目前没有。 逐股时点价值研究至少需要:每家公司的财报版本与 available_at;每个信号月的价格、股数与市值;历史股票池(含退市)与退市收益;行业分类的历史版本。按2026-10-06来源笔记的当时读取记录,美国证券交易委员会(SEC)“财务报表数据集”提供 2009 年 1 月至 2026 年 6 月 XBRL 财报的“as filed”数值,带 filed 与 accepted(受理日期时间)字段,免费并可再分发(需注明来源;访问有速率限制与声明 User-Agent 的要求),但没有价格、股数、股票池与退市收益;prevrpt 只标记某次提交后来被修订,不给出完整的重述链。所以仅凭它无法完成逐股价值研究,且 2009 年之前没有 XBRL。本章没有下载这些数据,Project 4 准备层的缺口表(projects/project04/preparation/)逐项列出缺什么。
12. 常见错误
错误 1:全市场排序混入行业。 8.2 节:全市场前三名是 Harbor、Forge、Summit,其中两家银行;构造面板里全市场 IC 0.0256,行业内 0.0360。修复:同日行业内百分位,并报告被剔除的小行业。
错误 2:FCFF 除以市值。 8.5 节:Lyra 的 FCFF 收益率从 5.33% 变成 8.33%,与 Orion 的排序反转。修复:匹配口径,FCFF 对 EV,FCFE 对市值。
import pandas as pd

from quant_course.factor_signals import yield_ratio

idx = pd.period_range("2026-06", periods=1, freq="M")
cols = ["Orion", "Lyra"]
fcff = pd.DataFrame([[40.0, 40.0]], index=idx, columns=cols)
cap = pd.DataFrame([[600.0, 480.0]], index=idx, columns=cols)
ev = pd.DataFrame([[650.0, 750.0]], index=idx, columns=cols)
right, wrong = yield_ratio(fcff, ev).iloc[0], yield_ratio(fcff, cap).iloc[0]
assert right["Orion"] > right["Lyra"] and wrong["Lyra"] > wrong["Orion"]                      # the ranking reverses
assert abs(wrong["Lyra"] / right["Lyra"] - 750 / 480) < 1e-12
print(right.round(4).to_dict(), wrong.round(4).to_dict())
错误 3:负数被取绝对值或置零。 对负盈利取绝对值会把亏损公司变成“便宜”的公司;置零会把它们放到中间。修复:收益率保留符号,倍数形式置 NaN,并报告缺失比例。
import numpy as np
import pandas as pd

from quant_course.factor_research import factor_rank

idx = pd.period_range("2026-06", periods=1, freq="M")
pe = pd.DataFrame([[12.0, 8.0, -20.0, 15.0]], index=idx, columns=list("abcd"))       # firm c has negative earnings: P/E = -20
naive = factor_rank(-pe).iloc[0]                       # cheapest = smallest P/E: the loss-maker looks cheapest
fixed = factor_rank(-pe.where(pe > 0)).iloc[0]         # non-positive P/E is missing
assert naive["c"] == 1.0 and np.isnan(fixed["c"]) and fixed["b"] == 1.0
print(naive.round(2).to_dict(), fixed.round(2).to_dict())
错误 4:用报告期末当可得日。 8.4 节:用 period_end,2023-01 末就会用到 3 月才发布的 FY2022。修复:始终用 available_at 与 ingested_at,并用 latest_available_values。图 24-2 的日历月诊断可以发现它。
错误 5:用当前重述值回填历史。 8.4 节:2023-03 末会用到 11 月才发布的 90。修复:版本表保留所有版本;没有版本历史就不能做时点研究,应标明用途为教学。
错误 6:把“便宜”读成“会涨”。 构造面板最便宜十分位里 44.7% 是陷阱;若不识别陷阱,价值多空的最便宜一腿被拖累(1.058% 对 1.361%)。修复:与第26章质量指标和第28章因子合成配合;价值信号单独回测要报告陷阱占比或杠杆、现金流符号等可观测代理。
错误 7:把 HML 的结论搬到个股。 第 11 节。HML 是 6 个价值加权组合的算术差;价值加权使大盘股占主导;个股 B/M 的等权十分位多空可以完全不同。
13. 量化研究应用
Project 4 的价值字段契约。 任何价值信号都要有一张字段表。示例(完整表见 projects/project04/preparation/):
| 字段 | 来源 | 时间字段 | 单位 | 缺失规则 |
|---|---|---|---|---|
book_equity |
财报 | period_end、available_at、ingested_at |
报告货币 | 非正为 NaN 并写原因 |
market_cap |
价格×股数 | 月末 signal_time |
报告货币 | 非正为 NaN |
industry |
分类版本 | available_at |
标签 | 缺失为 NaN |
ratio_bm |
计算 | signal_time |
无量纲 | 同 book_equity 与 market_cap |
label_1m |
下月收益 | 标签区间起止 | 小数 | 缺失为 NaN |
研究流程(构造面板的复现,第 22 章的账本约束同样适用)。 先写冻结计划:假设“同日行业内 B/M 更高的公司下月收益更高”,信号为行业内百分位,标签下一月收益,主指标 Rank IC 的
对 Project 4 的约束。 (1) 价值字段先通过 latest_available_values 或第3章的 pit_asof_join,没有版本表就标“教学构造”;(2) 缺失规则与被剔除比例写入配置;(3) 行业内排序与全市场排序同时报告;(4) 前视与日历月 IC 作为数据审计的一部分;(5) 价值陷阱用可观测代理报告;(6) 所有变体进第 22 章账本。完整 Project 4 在第 29–36 章之后才能完成,本章只完成信号层的字段与规则。
13.1 当前七字段接口:本章变量如何进入 Project 4
当前 signal_contract.json 是 p04-prep-0.2;通用预处理规则是 frozen_rules.json 的 p04-prep-0.1,两个文件职责不同。七字段为价值三项 book_to_market、earnings_yield、ev_to_ebitda_cheapness,动量一项 mom_12_1,质量三项 gp_a、neg_accrual、roe_avg。FCF Yield 是本章教材变量,当前七字段没有实现它;OP 同样不是本层信号。
构造宇宙的 EV 只算 market_cap + debt - cash,契约明确将少数权益、优先股、非经营资产设零。这是构造假设,不能把真实公司的缺字段当零;真实使用须取得完整 PIT 桥项、统一币种尺度并核对完整桥。旧机器契约澄清已关闭,见 qa/a5/codex_followup_fixes/acceptance.md;本次只把已关闭边界教清楚。
三章共用一次以下接口表。信号层中性化与持仓层投影分开:前者改变信号,后者改变权重,前者不能保证后者可交易或中性。
| 层次 | 当前动作 | 读者要核的条件 |
|---|---|---|
| 原始七字段 | 按各自公式计算;EV 倍数转为越大越便宜的反向百分位 | 合法分母、完整PIT字段;不是先把所有缺失置零 |
| 同日缩尾 | 每字段 1%/99% 分位缩尾,至少30个有效名字 | 改变极端量级,不创造缺失观测 |
| 同日残差化 | 对行业虚拟变量及 log 市值 OLS,取残差 | 控制暴露的经济含义与样本覆盖 |
| 同日标准化 | z 分数,样本标准差 ddof=1,至少10个有效名字 | 原始EV方向转换与此标准化是两步 |
| 风格内合成 | 有效字段等权、重新归一,至少1字段 | 只有1字段的公司与3字段公司证据量不同 |
| 风格间合成 | 有效风格等权、重新归一,至少2风格 | 未满足门槛保持缺失,报告覆盖损失 |
| 可选持仓 | 五分位多空;可选行业权重投影 | 当前C13已修listed支持集/gross2/60名门槛;真实交易资格及执行后残差仍须分别核验 |
小表读法:同日缩尾、中性化和标准化后,某公司三项价值 z 为
旧A6记录曾指出全列行业投影给未上市列非零权重、事后清零又损害中性。当前C13已限定接受listed支持集投影(可含无alpha的上市对冲坐标)、gross恢复2及60名信号listed门槛,执行取消和收盘漂移残差另报,见当前组合支持集接口。真实交易资格、借券、成本、容量与完整真实P4仍未完成;旧Notebook和A5/A6输出保持历史身份,不据源码修正声称已重跑。通用 IC 与时间推断引用第23章,试验预算引用第22章。
14. 本章小结
价值信号是一个会计量除以价格量、再统一方向并在同日同类里排序的过程。分母必须为正且口径匹配,否则会产生假便宜:负账面权益、非正 EBITDA、FCFF 除以市值。行业水平不是个股信息:银行与软件公司的 B/M 在不同的水平上,同日行业内百分位把行业拿掉。信号的每个数字都要有 available_at:以报告期末或当前重述值代替,在本章指定构造中使部分信号月IC较高;方向并非一般保证,更高表现同样须核可得时点。价值陷阱是“便宜”不成立的那部分,会聚集在最便宜的十分位。已发布的 HML 是 6 个价值加权组合的算术差,长期均值为正,2007–2020 为负;它描述聚合收益,不检验逐股信号。适用边界:构造面板是机制演示;HML 是修订历史;本章没有逐股时点数据,Project 4 的数据缺口需要用户决定是否补充。
15. 练习
24-E01(概念) 为什么对正数
24-E02(手算) 某公司价格 40,股数 25(百万),普通股账面权益 700,归属普通股的净利润 80,FCFE 60,债务 500,现金 100,少数股东权益 50,优先股 0,非经营性资产 30,EBITDA 200,FCFF 90(单位百万美元)。计算企业价值、B/M、E/P、FCFE 收益率、FCFF/EV、EV/EBITDA,以及错配的 FCFF/市值和它相对正确值的放大倍数。
24-E03(手算) 某日行业 A 有四家公司 B/M
24-E04(手算) 证券 S2 的版本:FY2020,账面权益 50,2021-03-01 16:00 可得、同日 16:10 入库;FY2021,55,2022-02-20 16:00 可得、16:10 入库;FY2021 重述,48,2022-10-05 16:00 可得、2022-10-07 09:00 入库;FY2022,70,2023-03-10 16:00 可得、2023-04-03 09:00 入库(全部 UTC)。写出 2022-02、2022-09、2022-10、2023-03、2023-04 月末信号使用的账面权益及理由。
24-E05(手算) 四个价值加权组合收益:小盘价值 1.4%,大盘价值 0.8%,小盘成长 0.4%,大盘成长 0.6%。计算 HML,并说明只用大盘与用四个组合的区别。
24-E06(推导与计算) 推出
24-E07(计算) 两个等权行业,行业水平差
24-E08(计算) 最便宜的十分位含陷阱占比 44.7%,平均月收益含陷阱 1.058%、去掉陷阱 1.361%,求陷阱公司的平均月收益。若研究者无法识别陷阱,应如何报告?
24-N01(索取权与机制) 用第3.1节输入逐项重算完整EV、FCFE、两种正确yield及错配yield;再解释净现金反例为什么不能用“EV总比市值大”。列一个风险补偿检验与一个代理测量检验,指出正IC为什么不能区分它们。
16. 编程练习
24-P01 在一个含5家公司、每家3个财报版本(首次FY2021、FY2021重述、晚入库FY2022)的版本表上,用 latest_available_values 得到 8 个月的账本权益表;断言:重述不回填、晚入库推迟一个月、加入未来版本不改变过去。验收:三条断言通过。
24-P02 在构造面板(可调用 code/ch24_value_factors.py 的 value_world)上计算行业内 B/M 的 Rank IC 与全市场 B/M 的 Rank IC,验证前者更大;改变行业水平差 log_bm0 中银行的均值)观察全市场 IC 如何下降。验收:解释第6.3节总体 Pearson 衰减因子的方向,并报告固定生成机制/种子下各
24-P03 实现“日历月 IC 诊断”:给定信号表与下月标签,返回 12 个日历月的平均 IC;在含前视的构造数据上检出异常月份(与时点版本比较差值最大的月份是备案前一月)。验收:检出的月份包含 2 月。
17. 挑战题
24-C01(推导) 设两个公司的收益率
24-C02(开放) 为第26章质量指标与本章价值信号共同设计 Project 4 的字段契约与时间图:列出每个字段、来源、period_end、available_at、ingested_at、单位、缺失规则,画出一条时间线说明信号月、备案、重述和标签区间的先后;指出缺什么数据才能完成逐股研究。评分:字段完整性 25,时间线正确 30,缺失规则与偏差说明 25,数据缺口 20。
18. 完整答案与参考实现
24-E01 设
24-E02 市值
24-E03 全市场 7 个值升序
24-E04 2022-02 末:FY2021 于 2022-02-20 发布并入库,已知,值 55。2022-09 末:重述(10-05)尚未发布,值 55。2022-10 末:重述 10-05 可得、10-07 入库,均在 10 月 31 日之前,取 FY2021 的最晚版本,值 48。2023-03 末:FY2022 在 03-10 可得,但 04-03 才入库,3 月 31 日本地系统不知道,取 48。2023-04 末:已入库,FY2022 期间最新,值 70。理由:已知集合要求 available_at 与 ingested_at 都不晚于截止,再取最新报告期、最晚版本。
24-E05
24-E06 由
24-E07 衰减因子
24-E08 反解:
24-P01 参考实现
三个版本是每家公司的版本数,完整输入15行;月份为2022-08至2023-03,共8个月。
import numpy as np
import pandas as pd

from quant_course.factor_signals import latest_available_values

# Five companies; each has three filing versions before any future test row is added.
base = {f"S{i}": 60.0 + 20.0 * i for i in range(1, 6)}
rows = []
for sec, value in base.items():
    for period, available, ingested, book in [
        ("2021-12-31", "2022-03-15 16:00", "2022-03-15 16:10", value),
        ("2021-12-31", "2022-10-05 16:00", "2022-10-07 09:00", value - 10),
        ("2022-12-31", "2023-02-20 16:00", "2023-03-02 09:00", value + 40),
    ]:
        rows.append({"security_id": sec, "period_end": pd.Timestamp(period),
                     "available_at": pd.Timestamp(available, tz="UTC"),
                     "ingested_at": pd.Timestamp(ingested, tz="UTC"), "book_equity": book})
versions = pd.DataFrame(rows)
months = pd.period_range("2022-08", periods=8, freq="M")
table = latest_available_values(versions, months, ["book_equity"])["book_equity"]
# Restatement becomes known in October, never backfilled into August or September.
assert table.shape == (8, 5) and all(table.loc["2022-09", s] == v and table.loc["2022-10", s] == v - 10 for s, v in base.items())
# The February filing is ingested in March: February retains the old value.
assert all(table.loc["2023-02", s] == v - 10 and table.loc["2023-03", s] == v + 40 for s, v in base.items())
# Add one later version per company only for the causality check.
future = versions.groupby("security_id", sort=True).tail(1).copy()
future["period_end"] = pd.Timestamp("2024-12-31")
future["available_at"] = pd.Timestamp("2025-03-01", tz="UTC")
future["ingested_at"] = pd.Timestamp("2025-03-02", tz="UTC")
future["book_equity"] = 999.0
pd.testing.assert_frame_equal(table, latest_available_values(pd.concat([versions, future], ignore_index=True), months, ["book_equity"])["book_equity"])
print(table.to_string())
print("PASS: 5 companies, 3 versions each, 8 months; restatement, late ingestion, future invariance")
24-P02 参考实现
import importlib.util
from pathlib import Path

import numpy as np

from quant_course.factor_research import group_percentile, ic_series, lead_return
from quant_course.factor_signals import book_to_market, cheapness_percentile

root = Path.cwd()
spec = importlib.util.spec_from_file_location("ch24", root / "code/ch24_value_factors.py")
ch24 = importlib.util.module_from_spec(spec); spec.loader.exec_module(ch24)
world = ch24.value_world(seed=7, n_firms=200, months=60)                                    # smaller world for speed
bm = book_to_market(world["pit_book"], world["cap"])
label = lead_return(world["returns"], 1)
raw = ic_series(cheapness_percentile(bm, kind="yield"), label)["ic"].mean()
inside = ic_series(group_percentile(bm, world["industry"]), label)["ic"].mean()
assert inside > raw > 0                                                                      # industry-relative beats raw
print(round(raw, 4), round(inside, 4))
改变行业水平差 value_world,把 np.where(industry == "Bank", -0.1, -1.0) 里的 -0.1 改成 -1.0 + delta,对
24-P03 参考实现:本章第 9 节代码段四。把 gap 改写成函数,输入两张信号表,输出 12 个日历月的 IC 差;检出 gap.idxmax()==2。
24-C01
24-C02(评分依据与参考) 字段示例:book_equity(period_end,available_at = 提交受理时间,ingested_at,报告货币),market_cap(月末价格×股数,价格来源需有时点),ebitda、ev_bridge(桥项各自的时点),industry(分类的历史版本),cfo、net_income(质量指标,同表同版本)。时间线:财年末 → 受理(available_at)→ 本地入库 → 信号月末 → 下月成交 → 标签区间 → 可能的重述。数据缺口:价格与股数、历史股票池与退市收益、行业分类历史、2009 年之前的 XBRL、重述链;SEC 数据集覆盖 2009–2026-06 的 as-filed 财务数值但不含价格。缺失规则:负账面权益、非正 EBITDA 置 NaN 并统计比例。评分按原稿四项。
24-N01完整答案。 EV为700百万欧元;FCFE为48;FCFF/EV与FCFE/M各8%;错配FCFF/M为9.333%,是正确公司口径的1.1667倍。净现金公司的EV为40,低于市值100,正确20%与错配8%相反地表现为压低。风险检验可事前比较坏状态损失和收益补偿;代理检验可比较行业/规模控制前后同一信号关联并报告覆盖。两者均须冻结口径和留出期;正IC只显示样本关联,风险、误定价与测量代理都可能产生它。
19. 延伸阅读
- Must Know:Ken French 数据库“Description of Fama/French Factors”页,读 Construction 与 Stocks 两段,理解 HML 的组合算术和账面值的时点。
- Must Know:Asness–Moskowitz–Pedersen(2013)“Value and Momentum Everywhere”印刷页 936–937,读价值度量与账面值滞后 6 个月的说明;第25章再读动量部分。
- Should Know:Fama–French(2015)第 7 节“HML: a redundant factor”,读它限定的样本与模型。
- Should Know:SEC “Financial Statement Data Sets” 的数据说明,读
filed、accepted、prevrpt字段及“as filed”的限制。 - Advanced:Fama–French(1992、1993)与 Lakonishok–Shleifer–Vishny(1994)原文,核对价值度量的最初设计;本章未读这些文献。
- Optional:第13章估值章节中关于 EV 桥与 FCFE/FCFF 的推导。
20. 参考资料
引用键与读取范围见 source_notes.md。
- CH24_FF_FACTORS_PAGE:Kenneth R. French Data Library,“Description of Fama/French Factors”。支持 HML 算术与 t−1 财年、正账面权益、7 月形成。
- CH24_FF5_PAGE:同库“Description of Fama/French 5 Factors (2x3)”。
- CH24_AMP2013:Asness, C. S., Moskowitz, T. J., Pedersen, L. H. (2013). “Value and Momentum Everywhere.” Journal of Finance 68(3),印刷页 936–937。
- CH24_FF2015:Fama, E. F., French, K. R. (2015). “A five-factor asset pricing model.” Journal of Financial Economics 116(1),摘要、第 7 节(页 12–13)、表 8 说明(页 14)。
- CH24_SEC_FSDS:SEC DERA Financial Statement Data Sets 页面与数据说明;SEC Accessing EDGAR Data;SEC 网站信息政策。
- FRENCH:French 三因子冻结快照(
data/manifests/french_factors_2026-10-05.json)。