第 15 章/ 45
因子模型(Factor Models)
先修:第8章回归、第11章收益、第12–13章财报与估值、第14章资产定价。
1. 本章目标
本章要解决一个具体问题:某组合比现金多赚的钱,究竟是市场及其他共同风险的补偿,还是在所选模型下尚未被解释的部分?你将从资本资产定价模型(Capital Asset Pricing Model, CAPM)走到 Fama–French 三因子模型(Fama–French Three-Factor Model, FF3)与五因子模型(Fama–French Five-Factor Model, FF5),读懂规模、价值、盈利与投资因子的构造,独立完成实际月频回归。
学完应能区分因子(factor)、因子载荷(factor loading)、因子暴露(factor exposure)、截距阿尔法(alpha)和残差风险(residual risk);能逐步推导遗漏变量为何改变 alpha,判断风险分解的假设,并解释为什么显著的回归结果仍不是可交易净利润。我们使用真实 Kenneth French 行业组合与因子快照,不编造股票交易记录。
2. 为什么 Quant 需要它
研究员找到一个历史表现不错的股票组合,第一步不应是给它取一个响亮策略名。组合可能恰好持有高市场 beta 的股票,可能只是长期偏小盘,也可能承担某种价值或盈利风格风险。若不建立比较基准,就会把已有的风险补偿重复命名为独家能力。
第13章解释了“便宜”的特征怎样从同索取权的财报与价格构造出来;本章进一步问:持有这种特征的组合,与市场或别的风格一起涨跌多少?两者分工不同。特征用于描述公司,因子收益序列用于描述组合共同波动;后续第23–28章才会把特征变成实时可用信号。本章负责风险解释与归因,不把同月已发生因子收益当成事前预测输入。
模型也能服务风险管理。基金看起来持有很多股票,如果它们都暴露于相同因子,名字多不等于风险分散。模型给组合构建一个低维坐标系;第20–21章会利用这个坐标系计算风险和约束,最后还须接受数据、样本外表现及交易成本的检验。
3. 直觉
把组合收益想成一个乐队的合奏:市场是一条大多数股票都会响应的旋律,其他因子刻画不同声部。载荷表示某个组合对各声部的响应强弱,不是这个声部的成交持仓份额。残差是本模型没解释的声音,可能有公司特有事件、测量误差、遗漏因子或随机噪声;把剩余声音称为“天才独奏”还太早。
为什么不只回归市场?两家公司可能市场敏感度相近,却因融资条件、估值、盈利能力或再投资模式不同而出现持续共同波动。加入一个因子的目的,是检验这种共同变化能否解释原先留在残差里的部分。若加入一个因子只是在历史上凑巧把线画得更漂亮,模型并没有因此获得未来有效性的证据。
也不要把“价值因子上涨”读成“低市盈率公司必涨”。因子是按一定规则形成的组合收益差,跨期可以为正或负;一个股票的财报特征、回归暴露和次月收益之间都没有机械恒等式。
4. 数学基础
4.1 从一个资产到 N 个资产
对资产 i 在月 t 的简单总收益,写成:
对 N 个资产同时写:
4.2 期望与波动回答不同问题
在本节固定载荷、固定截距且二阶矩存在的模型中,若残差总体均值为零,则:
波动关注偏离均值的变化,常数 alpha 不产生方差。若因子与残差不相关:
一般情况令
5. 正式定义
5.1 CAPM、FF3 与 FF5 的关系
CAPM 时间序列回归以市场超额收益为唯一右侧因子:
FF3 加入规模与价值风格的组合收益差:
FF5 再加入稳健盈利减弱盈利(Robust Minus Weak, RMW)与保守投资减激进投资(Conservative Minus Aggressive, CMA):
5.2 从特征分组得到因子收益
为了避免“价值端只是小盘更多”的混淆,先按规模分成 Small/Big,再按账面市值比把每个规模组分成 Value/Neutral/Growth。记六个组合月收益为 SV、SN、SG、BV、BN、BG。它们是各组内按市值加权的组合收益;外层合成采用下述等权。
每个字母代表同一个月的小数收益;上式不是把六个公司的财报数值相减,而是把六个组合的收益相减。规模因子跨价值分组平均,价值因子跨规模分组平均;目的在于降低另一个分组特征的混杂,不保证完全统计正交。组内权重与组间权重不同,这也是复制官方因子时必须分层记录的原因。French 三因子官方构造说明
盈利组记为 Robust/Neutral/Weak,投资组记为 Conservative/Neutral/Aggressive。分别形成两种规模收益差
三项都是小盘减大盘的月收益差。再记 SR、BR、SW、BW 为小/大盘的稳健/弱盈利组,SC、BC、SA、BA 为小/大盘的保守/激进投资组,则:
各组合保持月收益单位,分母 2 或 3 是等权平均的无量纲计数。这里理解构造,不声称本章用逐股财报和历史股票池复制了这些组合。本章直接读取官方发布的因子收益。官方年度分组使用滞后的财报资格,并按 July–June 持有期构造;这和拿今天数据库里的所有重述值回填过去并不等价。French 五因子官方说明
5.3 因子收益、特征、载荷与持仓
| 对象 | 输入 → 操作 → 输出 | 单位与可得时钟 |
|---|---|---|
| 单股票财报特征(characteristic) | 已公开同口径账面权益、市值 → 比值 → 账面市值比0.6 | 无量纲;核公开/入库和价格时点 |
| 分组组合(sorted portfolio) | 截止时已知特征、合格股票池 → 分组及组内权重 → SV等组合的月收益 | 小数/月;先定分组与持仓,再等收益实现 |
| 因子收益(factor return) | 各组同月收益 → 高减低/小减大 → HML等收益差 | 小数/月;整月实现并发布后才可读 |
| 回归载荷(factor loading) | 已实现资产超额收益和同月因子 → 指定窗口OLS → h=0.8 | 无量纲;训练窗截止后估出 |
| 持仓权重(position weight) | 可读信号、风险预算和约束 → 组合决策 → 股票占NAV的4% | 无量纲;决策与实际成交分别登记 |
资产净值(Net Asset Value, NAV)是权重分母。表中没有从载荷直接通往持仓的恒等箭头:得到权重还需目标、约束及成本。特征是构建分组的输入,分组收益是合成因子的输入,因子收益又是估计载荷的输入;回归不会倒推出你真实买过哪些股票。
暴露一词需要注明定义:它可以指回归 beta,也可以指持仓加权特征。前者按收益协动估计,后者按已知财报和持仓计算;两者可能相关,但不是同一数字。载荷不必在 0 与 1 之间,也不必加总为 1。加入高度相关因子后单项载荷会不稳定,即使总拟合仍相近。
6. 推导
6.1 为什么拟合后的截距可能下降
先用一个因子 x 和一个遗漏因子 z 演示。设真实统计关系为:
x、z、y 是同月收益变量;alpha 是截距;beta、gamma 是载荷;u 为零均值误差。若只回归 x,线性投影斜率为:
第一步是带截距单因子 OLS 的总体投影公式;第二步把 y 的分解代入协方差,常数协方差为零,且 Cov(x,u)=0。令
截距必须让拟合均值等于 y 的均值,所以:
因此遗漏因子可能使截距升高或降低;加入 z 后 alpha 也可能上升。不能先把正截距当能力,再把截距消失解释成“模型消灭了赚钱能力”。改变的是比较基准与投影分解;投资者的实际现金流没有因研究员换模型而倒转。
6.2 多元 OLS 与载荷
有 T 个月,设计矩阵 X 为 T×(K+1):首列全为 1,其余列是当月因子收益;y 为 T×1 资产超额收益。求:
后一式要求 X 满列秩、T>K+1,因子不能是另一个因子的精确线性组合。实际软件宜用 QR 或 SVD 等稳定算法求解,不手工求逆。全秩使参数可以识别,不保证估计精确;近共线性仍会放大不确定性。第5章的秩、奇异值与第8章的回归在这里连接到风险解释。
正常方程给
6.3 风险分解为何成立、何时不成立
对单一资产,令
因为常数 alpha 不影响方差,先中心化 y,再展开平方期望得到上式。若 Cov(f,epsilon)=0,第三项为零,第一项展开为
在带截距的实际 OLS 样本中,拟合与残差正交,所以使用相同分母 T−1 的样本方差有:
三个 s² 都是按同样本和同一 T−1 算出的中心化样本方差。若要无偏估计回归噪声方差,可能改用残差平方和除以 T−K−1;这个分母不同,不能直接塞回上式。这一点能防止“统计软件 residual variance 与手算风险对不上”的误会。
对于固定权重 w 的组合,组合因子暴露为
w 是 N×1 权重;B、Sigma 的维度如第4节。式中第一项是共同因子风险,第二项是剩余风险,单位都是月收益平方。只对该固定权重、收益线性组合及正交假设成立;动态权重、融资、费用、期权非线性风险需要更完整的模型。
6.4 为什么标准误不能照搬独立样本公式
因子与残差可能存在序列依赖和异方差(heteroskedasticity)。OLS 点估计仍是平方误差极小值,但普通独立同方差标准误可能低估误差。本章采用异方差与自相关稳健协方差(Heteroskedasticity and Autocorrelation Consistent Covariance, HAC),对月度行滞后选 L=6,Bartlett 权重
令
V 是 (K+1)×(K+1) 参数协方差;其对角元素开方为标准误。加入滞后交叉积,是为了反映误差分数跨月一起变化;对远滞后降低权重,是为了限制有限样本噪声。本章软件另启用有限样本修正,并使用 t 参考分布;它是有条件的近似推断,不是“无论依赖多强都正确”。120 个月、6 阶滞后也不是通用最优配置,应对 3、6、12 阶做透明敏感性检查,不能按哪个 p 值最好看来挑 L。
为看清夹心项如何组成,先用本章 §8.4 的四个月构造回归做计算演示。下表只重列 HAC 所需的市场因子和 OLS 残差;完整资产超额收益及残差来源见本章 §8.4。回归含常数与一个因子,参数顺序为(alpha,beta);T=4、参数数 p=2。此处仅为公式教学而取 L=1,实际 French 案例仍按本章设定使用 L=6。
| 月 | 因子 x(小数/月) | OLS 残差(小数/月) |
|---|---|---|
| 1 | −0.020 | 0.001 |
| 2 | 0.000 | −0.001 |
| 3 | 0.020 | −0.001 |
| 4 | 0.040 | 0.001 |
设计列按(常数,x)排列,因此分数向量 q_t 是“设计向量 × 残差”。将四行写成矩阵:
按定义相乘,零阶和一阶分数交叉积为:
L=1 时 Bartlett 权重
本例的设计交叉积及其逆矩阵(参数顺序为常数、beta)是:
左右各乘一次后,未修正协方差和软件有限样本修正结果分别为:
这里 p=2 包含截距,故
以下代码独立重算每个矩阵,并与课程 helper 调用的 statsmodels HAC 标准误、t 值、p 值和区间作断言。矩阵求逆只为展示这个微型算例;实际回归仍由稳定的 OLS 实现完成。
from pathlib import Path
import sys
sys.path.insert(0, str(Path.cwd() / "src"))

import numpy as np
import pandas as pd
import statsmodels.api as sm
from quant_course.factor_models import fit_monthly_factor_model

x = np.array([-0.020, 0.000, 0.020, 0.040])
y = np.array([-0.013, 0.001, 0.017, 0.035])
design = np.column_stack([np.ones(len(x)), x])
params = np.linalg.lstsq(design, y, rcond=None)[0]
residual = y - design @ params
scores = design * residual[:, None]

gamma0 = scores.T @ scores
gamma1 = sum(
    np.outer(scores[t], scores[t - 1]) for t in range(1, len(scores))
)
weight1 = 1 - 1 / (1 + 1)
meat = gamma0 + weight1 * (gamma1 + gamma1.T)
bread = np.linalg.inv(design.T @ design)
raw_cov = bread @ meat @ bread
correction = len(y) / (len(y) - design.shape[1])
manual_cov = correction * raw_cov

np.testing.assert_allclose(params, [0.002, 0.8], atol=1e-14)
np.testing.assert_allclose(residual, [0.001, -0.001, -0.001, 0.001], atol=1e-14)
np.testing.assert_allclose(gamma0, [[4e-6, 4e-8], [4e-8, 2.4e-9]], atol=1e-20)
np.testing.assert_allclose(gamma1, [[-1e-6, 0], [-2e-8, -8e-10]], atol=1e-20)
np.testing.assert_allclose(
    manual_cov,
    [[4.4e-7, -6.5e-6], [-6.5e-6, 6.5e-4]],
    rtol=1e-12, atol=1e-18,
)

months = pd.period_range("2020-01", periods=4, freq="M", name="month")
factors = pd.DataFrame({"Mkt-RF": x, "RF": np.zeros(4)}, index=months)
fit = fit_monthly_factor_model(
    pd.Series(y, index=months), factors, ("Mkt-RF",), hac_maxlags=1
)
robust = sm.OLS(y, design).fit().get_robustcov_results(
    cov_type="HAC", maxlags=1, kernel="bartlett",
    use_correction=True, use_t=True,
)
np.testing.assert_allclose(robust.cov_params(), manual_cov, rtol=1e-12, atol=1e-18)
np.testing.assert_allclose(
    fit.coefficient_table["standard_error_hac"].to_numpy(), robust.bse,
    rtol=1e-12, atol=1e-14,
)
np.testing.assert_allclose(
    fit.coefficient_table.loc["const", ["t_hac", "p_hac"]].to_numpy(dtype=float),
    [robust.tvalues[0], robust.pvalues[0]],
)
np.testing.assert_allclose(
    fit.coefficient_table.loc["const", ["ci_low_hac", "ci_high_hac"]].to_numpy(dtype=float),
    robust.conf_int()[0],
)
assert robust.df_resid == 2
print("V_HAC:", manual_cov)
print(fit.coefficient_table[["standard_error_hac", "t_hac", "p_hac", "ci_low_hac", "ci_high_hac"]])
7. 金融解释
7.1 风险溢价解释不等于因果证明
因子均值为正,可以与风险补偿、投资者行为、制度约束或特定样本共同有关。因子模型刻画收益关系,单次回归不能裁决这些机制。要论证风险补偿,还要说明不利状态、边际投资者与经济机制;要论证行为性错误定价,还要说明谁产生偏差、谁受套利限制。相关性(correlation)不等于因果关系(causation)。
7.2 为什么 alpha 是相对概念
截距显著还需审视检验假设、样本选择、模型遗漏和重复尝试。统计显著性(statistical significance)不等于经济显著性(economic significance);未显著也不等于证明 alpha 精确为零。若检验了很多组合、模型和窗口,单个小 p 值尤其不足。第32章会讨论多重检验。
7.3 为什么残差不是免费午餐
残差风险有时可通过持有更多不相关资产分散,但“样本内残差均值零”来自带截距拟合,不表示事件风险可忽略。因子覆盖不足时,许多股票残差会共同暴露于流动性或行业冲击。基金若把一个模型的所有残差都当成独立噪声,就可能严重低估集中度。
8. Numerical Example
8.1 手算因子构造
以下均为教学构造月收益,不是市场观测:SV=4%、SN=3%、SG=2%,BV=2%、BN=1%、BG=0%。小盘均值为 3%,大盘均值为 1%,所以 SMB_BM=2%。价值端均值 (4%+2%)/2=3%,成长端均值 (2%+0%)/2=1%,故 HML=2%。两因子当月相同,不意味着它们的长期时间序列相同,也不能用一个月估计相关性。
8.2 手算解释收益与 alpha
构造某月现金 RF=0.2%,资产 R=2.6%,模型截距
这里截距为每月0.2%,epsilon是当月未解释变化;各项保持同月收益单位。
这个月的残差 0.8% 不是截距 0.2%;单月归因中的剩余变化与跨期平均的回归截距不能混淆。现金只从资产总收益减一次,右侧 MKT 已是超额收益,SMB/HML 已是收益差,不再减 RF。
8.3 手算共同风险
构造两个不相关因子月波动为 4%、2%,载荷 0.8、0.5,残差月波动为 1%。因子解释方差记为v_f,总方差记为v:
v_f和v均为月收益平方;总波动为平方根,约3.4986%。平方后再加总,最后开方,不能把 3.2%、1%、1% 直接加成 5.2%。
若因子相关系数为0.5,交叉协方差为
d与v_corr均为月收益平方;相关情形的月波动为
8.4 将回归算法拆成四个月的账
下面只用一个市场因子,把第6.2节矩阵算法还原成能手算的步骤。所有值是教学构造的月小数收益,没有真实公司或预测检验。表中 y 已经扣过同月现金收益:
| 构造月 | x:市场超额收益 | y:资产超额收益 |
|---|---|---|
| 1 | −0.020 | −0.013 |
| 2 | 0.000 | 0.001 |
| 3 | 0.020 | 0.017 |
| 4 | 0.040 | 0.035 |
第一步求均值:
第二步求离差:x的离差依次为−0.030、−0.010、0.010、0.030;y为−0.023、−0.009、0.007、0.025。对应乘积和为0.00069+0.00009+0.00007+0.00075=0.00160,x离差平方和为0.00090+0.00010+0.00010+0.00090=0.00200。
第三步求斜率:
第四步回到水平:
第五步逐月算拟合
最后,y中心化平方和为0.001284,残差平方和为0.000004,
9. Python Implementation
本读者版的默认运行入口
从接受I3读者包根目录,按其环境说明建立环境后运行:
.venv/bin/python run_notebook.py notebooks/ch15_factor_models.ipynb
默认种子20261015生成2010-01起120个月的五列构造因子(各列正态标准差0.025)、RF=0.001,以及RF+0.002+1.0×Mkt-RF+0.3×HML加正态标准差0.01误差的单个CONSTRUCTED资产。CAPM、FF3、FF5使用同一基础因子列,故本次构造模型严格嵌套。实际build_summary(..., constructed=True)核三个模型的ddof=1样本方差恒等式及HAC3/6/12点估计不变;输出系数CSV、摘要JSON和三张新图,写入runs/ch15_factor_models_<uuid>/。CSV显式含model和coefficient列。新图分别为月alpha及HAC区间、FF5载荷及区间、月度项的算术累加归因;图题中的资产名来自CONSTRUCTED资产。RUN_FRENCH=False使默认路径不装载French历史快照。本章第10–11节仍展示原NoDur历史图表。
运行器另在唯一runs/execution_*目录保存内核执行记录;它与Notebook打印的本章UUID方法目录用途不同。构造运行核对计算接口,不形成市场研究结果、PIT预测或扣费策略收益。第14章历史NoDur使用HAC5,第15章和项目2历史主表使用HAC6,点估计与推断设置须分别识别,不能为表面一致改写区间。本批仅核实际源代码,未执行这些Notebook或重跑历史回归。
第15章I3 Notebook第4、18格的旧Markdown仍描述官方快照的共享列差异;该描述只适用于历史French案例,不能用来说明当前共同构造列。第14、15章Notebook的英文Markdown及这两格叙述校正归BIL23;本批不改章Notebook。 下方CLI与旧制作测试按课程工作根理解;未随读者包提供的制作测试不要求补回。
历史课程工作根与原实现
9.1 输入契约先于拟合
实际数据入口为 ch15_factor_models.py,教学 Notebook 为 ch15_factor_models.ipynb。从课程目录运行 .venv/bin/python code/ch15_factor_models.py;输出 系数CSV 和 带来源哈希的摘要JSON。这些是实验输出,不能作为替代输入重新回归。
核心函数为 factor_models.py 中的 fit_monthly_factor_model()。资产输入是 Series,因子输入是 DataFrame;双方使用连续、唯一、递增的月频 PeriodIndex,月份必须完全相同。原始 French 文件以百分数发布;课程处理快照已转换成小数,不在这里再次除以100。NaN、无穷、布尔、复数、断月与秩亏都拒绝,不用补零把失败藏起来。
为什么如此严格?如果资产是四月收益,因子却是五月收益,回归仍可能给出数字,但金融问题已经被换掉。外连接后随意删缺失行又会改变研究窗口。严格失败比产生一个无法解释的 beta 更有价值。月份是收益区间标签,不是声称数据在该月第一秒已经公开。
9.2 为什么要看返回值而非只看 summary
返回对象保存系数表、拟合超额收益、残差、R²、调整 R²、样本量、条件数和 HAC 滞后数。系数表中的 estimate 是月截距或无量纲载荷,standard_error_hac 是对应参数标准误,ci_low_hac/ci_high_hac 是95%近似区间;截距区间也按月小数解释。
条件数(condition number)帮助发现设计矩阵接近共线性,但含常数与小数收益列时它还受单位缩放影响,不能设一个任意阈值就判断所有模型有效/无效。应联合观察载荷区间、因子相关、窗口稳定性和经济解释。
实际数据回归使用冻结快照、2010-01 至2019-12月度区间;这是事后描述性实验,没有 signal timestamp 或 trade timestamp,也没有订单。return interval 是每一个发布的月度组合收益区间。若未来将回归用于交易,必须另建训练截止、数据可用时钟、信号时钟、成交时钟与随后收益区间。
10. Visualization
下列三张图由同一冻结数据入口实际生成,原始数值与第11节相同。按以下顺序阅读:
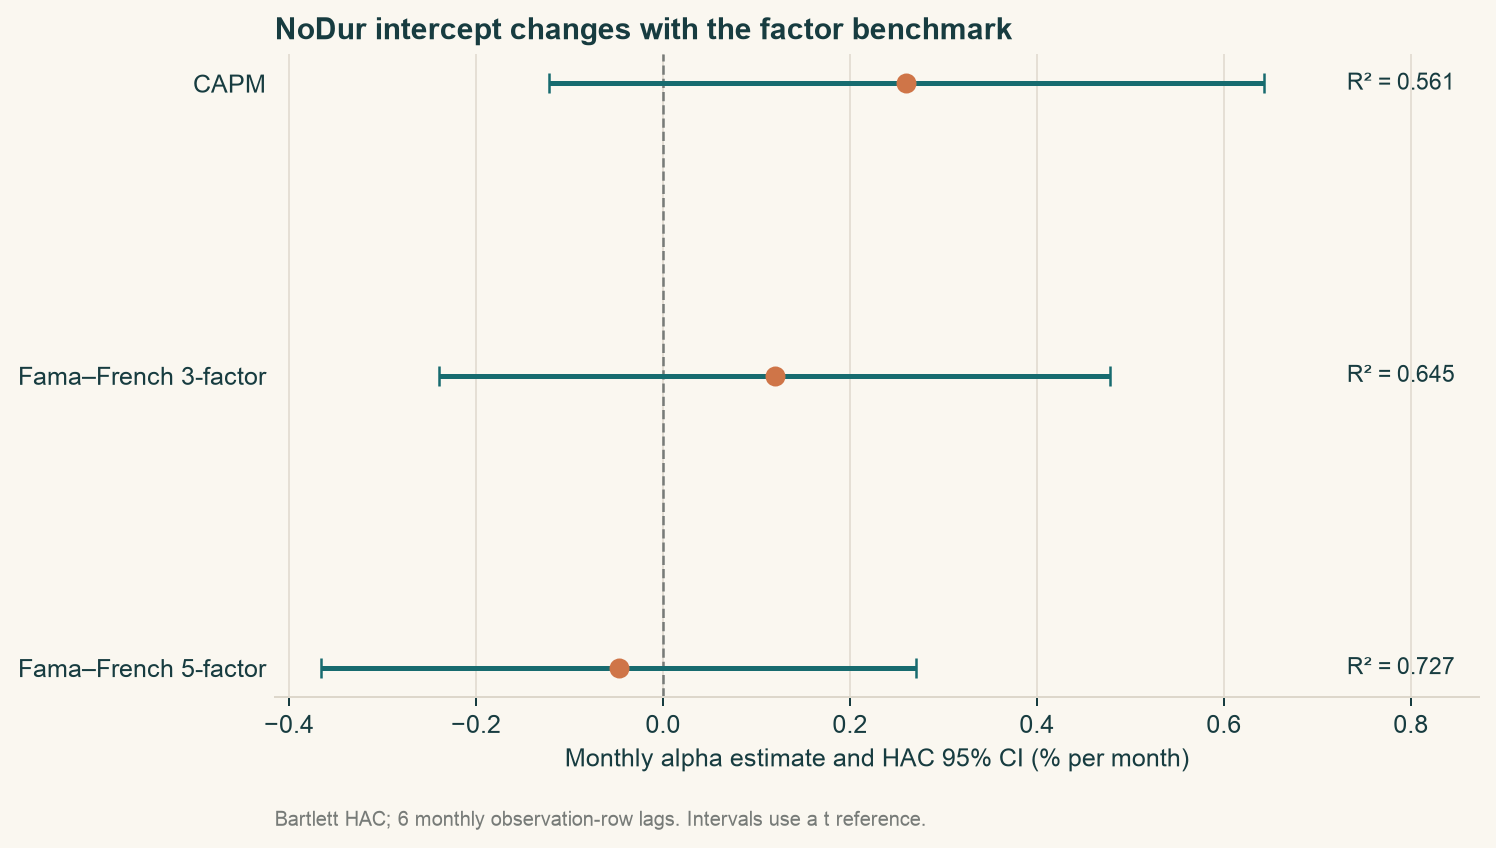
- 模型截距及95% HAC区间:横轴为月alpha估计及95% HAC区间(百分点/月),纵轴为CAPM、FF3、FF5;观察估计如何随基准改变、区间是否覆盖零,不能只盯点估计的正负。
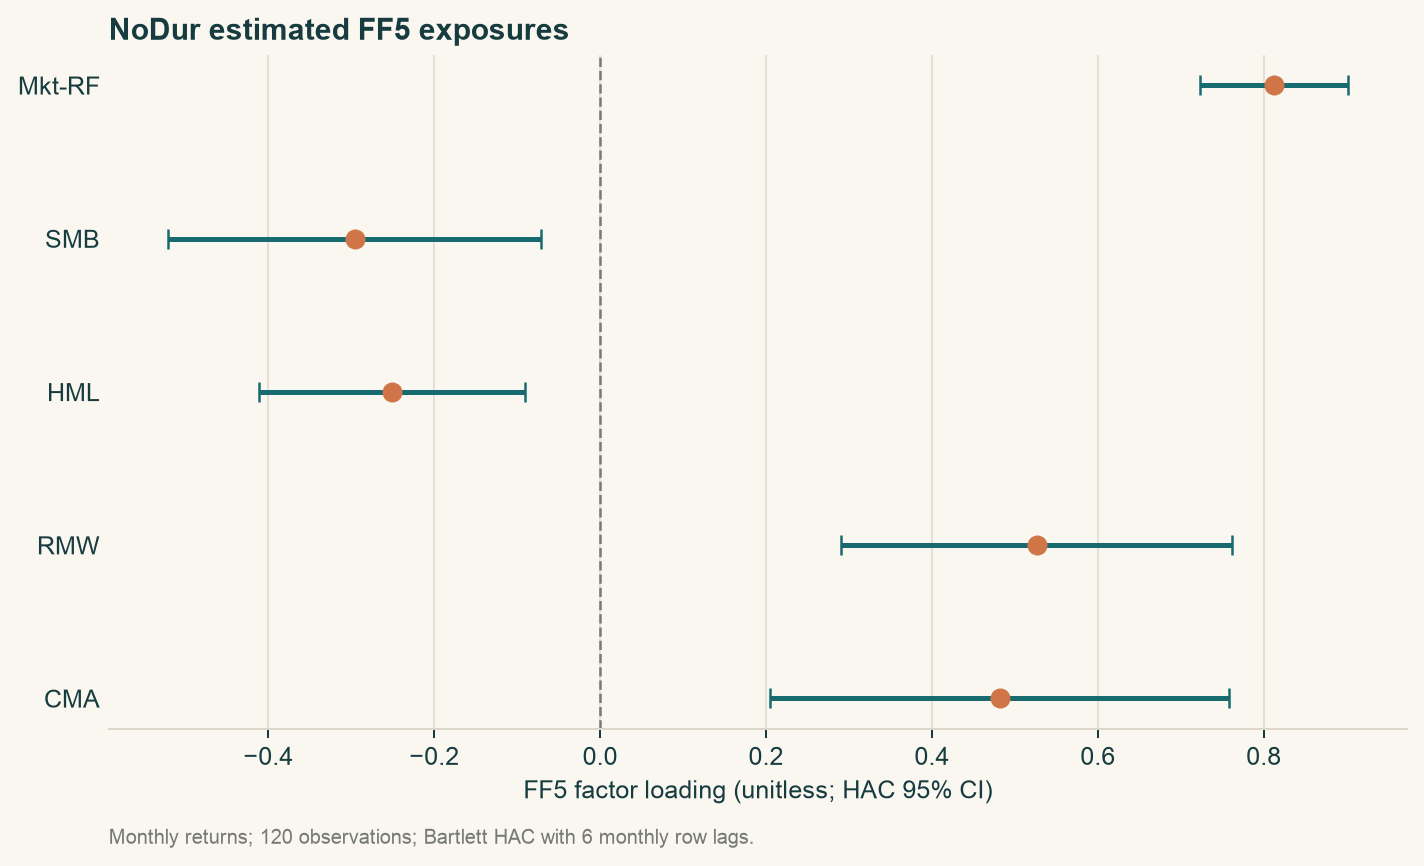
- FF5因子载荷及区间:横轴为无量纲载荷及HAC区间,纵轴为因子名称;观察市场、规模、价值、盈利、投资各自方向与不确定性。载荷不能读成持仓比例。
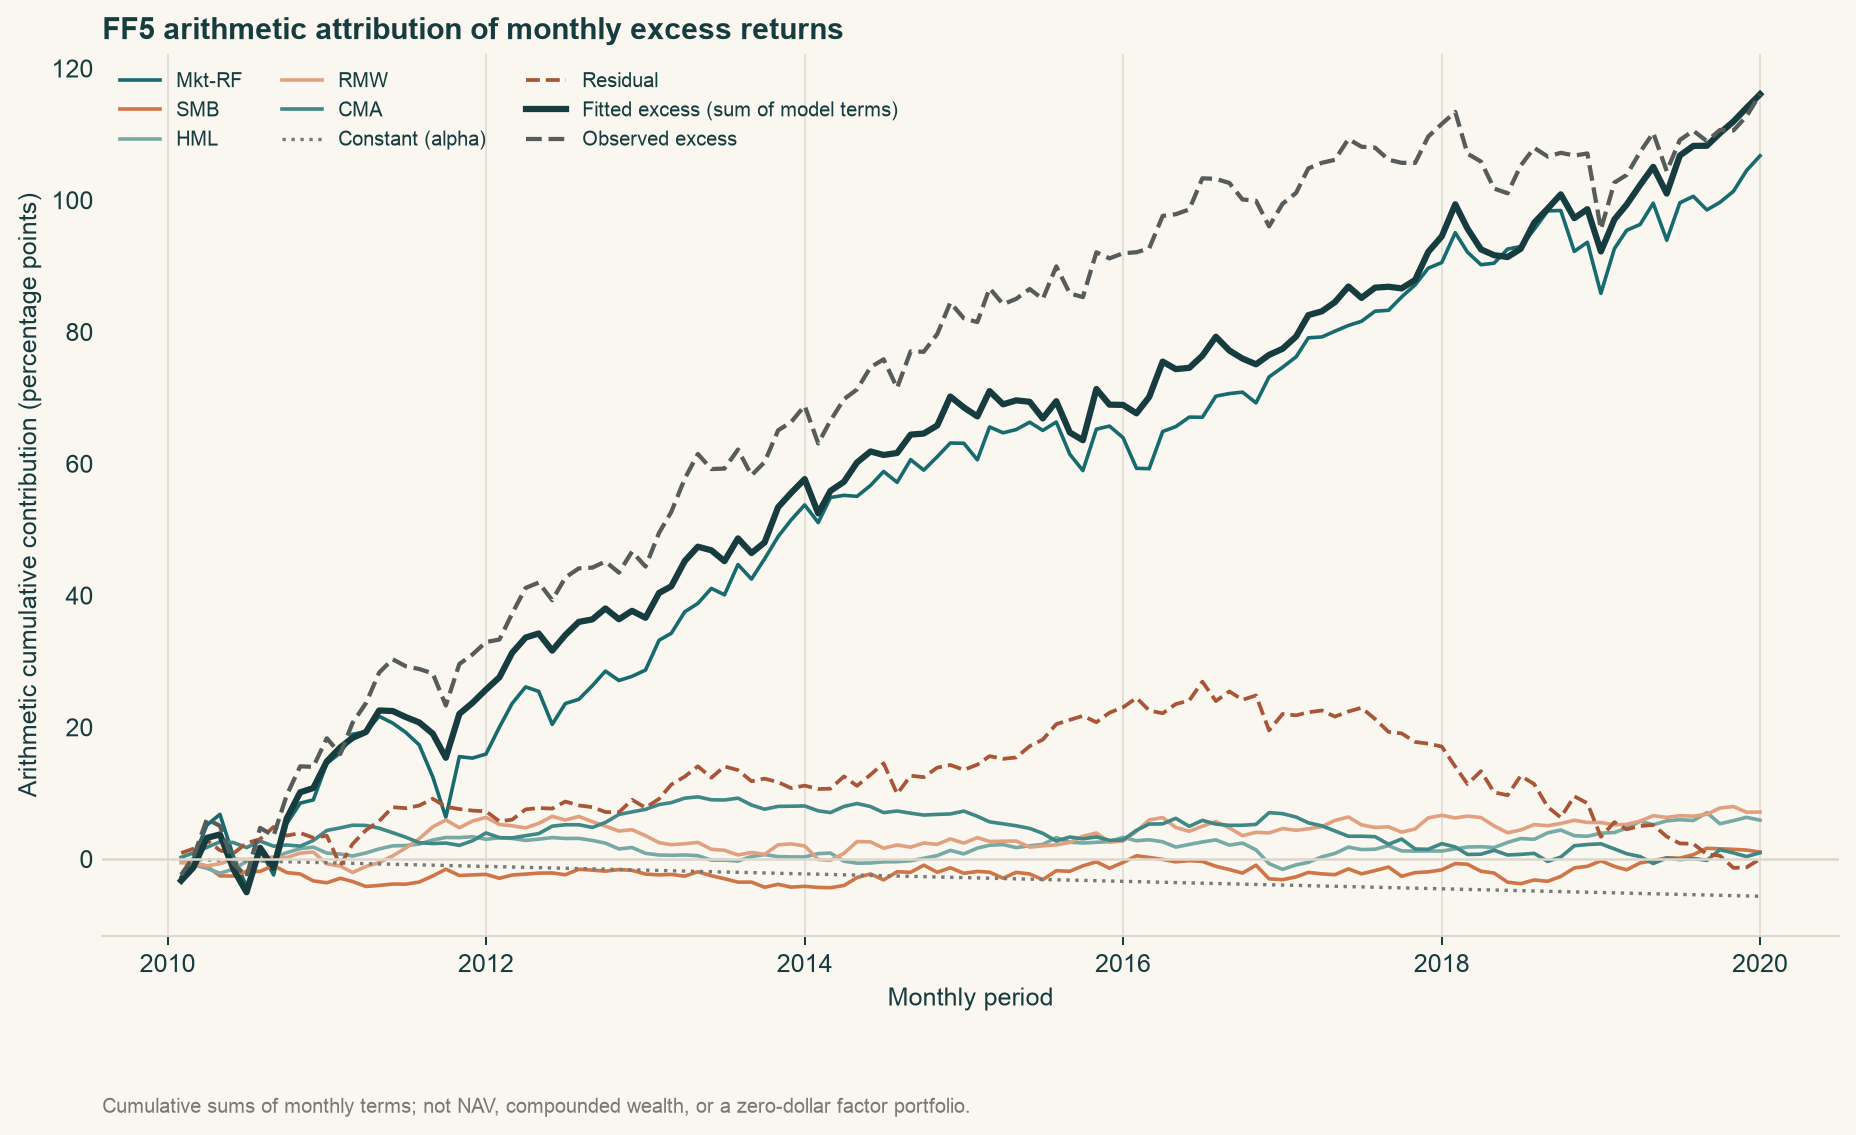
- 因子解释贡献的算术累加:横轴为样本月份,纵轴为逐月
beta_k*f_k累加的收益百分点,并同时展示alpha累计及残差累计。它是线性归因账,不是可投资净值或复利财富。各分量在每个月相加等于超额收益,跨月相加保持算术恒等式,不能替代第11章的财富乘积。
尤其要避免把零净投资的多空收益差直接当成一个初值为1的基金收益去画“财富”。如果需要因子策略净值,须另定义多空规模、抵押资金、融资、再平衡及成本。这里没有这些账本,图形只能承载与输入单位相符的归因。
11. Real Market Example
11.1 样本、来源与证据范围
实际输入为 Kenneth French 发布的非耐用品行业组合(Nondurables, NoDur)月总收益,以及美国 FF3、FF5 月因子序列。快照下载日为2026-10-05,原始文件声明 CRSP 202608;主窗口固定2010-01至2019-12,共120个月,币种收益口径为USD。行业组合不是一只可直接买入的基金,本章也不重建成员、价格或历史股票池。
处理后的行业、FF3、FF5三个文件 SHA-256 分别为:
3b097d810c295d64eedfa1ece7067ff2a0707f5ca90e33935df9949251f70950c19770a19a0ac47ad1c29074f57234570aeaa9725212cb4fa8146a2846c52814833bd925b49651428781c789c13a6ac7454d4676449e6d119782050046a57eea
行业清单与因子清单记录来源、原始和处理文件及哈希。哈希固定当前输入,不能证明这些修订值在2010年的同一个月已经可得。当前快照不是历史点时数据(Point-in-Time Data, PIT)。官方 RF 序列从2024-06起换用另一现金代理来源,主窗口结束于2019,不跨该切换,但长期扩展实验必须记录这一方法边界。
11.2 实测结果怎样解释
第14章的同样本CAPM使用5个月HAC滞后;本章三个模型统一使用6个月,并另报告3/6/12阶敏感性。因此跨章点估计一致,区间和p值不可不加说明直接比较。这些是教学实验明确采用的设置,不声称在观察数据前完成正式预注册。
以下来自实际冻结数据,HAC采用6个月滞后、Bartlett核、有限样本修正及 t 参考分布。不是教学构造数值。
| 模型 | 月 alpha(%) | alpha 95%区间(%) | alpha p 值 | R² | 调整 R² |
|---|---|---|---|---|---|
| CAPM | 0.26034 | [−0.12227, 0.64295] | 0.1804 | 0.56080 | 0.55708 |
| FF3 | 0.11947 | [−0.23925, 0.47818] | 0.5108 | 0.64496 | 0.63578 |
| FF5 | −0.04716 | [−0.36528, 0.27095] | 0.7695 | 0.72651 | 0.71451 |
三种截距区间都覆盖零,在所设近似推断下未拒绝零截距;不能把它说成“已证明该行业没有alpha”。FF5的残差样本方差较低,表示这组序列在该窗口解释了更多变化,不能推出以后预测更好。
FF5的市场、SMB、HML、RMW、CMA载荷约为0.81212、−0.29609、−0.25075、0.52627、0.48148。控制其余因子后,NoDur对盈利和保守投资因子有正历史载荷,对规模和价值收益差有负历史载荷;这不是说行业里每家公司都属于相应分组。它也不证明盈利或投资因子因果驱动了行业收益。
11.3 一个不能略过的实际数据差异
在同一120个月窗口,FF3和FF5的同名 Mkt-RF 最大绝对差为0.0003,即0.03个百分点;SMB最大差为0.0137,即1.37个百分点;HML与RF一致。2018-05的市场序列在两份原始文件中分别为2.66%与2.63%,两者文件头都标为CRSP 202608。我们核验了原始值,但没有确定市场差异的上游原因,不猜测为舍入、修订或发布错误。
FF5的SMB构造本就与FF3不同;市场序列也存在上述实际差异,因此本实验的两个模型不是严格保持相同旧列、只新增两列的嵌套模型(nested models)。不能直接做“仅新增RMW/CMA”的嵌套F检验,也不能把R²上升全部归给这两个新因子。若要隔离新增列的作用,须固定同一市场、SMB、HML序列,再加RMW/CMA;那是明确标记的自定义混合模型,不应称为官方FF5。
11.4 风险分解与不确定性
三模型的目标样本方差均为0.0010394864(月收益平方)。FF5拟合样本方差为0.0007551957,残差样本方差为0.0002842907,两者和与目标相符。这里只验证同分母的 OLS 样本恒等式,不证明残差未来独立。
HAC滞后3、6、12下,FF5截距始终为−0.0004716374,小数/月;其标准误约0.0015052、0.0016058、0.0018439。改变协方差估计不会改变同一 OLS 点估计,但会改变区间和 p 值。点估计稳定与未来收益稳定是两种不同命题。
12. Common Mistakes
12.1 再扣一次 RF:数据看似合理,定义已经错了
错误做法把 Mkt-RF 当成市场总收益,再扣RF。下面用一个月构造案例检验:
import numpy as np
rf, asset, market_excess, beta = 0.002, 0.026, 0.020, 0.8
correct_left = asset-rf
wrong_right = beta*(market_excess-rf)
correct_right = beta*market_excess
assert np.isclose(correct_left, 0.024)
assert np.isclose(correct_right-wrong_right, 0.0016)
print(f"错误市场贡献={wrong_right:.2%};正确={correct_right:.2%}")
错误贡献为1.44%,正确为1.60%,差0.16个百分点。SMB/HML等多空收益差也不再减RF。若现金代理跨月变化,这种错误会改变整个回归关系,而不只是简单改变截距。
12.2 把载荷当权重,或把因子相关当作可忽略
将0.8、0.3、0.5强行归一到总和1,会改变拟合的响应系数;载荷来自收益协动,不是预算权重。忽略因子相关则会错算风险,下面重现第8节差异:
import numpy as np
beta = np.array([0.8, 0.5])
vol = np.array([0.04, 0.02])
independent = np.diag(vol**2)
correlated = independent.copy()
correlated[0, 1] = correlated[1, 0] = 0.5*vol[0]*vol[1]
wrong_risk = np.sqrt(beta @ independent @ beta + 0.01**2)
correct_risk = np.sqrt(beta @ correlated @ beta + 0.01**2)
assert np.isclose(wrong_risk, np.sqrt(0.001224))
assert np.isclose(correct_risk, np.sqrt(0.001544))
print(f"忽略相关={wrong_risk:.4%};包含相关={correct_risk:.4%}")
这个构造中忽略相关低估月波动约0.43个百分点;其他载荷方向与负相关情形也可能反过来。不能先决定“相关一定增加风险”再套公式。
12.3 当前快照误作预测,训练样本被未来扩展
全窗口回归可以做事后归因;若以2014年底估计值作为2015年初信号,就只能使用当时可读的训练数据。错误代码 train = sample.loc[:"2019-12"] 用了未来;正确时间截断为 sample.loc[:"2014-12"],并另核验所有输入的发布和入库时钟。仅把索引切短仍不能让当前修订快照变成PIT。
这些切片本身可运行,但本章未构造完整策略,不能虚报错误版和正确版的 Sharpe 差。能确证的结果差异是错误训练集120月、正确历史区间60月;未来信息是否改变系数必须实际拟合后再报告。数据可用性、模型拟合和可交易回测分别有自己的证据要求。
12.4 月截距不是可直接兑现的年度收益
12×月alpha只是线性年度尺度表示;
13. Quant Research Application
13.1 一个风险解释实验怎样闭环
先写经济假设:“组合历史超额收益可能来自已知规模、价值或盈利/投资暴露。”随后固定资产定义、窗口、因子版本、币种、月区间与缺失规则;核验输入后比较模型。报告要同时给系数、区间、拟合误差、因子相关与方法差异,不只展示最有利的一行。
下一步不是机械挑 R²最高模型,而是问:经济解释是否合理?载荷在不同窗口是否稳定?残差是否仍有共同结构?新的因子是否实际减少样本外预测误差或改善风险估计?若只是事后归因,就诚实停在这个结论。
13.2 若要发展成交易研究,增加什么
假设“残差均值可能预测未来收益”与“已发生收益可被线性解释”不同。必须定义只用训练窗口估计的载荷,随后预测的目标与持有期,检验基准、换手、费用、做空可行性和行业暴露。经济假设应给出反证:若残差在未来消失、暴露估计不稳定、或毛收益小于成本,就不能支持该策略。
训练截至t,信号在所有输入可读后的s生成,成交e晚于s,评估收益从e之后开始。不能使用t+1已发生的因子收益解释t+1资产收益后,把这称作事前预测。滚动(rolling)或扩展(expanding)窗口只解决拟合范围,完整PIT与防泄漏规则仍须另建;第29–31章会实现这些契约。
13.3 财报特征到因子暴露的接力
第12–13章清洗财报并构造同口径特征;第15章识别共同收益暴露;第23–28章检验特征与未来收益关系;第20–21章将预期收益及风险变成权重;第35章扣成本。任一步失败,都不能靠换更复杂的因子模型补救。更多因子不自动等于更好模型,模型复杂度应由研究问题和有边界的证据决定。
14. Chapter Summary
因子模型先规定比较坐标,再用历史收益估计暴露,最后检查未解释部分与风险。财报特征告诉我们公司属性,因子收益告诉我们分组组合表现,beta告诉我们资产对这些收益的条件响应。alpha必须与模型、样本和现金代理一起陈述。
同样本OLS正交支持风险的代数分解;未来风险分解需要额外假设。HAC改善特定条件下的统计推断,交易成本与时钟逻辑决定可实现性。真正可交付的结论应明确解释了什么、没有证明什么,以及下一项实验怎样反驳当前假设。
15. Exercises
15-E01 为什么账面市值比特征、HML收益和某股票的HML载荷不是同一个量?分别说明单位与计算时钟。
15-E02 第8.1节六个构造组合保持不变,若只将SG从2%改为−1%,重算SMB_BM与HML。为什么两者都变?
15-E03 对第8.2节,同月RF为0.2%、资产总收益2.6%。求超额收益、因子解释、含截距拟合及残差,并解释单月残差不等于alpha。
15-E04 用第6.1节推导,设alpha=0、beta=0.8、gamma=0.5,E[x]=0.5%、E[z]=0.3%,Cov(x,z)/Var(x)=0.4。只回归x时斜率与截距各是多少?
15-E05 两个因子不相关时,beta=(0.8,0.5)、波动=(4%,2%)、残差波动1%。重算总方差;若相关系数变为−0.5会怎样?
15-E06 为什么OLS样本残差方差若除以T−K−1,不能不调整就加入使用T−1的样本风险恒等式?这是否证明残差相互独立?
15-E07 当前NoDur的FF5月alpha约−0.04716%,95%区间约[−0.36528%,0.27095%]。能否说“已证明alpha为零”?能否说“这个行业未来必输”?
15-E08 为什么本章官方FF3与FF5比较不能直接使用只新增两列的嵌套F检验?怎样设计一个能隔离新增因子的实验,并正确命名?
15-E09(交叉协方差) 一个外部固定模型取
15-E10(变动载荷) 重算第6.5节两状态的平均因子贡献及
16. Programming Exercises
15-P01 用第9.1节构造输入拟合FF3;故意将因子月份整体向后移动一月,断言接口拒绝,而不是默默内连接后拟合。再将一个因子变成另一个的两倍,断言秩亏被拒绝。
15-P02 在同一个有随机残差的构造样本上分别用HAC滞后3、6、12,断言OLS系数不变;给出截距标准误,并核验拟合与残差按ddof=1的样本方差之和等于超额收益方差。
15-P03 用冻结实际样本复算CAPM、FF3、FF5,报告月alpha及其区间、SMB载荷和R²;核对FF3/FF5同名序列差异。不要给出未执行的净alpha或逐股复制结果。
17. Challenge Problems
15-C01(模型与经济意义) 某研究者尝试100个资产窗口,挑出FF5截距p<0.05的一项,并声称找到了可交易净alpha。列出统计、数据、经济与执行四类反证;设计后续研究,但不能用更多同样本模型搜索替代样本外检验。
15-C02(组合风险,先修第5、9章) 两资产对同一因子的载荷为1与−0.5,权重均为0.5。因子月波动4%,各残差月波动2%,先假设残差不相关,再令残差相关系数0.8。分别计算组合总波动;解释为什么市场暴露低也可能有集中风险。
18. Solutions / Solution Hints
18.1 概念与手算题
15-E01 账面市值比是某一已知财报版本的普通股账面权益除以同口径市值,无量纲;必须分别记录财报公开/入库与市场时钟。HML是规定高/低账面市值比组合的同月收益差,单位为小数/月,整月完成并发布后才知道该月结果。载荷h是指定训练样本中、控制其他因子后的线性响应系数,无量纲,估计只能使用截至训练截止时可读的数据。三者分别是公司属性、已实现组合收益和收益协动参数。
15-E02 新小盘均值为
15-E03 逐步计算:
其中c为因子解释贡献,所有量都是本月收益百分比。alpha是跨样本估计的条件均值偏移,残差是单月偏离该拟合的量,不能互换。
15-E04 遗漏因子后斜率为0.8+0.5×0.4=1.0;截距为0+0.5×(0.003−0.4×0.005)=0.0005,即每月0.05%。真实构造alpha为零,单因子仍出现正截距,来源是遗漏z的平均部分而非新增可交易能力。
15-E05 不相关时共同方差0.001124,残差方差0.0001,总方差0.001224,波动3.4986%。相关−0.5使交叉项变为−0.00032,总方差0.000904,波动约3.0067%。是否降低风险取决于相关符号与载荷符号的乘积;协方差矩阵也必须保持有效,不能随意设不可能的相关组合。
15-E06 设RSS为残差平方和。OLS首列含截距,残差均值为零,样本残差方差为RSS/(T−1);噪声方差估计RSS/(T−K−1)通常更大。这两个量的估计目标与分母不同,混加将破坏同样本方差恒等式。样本内正交只说明内积为零,不证明随机变量独立、残差跨资产独立或未来继续正交。
15-E07 不能证明alpha精确为零。该95%近似区间同时容纳一定负值与正值,在当前统计假设下未拒绝零截距。未来输赢还涉及新数据、风险状态、成本和可实现投资组合;本实验是发布行业组合的历史归因,不能推出未来必输。未显著与已证无效不是同义词。
15-E08 官方FF3/FF5的SMB定义不同,当前同名市场列也存在实际数值差异。若旧列不同,就不是仅多两列的嵌套回归。隔离实验固定同一份MKT/SMB/HML及同一RF、同一资产与月份,再加同版本RMW/CMA;应命名“固定FF3基准的自定义扩展模型”。检验还须满足相应协方差与误差假设,普通同方差F检验不能自动替代稳健检验;这个实验也不证明新模型更能预测未来。
15-E09
15-E10
18.2 编程题完整参考
15-P01 下例完全独立,构造seed=1501;对错月和精确共线输入均要求拒绝。
from pathlib import Path
import sys
sys.path.insert(0, str(Path.cwd() / "src"))
import numpy as np
import pandas as pd
from quant_course.factor_models import fit_monthly_factor_model

rng = np.random.default_rng(1501)
index = pd.period_range("2000-01", periods=120, freq="M")
f = pd.DataFrame({"Mkt-RF": rng.normal(0.005, 0.04, 120),
                  "SMB": rng.normal(0.002, 0.02, 120),
                  "HML": rng.normal(0.003, 0.02, 120),
                  "RF": np.full(120, 0.001)}, index=index)
y = f["RF"] + 0.002 + 0.8*f["Mkt-RF"] + 0.3*f["SMB"] + 0.5*f["HML"]
fit = fit_monthly_factor_model(y, f, ("Mkt-RF", "SMB", "HML"))
assert np.allclose(fit.coefficient_table["estimate"], [0.002, 0.8, 0.3, 0.5])
shifted = f.copy()
shifted.index = shifted.index + 1
rank_deficient = f.copy()
rank_deficient["SMB"] = 2*rank_deficient["Mkt-RF"]
for invalid in (shifted, rank_deficient):
    try:
        fit_monthly_factor_model(y, invalid, ("Mkt-RF", "SMB", "HML"))
    except ValueError:
        pass
    else:
        raise AssertionError("wrong months or rank deficiency must be rejected")
print("both invalid experiments rejected")
15-P02 下例加入非零随机误差,让协方差选择对区间的影响具有意义。这里随机噪声只用于接口演示,不声称模拟了真实金融状态。
from pathlib import Path
import sys
sys.path.insert(0, str(Path.cwd() / "src"))
import numpy as np
import pandas as pd
from quant_course.factor_models import fit_monthly_factor_model

rng = np.random.default_rng(1502)
index = pd.period_range("2000-01", periods=120, freq="M")
f = pd.DataFrame({"Mkt-RF": rng.normal(0.005, 0.04, 120),
                  "SMB": rng.normal(0.002, 0.02, 120),
                  "RF": np.full(120, 0.001)}, index=index)
asset = f["RF"] + 0.002 + 0.8*f["Mkt-RF"] + 0.3*f["SMB"] + rng.normal(0, 0.01, 120)
fits = [fit_monthly_factor_model(asset, f, ("Mkt-RF", "SMB"), hac_maxlags=lag)
        for lag in (3, 6, 12)]
for model in fits:
    assert np.array_equal(model.coefficient_table["estimate"], fits[0].coefficient_table["estimate"])
    observed = asset-f["RF"]
    assert np.isclose(observed.var(ddof=1),
                      model.fitted_excess.var(ddof=1)+model.residuals.var(ddof=1))
    print(model.hac_maxlags, model.coefficient_table.loc["const", "standard_error_hac"])
15-P03 以下从清单加载冻结输入,不依赖已有结果JSON作为计算来源。代码以当下快照复算,不能赋予它历史PIT资格。
from pathlib import Path
import sys
import json
sys.path.insert(0, str(Path.cwd() / "src"))
import numpy as np
from quant_course.market_data import load_monthly_snapshot
from quant_course.factor_models import fit_monthly_factor_model

root = Path.cwd()
a = json.loads((root / "data/manifests/french_industries_2026-10-05.json").read_text())
m = json.loads((root / "data/manifests/french_factors_2026-10-05.json").read_text())["datasets"]
asset = load_monthly_snapshot(root/a["processed_path"], a["processed_sha256"], ["NoDur"])
asset = asset.loc["2010-01":"2019-12", "NoDur"]
columns = {"ff3": ("Mkt-RF", "SMB", "HML"),
           "ff5": ("Mkt-RF", "SMB", "HML", "RMW", "CMA")}
frames = {name: load_monthly_snapshot(root/m[name]["processed_path"],
                                     m[name]["processed_sha256"], [*cols, "RF"])
                   .loc["2010-01":"2019-12"]
          for name, cols in columns.items()}
expected = {"capm": (0.002603392167217396, 0.5607993620708411),
            "ff3": (0.001194674972166453, 0.6449619292529103),
            "ff5": (-0.0004716374176230468, 0.7265084935780675)}
for name in expected:
    frame = frames["ff5" if name == "ff5" else "ff3"]
    cols = ("Mkt-RF",) if name == "capm" else columns[name]
    fit = fit_monthly_factor_model(asset, frame, cols, hac_maxlags=6)
    assert fit.nobs == 120
    assert np.isclose(fit.coefficient_table.loc["const", "estimate"], expected[name][0])
    assert np.isclose(fit.r_squared, expected[name][1])
    print(name, fit.coefficient_table, "R2=", fit.r_squared)
for col, difference in {"Mkt-RF": 0.0003, "SMB": 0.0137, "HML": 0.0, "RF": 0.0}.items():
    measured = (frames["ff3"][col]-frames["ff5"][col]).abs().max()
    assert np.isclose(measured, difference)
    print(col, measured)
所得月alpha、区间和R²见第11节;SMB载荷FF3约−0.42424、FF5约−0.29609。它们既非同一SMB列,也控制不同其他因子,不能只凭载荷差就解释经济机制。成本后绩效不属于本实验输出。
18.3 挑战题参考论证
15-C01 统计反证包括100次挑选造成多重检验,以及p值对误差依赖、HAC带宽和模型误设敏感;数据反证包括当前修订财报、幸存股票池、收益/因子错月或不可读输入;经济反证包括遗漏风险、集中行业或无法在不利状态承担的流动性;执行反证包括毛收益小于费用、借券不稳定及容量限制。后续应冻结假设、数据口径、训练与验证窗口,保留未经搜索的未来区间,用简单基准和已定稳健性规则比较,并保留失败结果。不能把所选同样本再次细分、择优后称为独立样本外。
评分10分:四类反证各1分;明确保留验证区间与时钟2分;说明多重搜索与检验假设2分;成本/容量和负结果规则2分。开放题可使用不同机制,但必须可证伪。
15-C02 组合因子载荷为0.5×1+0.5×(−0.5)=0.25,共同方差0.25²×0.04²=0.0001。不相关残差的组合方差为0.5²×0.02²+0.5²×0.02²=0.0002,总方差0.0003,波动1.7321%。残差相关0.8时,残差协方差0.8×0.02²=0.00032,新增组合交叉项2×0.5×0.5×0.00032=0.00016,总方差0.00046,波动2.1448%。即使市场载荷较小,残差共同冲击仍会增加风险。
评分10分:组合载荷2分;两个残差方差计算各2分;总方差与波动2分;低beta不代表低集中度的解释2分。
19. Further Reading
先读French官方构造页并亲手核验列名和月区间,再读Fama–French原文已核验的Introduction及方法相关部分。读论文时把问题拆成三个层次:如何构造因子、如何检验收益关系、是否主张该关系是一套资产定价机制;不能把其中任一层的成功替代另外两层。
1993论文同时研究股票与债券共同风险,其中“五个风险因子”的表述不是2015年的股票FF5。2015论文讨论的HML冗余带有原文美国1963–2013样本和模型条件,不能提升为“价值因子永远没用”。本章未以原文历史表格数字作为当前样本的结果。1993原刊PDF教学镜像,2015原刊PDF教学镜像
深入风险模型可沿经典组合管理教材学习因子协方差与残差协方差估计;这些教材在课程书目中作为体系参考,未获得全文的章节不能假装逐页引用。第18–21章将继续讨论波动、估计误差与组合风险,第23–28章转向特征与预测研究。
20. References
- Fama, E. F., & French, K. R. (1993). Common risk factors in the returns on stocks and bonds. Journal of Financial Economics, 33, 3–56. 本章使用已读取的引言与部分方法文字,不转录原刊图表。
- Fama, E. F., & French, K. R. (2015). A five-factor asset pricing model. Journal of Financial Economics, 116, 1–22. 本章使用已读取的引言与部分冗余讨论,不声称已逐式核验全篇。
- Kenneth R. French Data Library:三因子,五因子。方法页与快照版本分开核验。
- statsmodels:稳健协方差 API。软件参数支持可复算性,不替代统计假设。
完整来源读取边界见 source_notes.md。本轮修订前版本的正文、代码、Notebook、图和同章答案接受范围见 历史根验收记录;C7新增教学内容待原主独立验收。